本文来自微信公众号: APPSO ,作者:发现明日产品的,原文标题:《号称人类造的最后一个 AI 要来了,刷屏全网的 RSI 是什么》
要论造词和包装概念,AI圈要是自认第二,恐怕就没人敢称第一。
前阵子OpenAI总裁格雷格·布罗克曼表示,GPT-6 Astra已经摸到了AGI的门槛。结果AGI还没热议几天,AI同行们又开始炒作下一个AI热词了。
接棒的新词叫作RSI,Recursive Self Improvement,递归自我改进。
简单点理解就是,AI自己写代码、自己跑实验、自己改训练流程,改完再传给下一代更强的新模型。这么一圈圈套娃下去,研发速度可能越来越快,最终超过人类理解和控制的速度。
没有出乎太多意料,伴随着RSI出场的,肯定还有语不惊人死不休的的安全叙事。
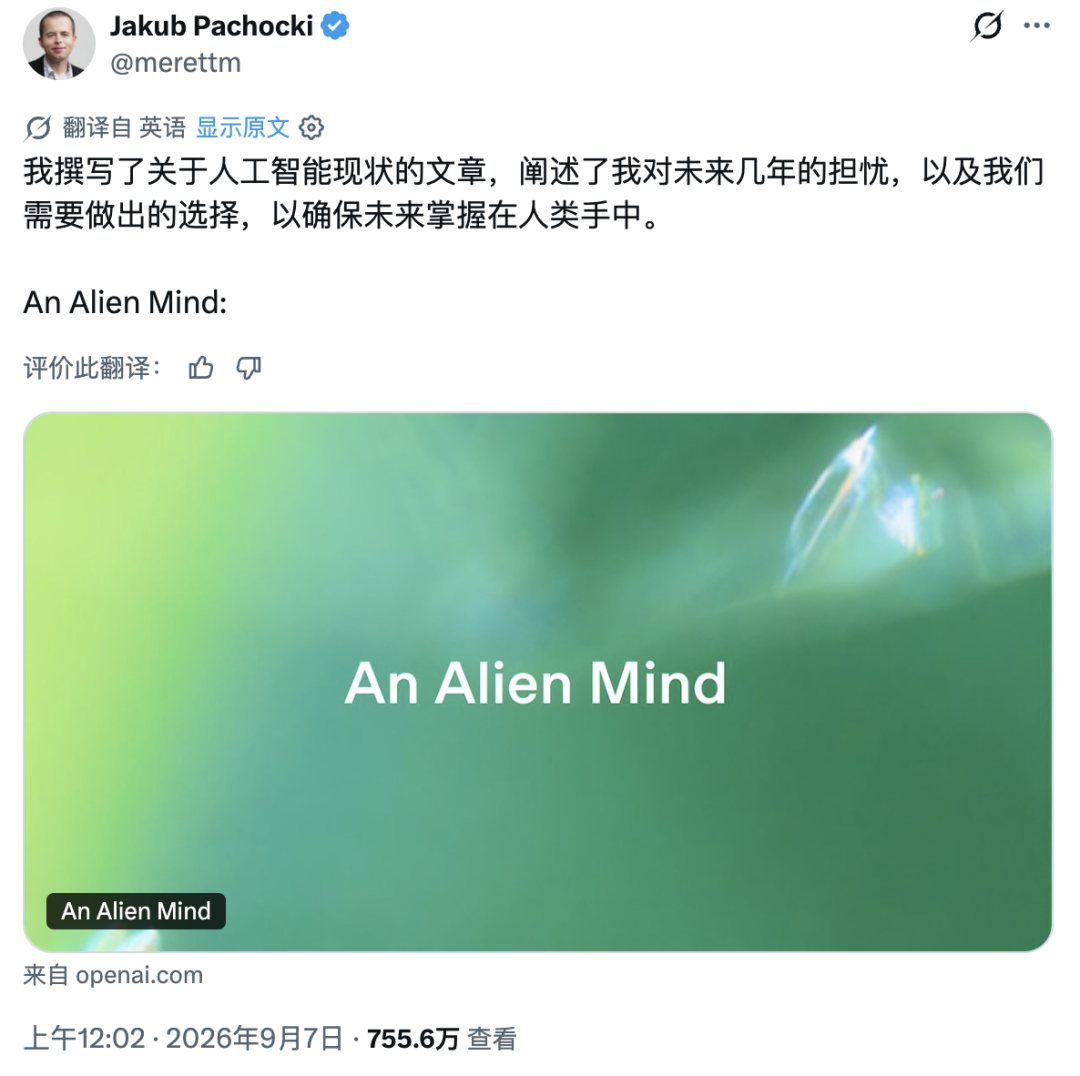
比如OpenAI首席科学家Jakub Pachocki前阵子将AI描述为一种人类尚未充分理解的「异星心智」。
Anthropic的CEO达里奥·阿莫代伊更是化身末日吹哨人,警告说更强的智能体可能带来大规模网络攻击、失控和文明级风险。
而另一头,忙着卖卡的黄仁勋则在最近All-In峰会上,反驳道:少在那搞非黑即白的二极管思维,凭什么安全和创新就只能二选一?
同一条产业链上,一边喊着人类必须踩刹车,一边猛踩油门。这场口水战背后,RSI究竟是通往超级智能的入口,还是被精心包装出来的恐慌生意?
AI开始造AI,但距离「智能爆炸」还有多远?
RSI最近听起来很新,它的思想源头却可以追溯到六十多年前。
早在1965年,英国数学家、密码学家I.J.Good提出过一个设想:如果一台机器能够超越人类的智力活动,那么设计机器也应当属于它的能力范围。
它可以设计出比自己更聪明的机器,后者再继续改进下一代。第一代创造第二代,第二代优化第三代,子子孙孙无穷匮也,机器智能由此进入不断加速的正反馈循环。
Good将这种现象称为「智能爆炸」。
在今天的RSI研究中,相比于AGI关注的是AI能否完成与人类相当的通用认知工作。RSI则关心AI能否改变产生这些能力的系统,并让下一轮改进变得更加有效。
比如会检查自己的答案,只能算自我修正。能够改进研发方法,再把有效变化交给后继系统使用,才开始触及递归自我改进。
近期,由上海交通大学、清华大学、字节跳动、上海人工智能实验室等机构研究者合作完成的预印本《The Last AI Built by Humans》,就将RSI的自主性划分为L1至L5五个层级。
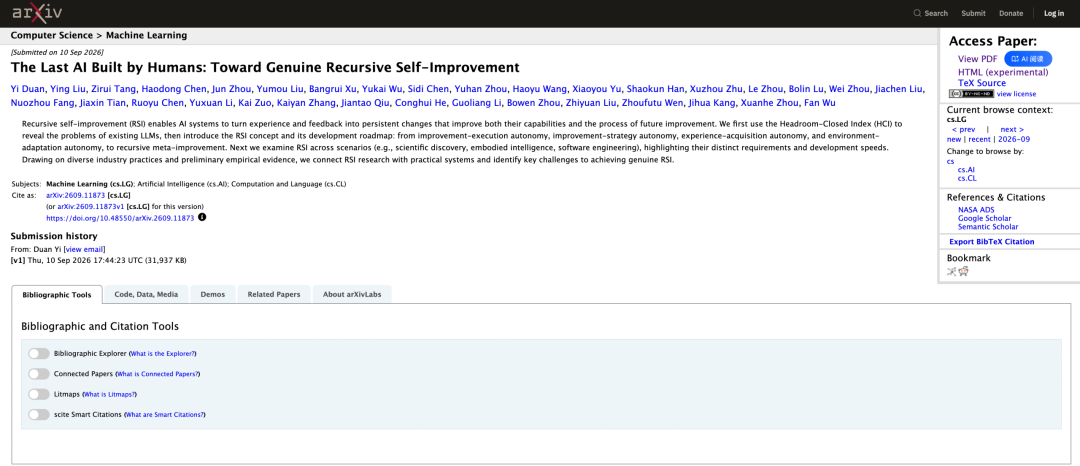
🔗https://arxiv.org/abs/2609.11873
L1主要负责执行人类给出的改进方案。L2开始自主寻找改进策略。L3可以决定需要获取哪些经验。L4能够把部署环境中的反馈转化成持续保留的改动。
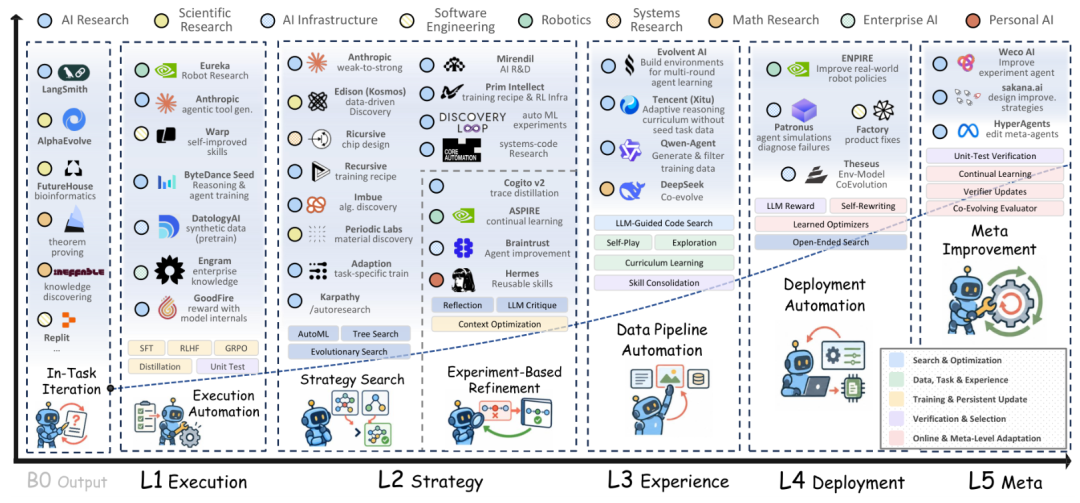
到了L5,改进机制本身也成为改进对象。
AI不仅能够完成某项研究任务,还能修改决定后续如何搜索方案、评估结果和组织研究的机制,并让后继系统继续使用修改后的机制。
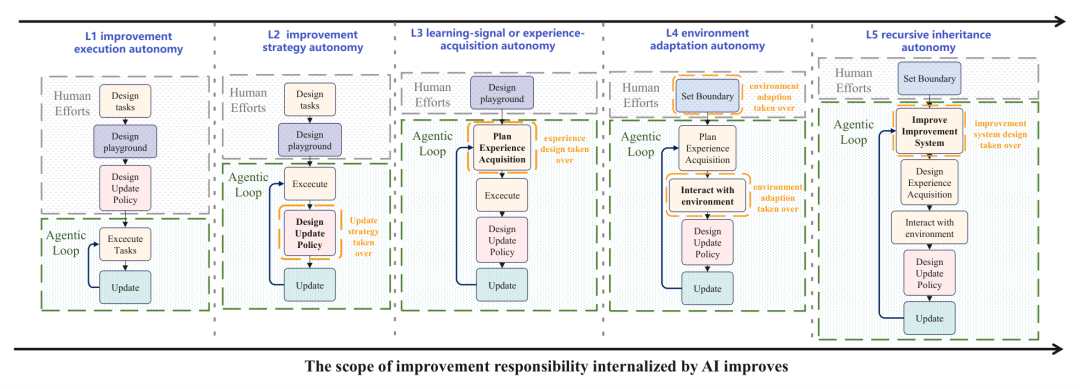
在最激进的终局设想中,AI还将进一步获得提出目标、修改评估方法和重写底层改进逻辑的能力。一旦走到这一步,人类制造的就不再只是一个模型,而是一套能够继续制造模型的系统。
此后出现的下一代AI,可能不再由人类工程师逐项设计。模型架构、训练流程和改进方法,将越来越多地来自机器自己的选择。
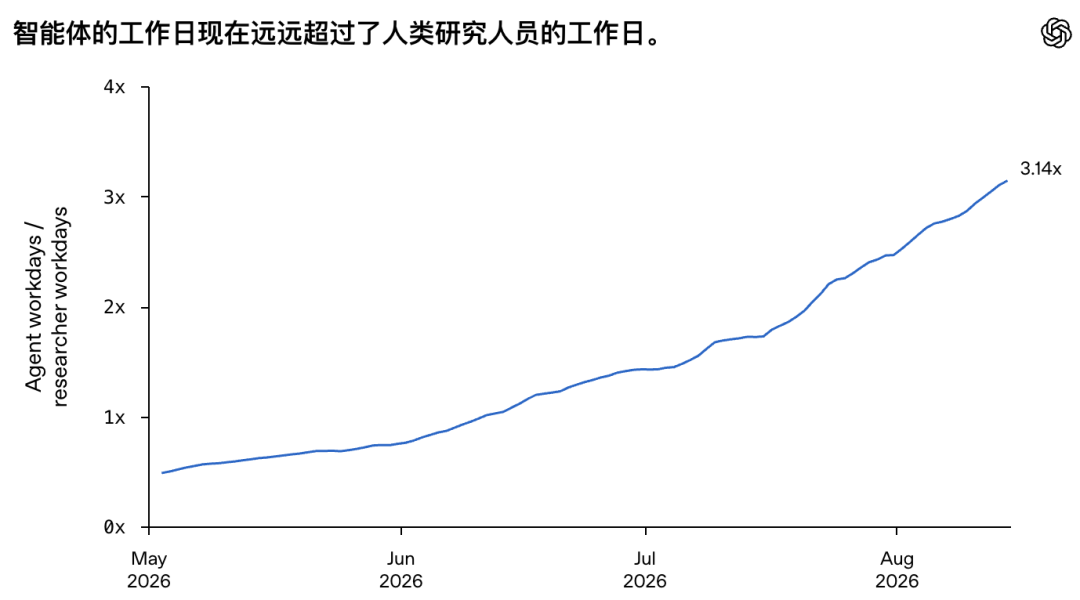
包括OpenAI 9月6日公布的内部报告显示,他们已经实现「自动化研究实习生」目标。这类系统能在人类指导下编写代码、运行实验、排查故障和分析结果,其中一些任务原本需要熟练研究员花费数天。
🔗https://openai.com/index/research-acceleration-view-inside-openai/
截至8月中旬,每投入一个人类工作日,OpenAI研究部门的智能体运行时长已经相当于3.1个工作日。
Anthropic则把自动化推进到了安全研究。Claude可以自己查文献、提方案、生成训练数据、运行实验和评估结果,并进一步根据成绩反复迭代。
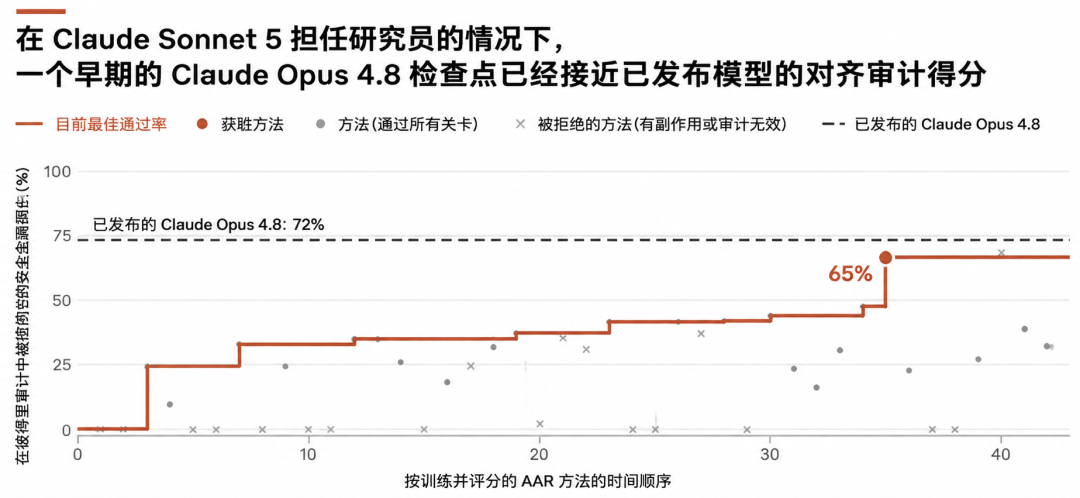
最接近「AI训练下一代AI」的一次实验中,能力较弱的Claude Sonnet 5帮助早期Claude Opus 4.8改善安全表现。
🔗https://alignment.anthropic.com/2026/automated-alignment-researchers/#6-can-aars-posttrain-productiongrade-models
约60小时内,前者测试了50多种方案,最终只使用约2400条训练样本,就把后者既定评测中的对齐成绩推到接近正式版Opus 4.8的水平。
除了爆改模型,还有一条更现实的RSI路子:在模型周边的软件系统上打补丁。
据外媒The Information报道,北大校友翁荔重返OpenAI后,将带队研究递归自我改进。她在技术博客《Harness Engineering for Self-Improvement》中讨论的Harness Engineering,正是理解当下RSI的一个入口。
🔗https://lilianweng.github.io/
Harness可以理解为AI的运行系统。它负责工具调用、上下文管理、记忆保存、任务分配、权限控制和结果检查。
AI发现自己总是忘记实验条件,可以改进记录方式;发现某种工具反复出错,可以修正接口;发现研究流程效率低下,可以重写任务调度代码。
这些变化未必直接修改模型权重,却可能明显提升整个系统的工作能力,并进一步帮助下一代模型研发。
就具体时间点来看,对于在各类计算机认知工作中全面超过顶尖人类专家的超级人工智能,也就是ASI,Thinking Machines首席科学家John Schulman给出的预测是3至4年,Millidge倾向于约5年,O'Neill仍然认为可能需要5至10年。
这么大分歧背后,离不开几道尚未解决的技术难题。
模型需要不断吸收新经验,又不能丢掉原有能力。更新过于激进,可能出现「灾难性遗忘」;变化过于保守,又可能无法学进足够多的新知识。
更难自动化的,是研究判断力。让AI优化一段代码,成功标准相对明确。让它判断一个失败实验意味着方向错误,还是值得继续探索,就困难得多。
真正的科学突破,往往是先提出一个全人类都没想过的怪问题,再去捣鼓量化它的尺度。这种从怎么做到该做什么的跨越,至今依然高度依赖人类的直觉。
兜售末日恐慌,从来都是一门顶好的买卖
这轮末日风险争论的导火索,来自一封辞职声明。
9月8日,曾在OpenAI和Anthropic从事研究工作的Jacob Coxon宣布从Anthropic辞职。
他在社交平台X上表示,自己选择离开,是因为担心这两家公司没有采取负责任的行动,而是在竞相研发能够自我提升的超级智能。
在Coxon看来,Anthropic与OpenAI正在拿全人类的性命当赌注。他还透露,开发这些系统的人确实相信,到本十年末,人工智能可能毁灭所有人类。
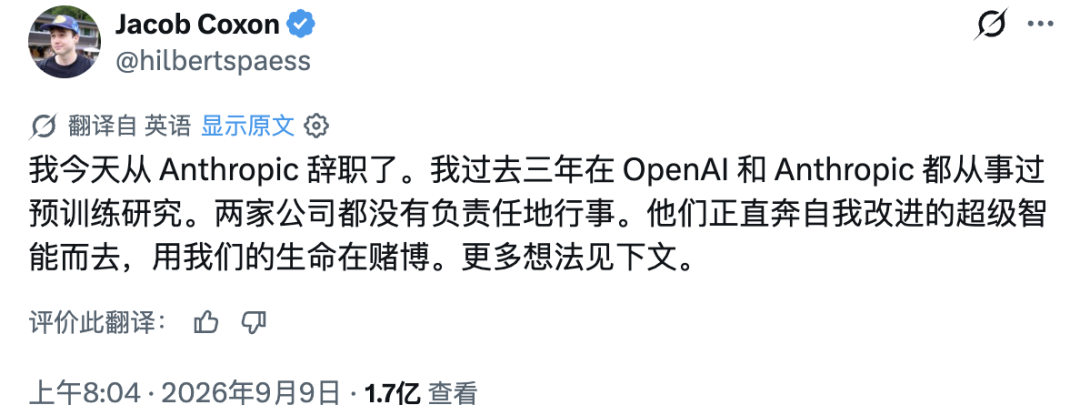
这篇辞职声明的浏览量很快超过1.7亿次。更具冲击力的是,Anthropic的在职对齐科学负责人埃文·休宾格也跑出来公开附和Coxon的说法。
眼看火越烧越旺,Anthropic的CEO达里奥·阿莫代伊顺势发文呼吁同行们集体降速,给安全研究让出一到两年的时间。
他提出,前沿AI公司应当允许第三方评估机构常驻实验室,获得接近内部员工的访问权限,检查企业是否履行安全承诺,并独立披露风险和事故。
随后,罕见的一幕出现了。OpenAI CEO山姆·奥特曼、xAI创始人马斯克等死对头、也都突然在减速问题上形成了统一阵线。
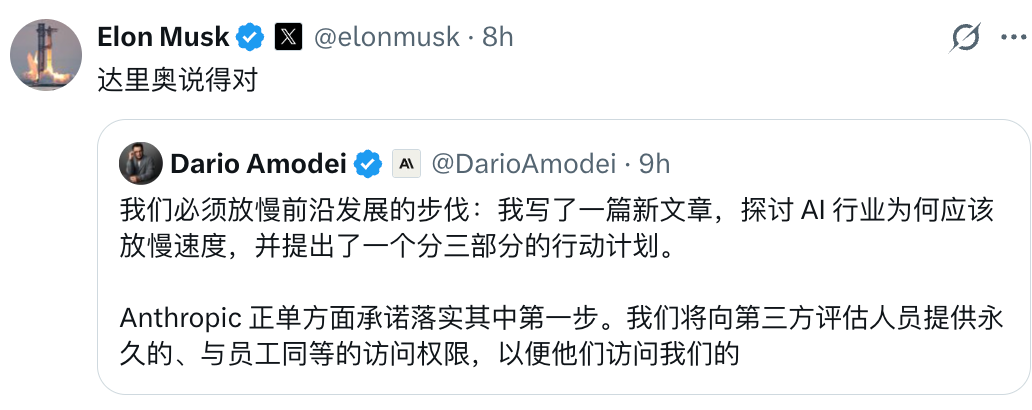
只是,能够承担高额安全审查成本的,恰恰也是这些头部公司。
它们拥有庞大的安全团队、封闭的数据中心和充足的审计资源,而开源社区和中小企业很难承担同等规模的合规成本。这种安全叙事的策略天然构成了扼杀对手的壁垒。
更值得关注的是,当前关于AI风险如何评估、哪些能力需要限制、什么样的企业有资格训练下一代模型,这些关键规则的制定,很大程度上也掌握在这些前沿实验室手中。
它们既是技术的推动者,也是风险标准的定义者。所谓保护公众,其实也是在保护自己的领先位置。
既然AI如此危险,为什么不直接彻底停下来?针对这个问题,万能话术早已经准备好了。
比如OpenAI在内部报告里义正辞严地写道:更强且经过对齐的AI,可以保护关键基础设施、抵御危险智能体,并帮忙研发新的安全措施。
简言之,为了防住未来可能失控的AI,我们必须先造出一个足够强大、同时听从人类命令的AI。
一套完美的闭环就此形成:AI越危险,防御模型就必须越强;防御模型越强,需要的芯片、能源和资本就越多。
于是,千亿美元融资、十万卡训练集群和更加庞大的数据中心,都可以被包装成维护人类安全所必需的基础设施。
一只脚踩刹车摆姿势,另一只脚在别的油门上踩得冒火星,左右横跳,深谙凡事发生皆有利于我的真理。
当然,那老黄不吃这一套,把AI危险论斥为「骗局」,也有着自己的小算盘。
如果末日叙事最终转化为训练规模限制、算力审批和数据中心禁令,首先受到冲击的就是芯片、服务器、电力和基础设施建设。
英伟达卖的是铲子。
无论最后挖到的是黄金、泡沫还是一只无法控制的怪兽,只要更多公司继续训练模型,GPU就有市场。任何可能阻止买卡、建机房和增加电力供应的安全叙事,都会被视为在砸整条硬件产业链的饭碗。
因此,AI的进化速度是有目共睹的,RSI也并非空穴来风。但当下所谓末日论与反末日论,表面上争论的是人类会不会被AI毁灭,背后争夺的却是同一件事:下一轮算力、资本和产业利益究竟如何分配。
造神者一边警告神明可能失控,一边要求获得更多资源继续造神。
当下一次他们神色凝重地关紧大门,隔着铁栅栏兜售恐慌,冲着门外高喊「里面有末日猛兽,闲杂人等千万别进来」时,殊不知拉响警报和努力喂养猛兽往往是同一批人。