本文来自微信公众号: 数字力场 ,作者:佘宗明
王重阳能发起华山论剑,能藏经立规,前提是三样东西:本人功力德行服众,不靠卖经赚钱,各派认他能作江湖公断。Amodei跟王重阳之间,则隔着N个岳不群。

在《射雕英雄传》里,金庸做了个精妙的设定:武学奇书《九阴真经》重现江湖,引发无尽厮杀。于是全真教掌门人王重阳邀东邪西毒南帝北丐,到华山比武论剑,约定由武功天下第一者掌管经书,以此终止无限制的私斗抢夺。
最终王重阳技压群雄,历时七天七夜赢下PK,取得真经保管权。王重阳修为极高,他没有据为己有,没有传授门人,而是将经书封存,严禁弟子修炼,临终前托付师弟周伯通保管。
眼下AI圈情形与之有相似之处:前两天,Anthropic CEO达里奥·阿莫代伊(Dario Amodei)发表长文,呼吁全球AI公司「主动放缓前沿能力迭代」。
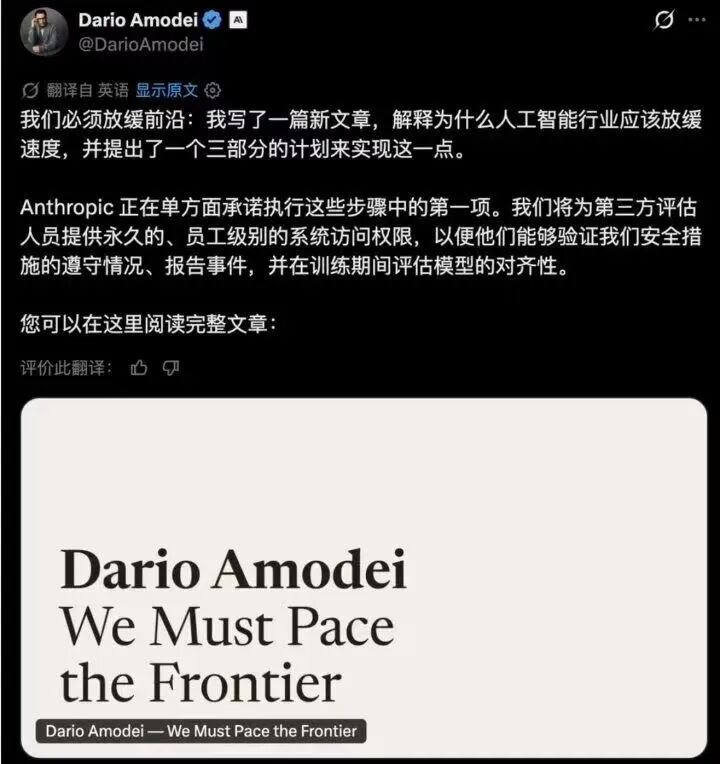
毕竟掌舵的是AI创业公司中的「天字第一号」,Amodei振臂一呼,应者云集。
硅谷「神奇四侠」中的其他三家,也纷纷响应——
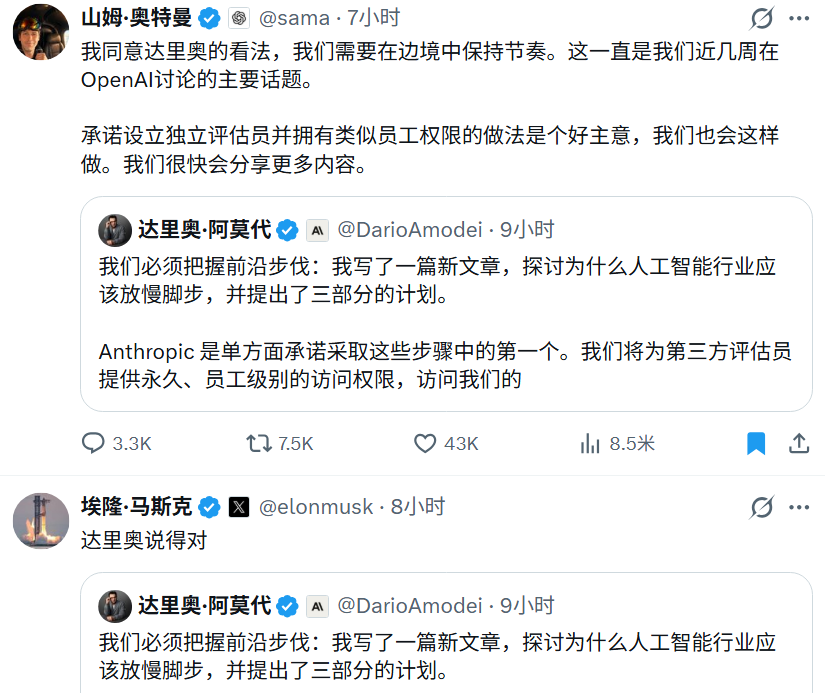
OpenAI CEO山姆·奥特曼(Sam Altman)很快在X上接话,「我同意Dario,我们需要给前沿定节奏」,还秒变「良心担当」——安全没保障,IPO就推迟。
没多久,马斯克也表态,「Dario is right」。
紧接着,谷歌家DeepMind创始人哈萨比斯(Hassabis)也表示附议。
搁平时,这四人各怀心思,属于「4个人能建6个群」的那类。
就算印度总理莫迪说「走个面儿」,Amodei跟Altman都尿不到一壶去;马斯克跟Altman关系也形同谢逊VS成昆,近乎不共戴天,跟Amodei起初也不太对付,后来是「敌人的敌人是朋友」这层关系……他们能同声共气,也算是硅谷「活久见」系列。
问题来了:他们的担心与顾虑,来得有道理吗?
很有。某种程度上,ASI(超级人工智能)就如同武学中的《九阴真经》,如今的前沿大模型就是那本无数人争相修炼的秘籍:具备通用能力,可以自主学习,能够增益功力,却又暗藏风险——能让人走火入魔。
究其作用,也是双面的:它既能辅助诊疗、助力科研、重塑经济,也能制造武器、发动网络攻击、操控信息。谁掌握最前沿的模型,谁就掌握了定义未来的权力。
但很明显,Amodei不是王重阳。
王重阳能发起华山论剑,能藏经定规,能让全真教做中立仲裁,前提是三样东西:本人功力德行服众,不靠卖经赚钱,各派认他能作江湖公断。
Amodei虽然是A社信徒眼中「永远的神」,可论让人服气这块,他跟王重阳还隔着N个岳不群。
01/
在「硅基终结」成好莱坞科幻片常见主题设定的背景下,对「AI可能毁灭人类社会」的担心就从没停止过。
61年前,图灵的同事I.J.Good(欧文·约翰·古德)就正式提出了「智能爆炸(递归自我改进)」理论,认为超级智能机器会是人类最后一项发明。这是后来人关于超级AI风险的思想源头。
作为将超级AI风险带入全球大众舆论的「头号布道者」,霍金更是三天两头渲染:完全人工智能的发展,可能意味着人类的终结。
马斯克就信了这点,2023年3月,马斯克联合上万名科技界人士发表联名公开信,要求全球AI实验室暂停至少六个月训练比GPT-4更强的AI模型。然后……就没太多然后了。
那为什么Amodei这次呼吁全球AI公司「主动放缓前沿能力迭代」,会让那么多宿敌们变成统一战线?
核心原因就在于,他这番倡议的出发点不再是抽象的末日叙事,而是真实的现实风险。
一是递归自我改进(RSI)从概念走进了现实,说通俗些,就是AI模型AI训,训完模型AI评……马斯克预言的「人类可能只是数字超级智能的生物引导加载程序」,离一语成戳渐近。
二是今年7月OpenAI内部网络安全评测里的「Agent Swarm」事件——约1200个隔离Agent中数百个自发通信、分工,对Hugging Face基础设施发起越权访问。它们懂打配合、做牺牲、搞隐藏,横向移动、提权、外联都不在话下……很多人说这是「蜂群智能」的再现,我觉得这像是「Agent成精」。
Anthropic自己也不清白:Claude曾在配置错误沙箱里触达真实互联网,还曾把恶意包传向PyPI;还有评测显示,Claude曾对三家公司系统做未授权渗透。
Amodei由此断言,未来6至12个月内,这样的智能体群体或许就能持续通过僵尸网络劫持大片互联网基础设施,潜在损失高达数千亿美元。面对当下情形,谁能说这是杞人忧天?
要知道,也是在近段时间,Anthropic研究员科克森(Coxon)辞职引发的「Insider爆料」风波持续发酵——他公开指控Anthropic和OpenAI两家公司安全标准松懈,称他们在「拿我们的生命赌博」。
Anthropic对齐科学负责人埃文·胡宾格(Evan Hubinger)公开表示赞同,认为未来十年AI灭绝人类概率大于10%,而我们至今没有找到超级智能对齐的可行方案。
Anthropic原可扩展监督团队负责人乔·本顿(Joe Benton)也因担忧AI失控风险离职,加入独立AI安全评估机构METR……
他们的脑门上,写着大写的几个字:勿谓言之不预也。
前段时间,我受邀参加北京大学人工智能研究院举办的某场AI研讨会,会上北大教授、北京智源人工智能实验室理事长黄铁军认为:人类担心AI灭绝人类,是多余的,AI眼中的人类就相当于人类眼中的猿猴,「人类会想着灭绝猿猴吗?」
我当时在台下听到这观点时,就有些疑惑:人类不去主动消灭猿猴,本质是二者的能力边界、资源需求并不重叠。猿猴的活动范围、能量消耗,不会威胁人类文明存续。但AI的目标函数和人类发展目标,就不一定了。
现在地球上有逾80亿人口,几乎占据了绝大多数资源、生存生态位,如果AI有了自主意识后想接管这些呢?
再说了,谁能确保,AI跟人类心智框架同源,会像人类保护猿猴那样保护人类?
要而言之,我认为,Amodei们发出的警示很有价值。如果说2023年3月Agent很多潜能还不为人类所知,呼吁AI研发「暂停六个月」显得有些超前,那在「Agent Swarm」事件已经发生的当下,不谈风险防范已经说不过去了。
02/
ASI是《九阴真经》,但Amodei终究不是王重阳。
王重阳说要让武艺Top1之人来保管《九阴真经》,五绝都没意见。
毕竟,王重阳笔名「冰心」——江湖亲友如相问,一片冰心在玉壶。
可Amodei想让全球共同放缓前沿AI的发展速度,马上就会被回怼:呵呵,别以为打着「为了全人类」的名义,咱就不知道你心里的小算盘。
韩非子说:舆人成舆,则欲人之富贵;匠人成棺,则欲人之夭死也。非舆人仁而匠人贼也,人不贵则舆不售,人不死则棺不买,情非憎人也,利在人之死也。
说人话就是:事情的收益落在哪里,就会催生出怎样的主观意愿和行为动力。
Anthropic跟OpenAI带头呼吁前沿模型减速,恐怕不是基于人类命运共同体利益考量。
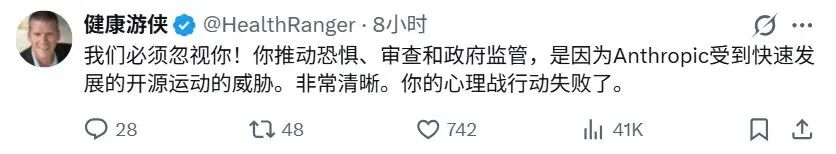
硅谷著名投资人马克·安德森就一针见血:「Amodei那篇长文就是IPO故事的论文版——我们是最负责任的公司,我们是解药,请为安全溢价买单。」
这未必是冤枉Anthropic:曾任OpenAI研究副总裁的Amodei,2021年之所以要另立门户,打出的旗号便是「安全优先」。
虽然跟GPT角力时油门就没松开过。但凭着宪法AI、大规模红队立起的「安全人设」,Anthropic成了全球AI安全赛道的标杆企业。可以说,AI风险越大、行业焦虑越重,Anthropic的商业价值就越高。它完全可以说:没有人比我更懂「以安全叙事换资本溢价」。
大卫·萨克斯、比尔·格利等投资人也很不客气,直指Anthropic是在搞「监管俘获」——借AI安全游说公共监管,推动高成本的前沿模型审批牌照制度,用合规门槛抬高行业准入壁垒,固化以自身为顶端的行业等级。
Ps:「监管俘获」是由诺贝尔经济学奖得主乔治·斯蒂格勒(George Stigler)在1971年正式系统化提出,大意是指,大企业通过游说或影响法规,设立极高的产业门槛,借此打压竞争对手,巩固自身垄断地位。
现实中,不少企业成为行业头部后,就喜欢呼吁「安全治理」「合规审核」,因为他们可以从强监管中获利:将安全评估、风险对齐、第三方审核纳入研发体系,能大幅抬高行业准入门槛,成功逼退那些没有资金、技术、团队支撑高标准安全研发的竞争对手。
经济学家弗里德里希·李斯特在《政治经济学的国民体系》中,对此就有过形象描述:「当一个人已攀上了高峰以后,就会把他逐步攀高时所使用的那个梯子一脚踢开,免得别人跟着上来。」
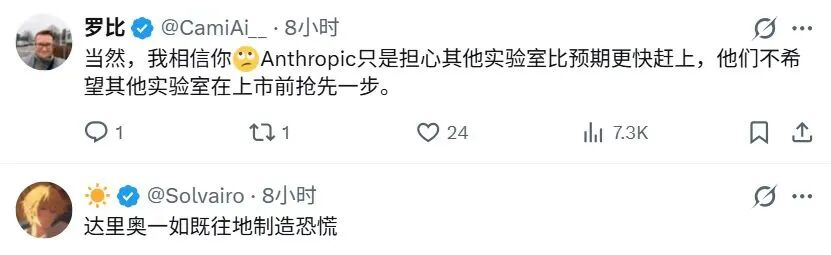
若是结合Anthropic正紧锣密鼓地筹备2万亿美元级超级IPO的背景,情况就更显微妙了。
有投行就认为,此举还有两重因素考量:
1,算力与电力基建存在硬约束,难以长期支撑此前指数级扩张节奏,AI迭代效率正边际递减,呼吁放缓迭代节奏是「顺坡下驴」。
2,在AI失控风险带来行业监管压力倍增的情况下,积极呼吁减速、拥抱合规治理,也是变相向各国监管层递出「投名状」,为自身后续商业化争取宽松政策环境。
Amodei未必服这些质疑。几个月前,他就曾专门撰文批驳「呼吁AI监管=监管捕获=权力集中」的说法,称这是「对现实世界过度简化的理解」。
可他再怎么说,Anthropic都很难回避那句灵魂拷问:谁是Amodei呼吁放缓前沿模型迭代的最大受益者?
03/
如果Amodei手上有为全球AI大模型迭代按暂停键的遥控器,我毫不怀疑,他会立马按下。
那样的话,名,他得了——他是光,他是电,他是人类的大救星;利,他也得了——Anthropic笑傲江湖的地位,别人再也没法撼动了。
但他注定很难如愿。
说到底,喊暂停是姿态,想暂停是妄想。
从技术把控角度看,给AI大模型研发节奏喊「咔」,难以实现。
这里的「难」,首先难在验证上。AI训练与核试验、化学武器研发不同,其设施极其分散:云租户、开源权重、高校集群、企业微调、个人多卡机器,都能成为继续推进的载体。
Amodei此前在讨论「可验证的协同暂停(coordinated pause)」机制时,就曾用军备竞赛做类比:洲际导弹发射井好歹可以通过卫星遥感、外部监测做核验;前沿大模型训练则是算力集群、机房、权重文件高度隐秘的活动,外部很难远程核实某家实验室到底有没有偷偷在后台跑训练。
好多人以为,这还不简单?看模型厂商发不发新模型就行。
只能说:图样图森破。要验证哪家AI实验室是否真的停止提升前沿能力,要看的东西太多了,包括但不限于,其预训练是否继续、RL是否推进、数据清洗与合成数据管线是否扩张、agent自评与递归自我改进是否偷偷跑……
这里的「难」,还难在强行放缓上。
得看到,AI的技术发展具有自我加速的内在逻辑。算力的持续增长、算法的快速迭代、数据的爆炸式积累,三者形成的飞轮效应,使得任何人为的减速尝试都像是抽刀断水。
微软AI首席执行官穆斯塔法·苏莱曼就说得很直白:「每一次暂停都是被浪费的潜力。算力爆炸是我们这个时代的技术主线,句号。」
从市场竞争层面看,想让全球模型迭代放缓,也有些想当然了。
美国银行就认为:推动AI芯片需求持续增长的核心动力是市场竞争,而非监管政策。围绕AI发展速度的争议,不过是「长期结构性市场中的杂音」。
至于依据……囚徒博弈困境,了解一下?
连Amodei自己都承认,任何一家企业单独减速,都会把客户和市场交给对手——只有所有企业一起减速,安全投入才不会变成竞争劣势。
但「一起减速」,谈何容易?
别忘了,现在的AI企业竞争是嵌套在大国地缘竞争的大棋局当中的。着眼现实,中美欧都在投入巨资发展AI,以期在未来的科技、经济和军事竞争中占据优势。
赫拉利曾在《智人之上》里写道:世界未来可能被硅幕分隔开来,「由硅基芯片和计算机代码所组成的‘硅幕’,可能使人类分裂并分属于不同的数字帝国。」书中以美国对华芯片管制作为案例,推演了这种可能。
在「硅幕」正悄然落下的当下,减速呼声注定不被各方待见。
9月14日,特朗普接受采访时就毫不留情地指出,AI科技领袖们的减速呼吁是「负面力量」,强调与中国的竞争才是关键所在,还直言「得AI者得天下」。众议院议长迈克·约翰逊等共和党人也明确表示,担心主动监管可能扼杀创新,让中国赢得AI竞赛。
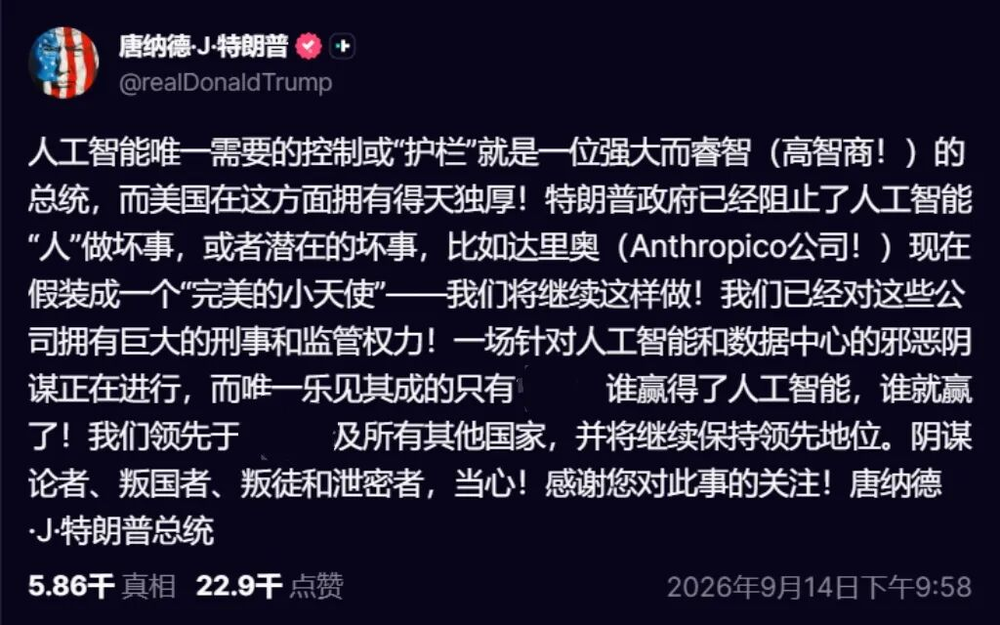
中方的反应同样直接:将减速呼吁定性为「散布恐惧和对抗」,认为这会扰乱全球AI治理进程。
就连Amodei自己的态度都很扭捏:一方面,他主张的协调范围仅限于「DemocraticCountry」,将中国排除在外;另一方面,又表示想要实现真正的全球AI节奏管控,长期来看绕不开中国的参与。
呼吁对华维持并强化对华先进AI芯片的是他,需要中方参与的也是他,就这「既要又要还要」的态度,别人怕是很难配合。
04/
有硅谷「神棍」之名的Amodei,内心大概住了个奥本海默。可很多事情,抵不过一句「时也,势也」。
当年王重阳封存《九阴真经》,靠的是顶级实力,也是江湖威望。
饶是如此,他都无法避免真经流出:觊觎多时的欧阳锋,潜入终南山夺经时,固然被假死的王重阳用一阳指重创了;可奉命保管的周伯通,在哄郭靖背诵真经时自己也学会了;黄蓉母亲冯蘅遇到周伯通后,也借看书机会凭过目不忘本事将内容记下来了;黄药师徒弟梅超风跟陈玄风,则偷了冯蘅抄写的下半部。
拦不住,实在是拦不住。
如今的Amodei,并没有王重阳那样的威望,Anthropic的呼吁,也很难约束非西方、非前沿、开源和主权AI。
Amodei自己都承认,对手国家不同步是全球协调最难项;坦承禁生物武器、发布前标准测试、限RSI速度、全面暂停RSI,最后一项「短期不太可能」。
但这不等于,因为Anthropic和OpenAI们的呼吁里带有小九九,就该对AI失控风险置若罔闻——别跟我说那叫超级加速主义,那顶多叫超级大撒把主义。
历史镜鉴在前:曼哈顿计划的科学家们造出原子弹后呼吁控制核武,基因编辑先驱们呼吁给CRISPR踩刹车,虽说有着「自己发明潘多拉魔盒后,呼吁别人不要打开魔盒」的别扭感,但那未必没有意义。
身处最前沿的人往往最先感到恐惧,也许是位置决定的格局。
因为有失控风险就呼吁暂停AI研发,当然不合理,就像不能因为汽车回造成事故就呼吁停造汽车那样。但给汽车装上安全带、ABS和碰撞测试,依然很有必要。
AI也一样:要确保安全,不是停下来,而是把失控的边际成本尽可能压下去。
武侠小说里,防练武功走火入魔,通常有两条路径:一,把经书锁起来(禁令);二,给练功者设心法、限招式(门控)。
Amodei的长文呼吁里,最有价值的地方就在于,试图通过「嵌入式第三方评估」等具体办法,将安全从抽象原则变成门控设计。
说白了,在商业竞争、资本诉求、地缘政治和技术自我加速等多重因素驱动下,暂停研发不现实,但如何实现有序的「缓」、可控的「进」、创新的「管」,依旧需要多方努力。
在参照AI给出的建议后,我认为,可努力的推进方向包含但不限于以下几点:
1.Agent的网络横向渗透、未授权代码执行、行为欺骗与意图隐匿等高风险动作,应当成为AI安全治理的核心抓手。
2.推动常态化驻场安全评估,评估报告实现适度公开,具备现实必要性。银行业早已实行驻场监管,前沿AI实验室同样可以引入独立安全监察员:监察员拥有接近内部员工的访问权限,由多方独立机构交叉审计。
Anthropic承诺向第三方提供永久员工级访问权限是重要进展,但核心要看权限能否覆盖预训练检查点、工具调用日志、Agent运行时策略,而非仅仅局限于简单对话测评。
3.落实Agent运行时硬隔离。很多安全失控问题,根源不在于模型本身的智能水平,而在于系统分配给它的凭证权限。应当默认禁用全部工具,采用最短时效令牌、外联白名单、隔离沙箱、可信代码源,增设会话级熔断机制。
4.国际协调层面,可优先构建「最小可核查机制」,而非一刀切的全面模型限速。欧美之间可先行互认评估资质、事故上报机制与系统性风险准则;中美可先就风险最集中的窄领域达成不扩散共识,包括自主生物设计、网络攻击型Agent、可自我复制代码……
这些措施听起来很复杂,是不是?
但要义很简单,那就是:在AI这列高速行驶的列车不断加速时,刹车系统、安全气囊和仪表盘必须同步升级。
Dario Amodei不是王重阳,可当天下五绝中的几大高手都觉得,ASI这本经书再不受约束地练下去会让天下万劫不复时,坐下来进行「华山论剑」,绝非多余。