本文来自微信公众号: 甲子光年 ,作者:周悦,编辑:王博,原文标题:《腾讯、阿里、字节,为什么都在给Agent“造世界”?|甲子光年》
对Agent来说,“环境”既是考场,也是训练场。
“AI的下半场——从现在开始——将把重心从解决问题转向定义问题。”
这是姚顺雨去年4月在博客《The Second Half(下半场)》中写下的判断。他认为,当一套通用训练方法能够越来越快地解决现成任务,更重要的问题将变成:AI到底该做什么,什么又算真正的进步?
他尤其强调评估(Evaluation)。继续造更难的基准测试(Benchmark)已经不够了,他更关心的是,基准测试上的高分,最后能不能转化为真实工作中的能力。
去年12月,姚顺雨加入了腾讯。今年6月,姚顺雨以腾讯首席AI科学家、腾讯混元大语言模型及AI Infra负责人的身份畅谈了“腾讯AI下半场”。提到Agent,他先强调“环境”的重要性:“如果没有好的环境,Agent就没办法去做各种各样的事情。”
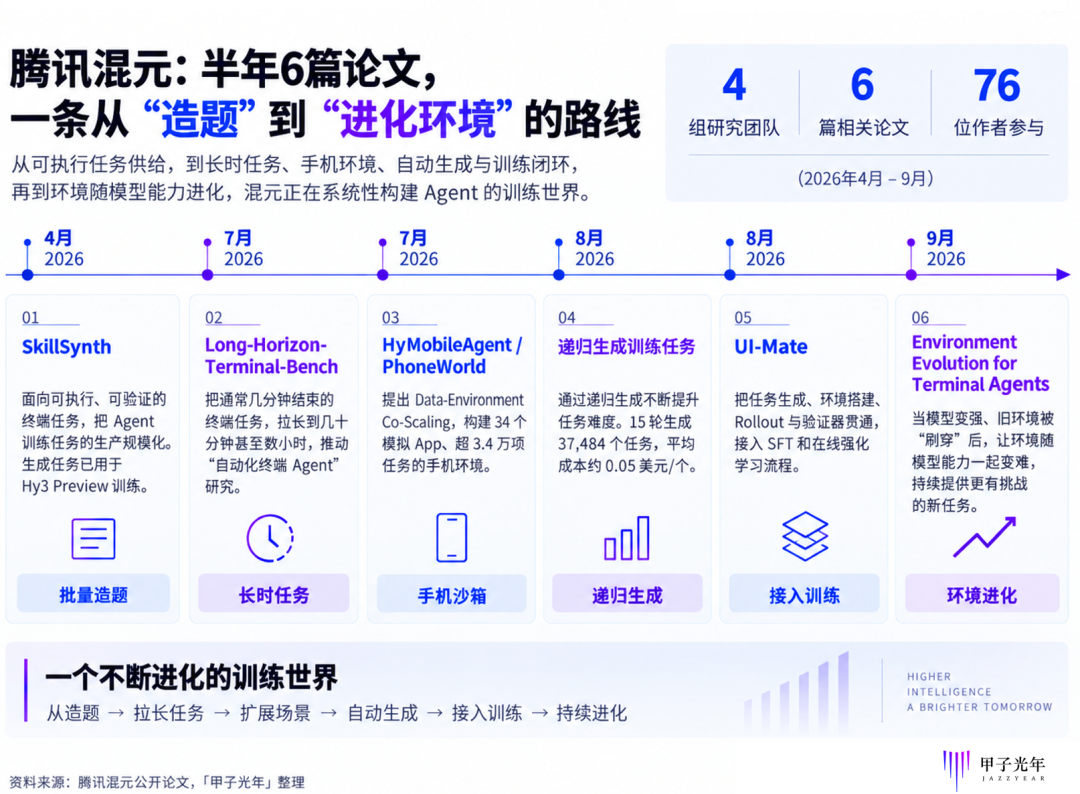
「甲子光年」梳理发现,近半年腾讯混元发布了6篇与“环境”相关的论文。从可执行任务供给,到长时任务、手机环境、自动生成与训练闭环,再到环境随模型能力进化,混元正在系统性构建Agent的训练世界。
图片来源:「甲子光年」整理
巧合的是,另一家大厂也在同一时期走向了这个坐标。
今年7月,阿里通义联合浙大、北大的论文《Towards General Agentic Intelligence via Environment Scaling》发表于ACL 2026 Findings,直接把“Environment Scaling”写进标题,作者中包括阿里巴巴首席科学家周靖人。
不仅是腾讯与阿里,字节跳动Seed、以及太平洋对岸的OpenAI和Anthropic,都在涌入同一个战场。
对Agent来说,“环境”既是考场,也是训练场。
排查一个软件故障,可能起初只有一句简单的任务描述。但要判断Agent是否真的具备工作能力,就不能只给它一道考题,还得给它代码仓库、运行工具、状态变化和结果验证,搭出一个足够接近真实业务的“世界”。
姚顺雨说的“AI下半场”,正在多出一个越来越重要的变量:环境。
1.混元至少4拨人,在给Agent“造世界”
参与过腾讯混元研发的研究人员李非(化名)告诉「甲子光年」,他们从今年2月前后开始明显关注Environment Scaling。一个很直接的信号来自招聘:当时,OpenAI和Anthropic开始专门招募强化学习环境(RL Environment)的人。
“他们要招这样的人,那就说明这个方向是有价值的。”李非说。
在他看来,算法逐渐稳定,扩充训练材料是一条收益相对可预期的路。但面对Agent,只靠静态网页和语料,已经不足以覆盖它需要学习的交互过程。它要调用工具、更改数据库、经历一长串操作并拿到即时反馈。
数据没有消失,只是从文档变成了可以交互的“世界”。
4月,混元发布SkillSynth,规模化生成终端任务,其中一部分后来被用于Hy3 Preview训练。
几个月后,新问题出现了。同一批环境,模型刷上几个版本就彻底摸透了,有效的学习信号越来越少。训练环境也有“保质期”。
9月3日,混元公开《Environment Evolution for Terminal Agents》。一作依然是香港科技大学博士生范致远,12位作者中有11位与4月的原班人马重合。
不同的是,这次他们不再从零造环境,而是让已有环境进化。原本Agent只需写个静态页面,升级成从前端到后端部署、动态维护等更复杂的任务。
但这并不是混元一支团队研究的方向。「甲子光年」梳理发现,仅今年4月至9月,混元至少4组研究人员,围绕“造环境”发布了6篇论文,累计76人次署名。混元的几组研究也在不断向纵深推进:
把任务做长:混元大模型前沿团队科学家史淯城等人,推出Long-Horizon-Terminal-Bench,把终端任务从几分钟拉长到数小时;紧接着又通过15轮递归生成了超3.7万个长程任务,平均一个任务的造价压到了5美分。
把环境搬上手机:混元视觉团队发布HyMobileAgent,搭建了包含34个模拟App、超3.4万项任务的PhoneWorld,从在腾讯健康预约疫苗到跨App调度,让环境与数据协同扩展(Co-Scaling)。
把环境接进管线:8月发布的UI-Mate,直接把任务生成、搭建沙箱、验证器连接,将Environment接入后训练的在线强化学习流水线。
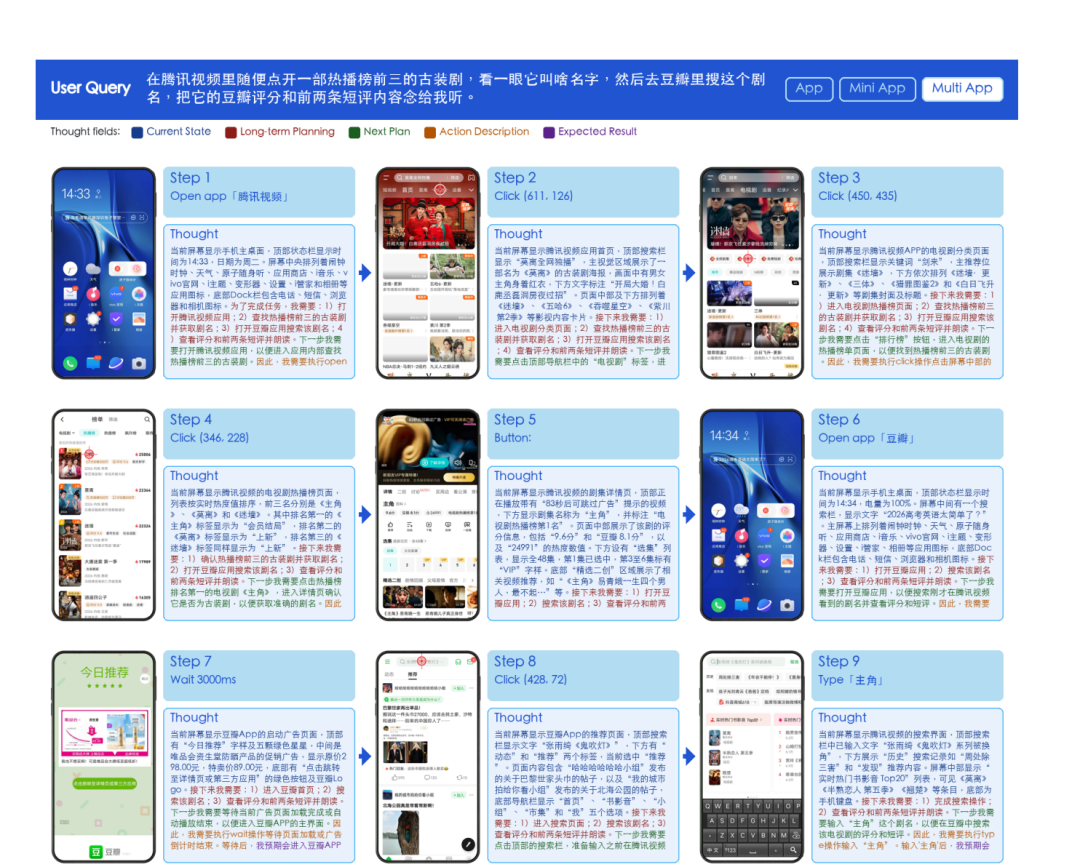
Agent模拟在豆瓣上搜索腾讯视频热播电视剧,图片来源:混元视觉团队论文《HyMobileAgent:Data-Environment Co-Scaling for Efficient GUI Agents》
与此同时,混元也发生了一轮大的组织调整。
HyMobileAgent论文中的项目负责人是胡瀚。他曾担任腾讯混元多模态理解负责人,并向姚顺雨汇报。今年4月,两人还共同署名了HY-Embodied-0.5。
7月23日,胡瀚离职创业。原大语言模型部和多模态模型部合并为基础模型部,由姚顺雨统一负责,“强化学习及Agent能力”被明确写进新部门职责。
李非表示,他所在项目由负责人组织,团队最初很多选题是研究人员的自主驱动;对于更高层是否存在统一的Environment规划,他并不了解。
但从产出结果来看,水面下的分散支流,正汇聚成同一条大河。
2.Environment Scaling正在加速
混元对于环境的重视不是个例。
不久前,宾夕法尼亚大学教授、OpenAI研究员苏炜杰在接受「甲子光年」采访时打过一个比方:Scaling就像一个“什么都能往里扔的篮子”。模型是个高维函数,预训练的收益放缓了,研究者不断寻找新的变量,只要找到一个新的变量求导大于零,就能继续看到收益。
“Scalling law还没有撞墙,一个变量放缓并不影响大局。”苏炜杰认为。
阿里通义联合北大、浙大的团队,直接把这个新变量命名为“Environment Scaling”,周靖人也在作者名单中。论文认为,训练时见过的环境越丰富,Agent之后能处理的工具和任务也越多。
今年以来,多项公开工作已经把训练环境扩展到千级、万级甚至更大规模。
Ai2与华盛顿大学发布的TMax包含14,600个终端Agent训练环境;Qwen与浙江大学团队的SWE-Universe,则从真实GitHub项目中构建了807,693个可验证的软件工程环境。
但在“把世界做大”的过程中,所有人都遇到了同一个现实:高质量的环境难造。
混元团队准备训练材料时,曾从Hugging Face和GitHub收集47678个公开终端环境。按照环境质量、可解性和难度等要求筛选后,最后只留下127个。
47678个环境,最终只有127个合格——淘汰率高达99.7%。
李非举例,任务要求和检测标准如果不一致,对小模型影响不大,“因为小模型本来就不会”;但到了大模型,“如果一个任务的质量不够,它会很明显地直接被hack掉”。
“我们不能误导Agent,也不能靠加Bug把环境变难,故意让Agent做不对。”李非认为,好的环境不仅要没有Bug,还得足够难,难到当前Agent确实还做不出来。
类似的问题也出现在OpenAI和Anthropic。今年7月,OpenAI重新审计SWE-Bench Pro,发现731个公开任务中,约30%存在不同程度的问题,包括测试过严、提示不完整、测试覆盖不足等。
Anthropic发现,即使模型、任务和Harness都不变,只调整运行环境的CPU、内存等资源配置,Terminal-Bench 2.0在最严格与最宽松设置之间也能相差6个百分点。
这意味着,环境首先得足够可靠,质量之外,还有时效性的问题。
模型能力不断进化,另一类研究想让环境跟着模型一起进化。比如,字节Seed与中国人民大学团队的Agent-World已经搭出超过2000个环境、1.9万个工具,并根据Agent暴露出的能力缺口继续生成新任务,让训练环境跟着模型一起变化。
模型越强,真正还能让它学到新东西的环境越难找。训练场不只要造,还得一直翻新。Environment Scaling需要一种持续的供给。
一旦某种资源变得稀缺且昂贵,一门全新的基础设施生意就会应运而生。
在大模型时代,训练数据需求把Scale AI推到了超过290亿美元的估值。那么在Agent时代,谁会成为下一个掌握“训练世界”的Scale AI?
3.下一个Scale AI会出现吗?
新的供给需求,已经长出生意。
李非观察到,一些创业公司正在组织人手构建高质量环境,再向模型公司提供。他提到,团队也尝试过使用模型直接合成环境:“量可以很快上来,但是它的质量很差。”完全依赖人工,开销又会明显增加。
资本已经投入。9月11日,据媒体报道,阿里正在洽谈领投AI训练与评测公司UniPat AI的新一轮融资,规模约3亿美元,对应估值约25亿美元;腾讯、红杉等现有投资者也可能参与。交易仍在磋商中。
UniPat并不是一家纯粹的“造环境”的公司。创始人李宽此前在阿里通义DeepResearch团队从事Agent后训练、数据合成和强化学习,是WebSailor等工作的核心作者;联合创始人兼CTO陈亮是北京大学计算语言学研究所博士生。
他们今年推出的Terminal-X、Vibe-Coding Arena等系统,做的正是把任务设计、沙箱环境与评测标准打包的一体化基建。
海外的整合走得更为激进。今年3月拿到a16z领投4300万美元的Deeptune,专门通过复刻Salesforce、Slack等真实软件环境提供“Agent健身房”。仅仅4个月后,它就被数据平台Mercor闪电收购——前者懂得怎么造环境,后者懂得怎么组织行业专家制定裁判标准。
Mercor CEO Brendan Foody也是Deeptune A轮的天使投资人。他告诉媒体,当初投资,很大程度上就是为了给收购铺路。
连Scale AI自己,都在今年开辟了强化学习环境(RL Environments)业务,并披露新增训练项目中接近一半已经涉及强化学习环境。
Environment的需求还不只停留在训练阶段。
9月的外滩大会上,周靖人谈到Agent真正进入业务时,专门提到了另一类“环境”:安全沙箱、权限管控、授权、追溯,以及Harness和Agent Framework层的安全执行环境。他认为,Agent要真正进入业务,这些基础设施必须一起补上。
这里的执行环境并不等同于前文的训练环境,但两者都指向同一个变化:模型越从“会说”走向“会做”,围绕它的环境越需要被单独建设。
但在中国市场,战局远没有那么简单。
腾讯、阿里、字节都在自建环境。原因在于,环境与后训练效果直接相关,头部模型厂很难把核心环境全部外包。而环境运行所需的庞大沙箱、即时隔离与高并发重置,本身又需要依托云基础设施。
对想成为“下一个Scale AI”的公司而言,这个赛道很窄。大厂模型团队懂模型缺什么,云平台懂机器调度,但谁真正懂金融机构、律所或一家医院里错综复杂的真实业务流?
姚顺雨在去年预判,AI下半场的重心将“从解决问题转向定义问题”。当大厂和资本开始花大力气给Agent“造世界”,这个抽象的判断,变成一个具体的产业落点。
一年后,答案还在进化,世界也被重新搭建。
*应受访者要求,李非为化名
(封面图来源:电影《头号玩家》)