本文来自微信公众号: AIGC从0到1 ,作者:王零壹
AI的临界点,不是它什么时候足够聪明,而是我们什么时候不再需要决定“这件事值不值得让它想一下”。
--
2025年,让AI在GPQA Diamond上达到约75%的水平,Epoch估算每题成本约为0.30美元。
不到18个月后,达到近似能力,只需要约0.0004美元。
725倍。
一种原本稀缺、昂贵、需要精打细算使用的“机器思考”,正在迅速逼近一种可以被大量调用、后台运行、甚至被浪费的资源。
9月22日,Epoch最新报告给出的中心估计是:自2023年以来,达到固定AI性能水平的最低推理成本,平均每季度下降约47%,折算下来约每年下降13倍。它覆盖数学、科学、棋类等五类benchmark;不同模型与统计口径会得出不同数字,因此47%更像一个合理的中心值,而不是自然常数。
真正值得注意的,并不是“AI便宜了13倍”。
而是人类可能第一次开始尝试回答一个此前几乎无法严肃测量的问题:
购买一个固定水平的机器认知能力,究竟要多少钱?
电力有$/kWh。
计算有$/FLOP。
存储有$/GB。
基因测序有$/genome。
而现在,开始有人尝试画出:
$/capability
固定能力水平的成本曲线。
让我们重新理解AI经济。
01不是token变便宜了,是固定能力正在变便宜
过去两年,模型厂商最爱讲的指标是:每百万token多少钱。
一个模型的token单价可以便宜十倍,但它为了完成一道难题,可能要多花三十倍token去推理、反思、调用工具、重试。此时,token虽然变便宜了,完成任务的成本却未必下降。
于是,Epoch换了一个问法。
它不再只问:
一百万token多少钱?
而是问:
达到70%的GPQA、25%的FrontierMath,或者某个棋类水平,市场上最便宜的实现方案要多少钱?
这是一个非常大的转向。
因为它把模型从“按字收费的API”,重新变成了一种可以按结果衡量的生产工具。
Epoch的做法,是为同一个模型画出一条“成本—性能曲线”:给它更大的推理预算,它会更贵,也可能更准;把许多模型的曲线叠在一起,就能找到某个时间点上、达到某个能力水平的最低成本。
这条外包络线,就是它所说的cost frontier成本边界。
换句话说,过去我们习惯比较:
谁的模型最强?
现在开始有人比较:
要买到同样强的能力,谁最便宜?
这很接近经济学真正关心的问题。
不是一单位原材料的价格。而是一单位有效能力的价格。
当然,Epoch测到的,是固定benchmark能力的最低推理成本。
它不是“思考本身”的价格。更不是现实劳动的价格。
一道数学题、一次法律判断、一段销售谈判、一个产品决策,显然不是同一种“thought”。
所以,“Price of Thought”现在更像一个研究纲领,而不是成熟的计量单位。
但很多重要的变化,都是从一个还不完美的仪表盘开始的。
02历史上,真正改变世界的从来不是降价本身
技术史上最容易被忽略的一件事是:
一项技术第一次能做到某件事,不代表世界已经改变。
它便宜到足以被大规模重组、调用甚至浪费时,世界才会真的改变。
电力就是最经典的例子。
早期电动机进入工厂时,许多企业只是把蒸汽机换成电动机。工厂的布局没有变,机器还是围着中央传动轴排列,材料流、工人分工、生产节奏也没有变。
这些改善,远远谈不上工业革命的第二次爆发。
真正的变化发生在工厂开始围绕电来重新设计:每台机器可以拥有独立电机;厂房不必再服从中央动力轴;生产线、空间、搬运、协作方式都被重做。
电力带来的最大生产率,不是“把蒸汽机替换成电动机”。
而是让“围绕中央传动轴组织工厂”这件事,变得不再必要。
经济学里把电力、蒸汽机、半导体、计算机称作General Purpose Technology:它们广泛适用于多个行业;自身持续改善;更重要的是,它们会迫使下游行业围绕自己产生新的互补创新。
AI很可能也正走进这个阶段。
“ChatGPT比人工写得更快、更便宜”,很可能只是AI时代的“用电动机替换蒸汽机”。
但还不是最大的事。
最大的事是:当认知成本持续下降,组织会不会不再沿用“人类思考很贵”这一前提,转而重新设计产品、流程、协作和决策?
那么AI将重写“什么值得被思考”的经济学。
03 AI的特殊之处:前沿向前跑,旧前沿向下塌
电力、存储、计算机都经历过成本下降。
但AI的曲线有一个很奇怪的双重运动。
一边是能力边界不断向前。
最强的模型在做更难的数学、代码、科研、规划与工具使用任务。
另一边是昨天的前沿能力,正在迅速变便宜。
今天只有最贵模型能做到的事情,明天可能被更小的模型、更低的推理预算,或者更多竞争者做到。
新能力被创造出来
→形成短暂稀缺
→厂商收取premium
→竞争者追赶
→蒸馏、量化、缓存、推理优化、算法进步
→能力成本坍塌
→旧前沿变成商品
→新前沿继续向前。
可以把它叫作:
滚动式商品化。
这也解释了一个常被误读的事实:
模型的能力并没有消失,但它的稀缺性消失了。
2025年值1美元的一段能力,2027年仍然完全有用。只是可能只值1美分。
所以模型层真正快速折旧的,不一定是capability。
而是capability rent——能力租金。
这会成为AI产业很残酷的一条底层规律。
前沿模型仍然可能极贵。
训练集群、芯片、人才、数据、实验和研发投入都可能继续上涨。
但复制昨天的智能,会越来越便宜。
于是,一个行业会同时呈现两件看似矛盾的事:
制造frontier intelligence,越来越昂贵。
复制yesterday’s intelligence,越来越廉价。
这可能正是AI产业的基本结构。
04为什么它会掉得这么快?
如果只看芯片进步,很难解释固定能力成本每年约13倍的下降。
但AI的成本曲线更像多条学习曲线同时叠加。
芯片更快。
推理工程更好。
模型结构更优。
训练方法更成熟。
大模型可以蒸馏出更小、更便宜的模型。
量化、稀疏化、缓存、投机解码在不断挤压推理成本。
更好的reasoning efficiency,让相同的推理不再浪费在无效路径上。
市场竞争又会继续压缩利润率。
太阳能的学习曲线大体是:
制造得更多,所以学会制造得更便宜。
AI的学习曲线则更像:
硬件更好,软件更好,模型更好,推理更好;
昨天的大模型,还能继续教出今天的小模型。
不仅是一条制造曲线,还是算法曲线、软件曲线、模型曲线、服务曲线和竞争曲线的叠加。
这也是为什么,当新能力刚刚出现时,它往往最贵,也往往降价最快。因为它最有价值,最值得被追赶、蒸馏、复制和优化。
05但便宜的智能,不等于便宜的劳动
这里是整件事最重要的刹车。
一个benchmark上答对问题,不等于完成真实任务。
完成真实任务,不等于稳定完成。
稳定完成,不等于被验证完成。
被验证完成,也不等于产生商业结果。
可以把它看成一条成本栈:
Compute
→Token
→Reasoning
→Capability
→Task Completion
→Reliable Task Completion
→Verified Task Completion
→Business Outcome
Epoch正在从token价格,往capability成本推进。
但真正决定经济结构的,是后面几层。
这也是为什么,越靠近现实任务,曲线越可能不那么漂亮。
数学题、代码题、棋类题通常有清晰输入、清晰边界、清晰评分。
真实工作却往往不是这样。
它有历史上下文,有项目惯性,有隐性知识,有模糊目标,有组织关系,有无法被自动评分的“到底算不算做好”。
METR在测量Agent的任务时间跨度时也反复强调:他们的任务已经尽可能做到自包含、明确且可评分;而真实工作往往依赖此前对话、项目背景、既有代码库、人与人的协作,以及难以算法化的成功标准。
因此:
cheap intelligence≠cheap labor。
廉价的智力≠廉价的劳动力。
一旦基础能力开始廉价化,瓶颈就会往上移动:
从模型,移向上下文。
从答案,移向验证。
从单次调用,移向长期工作流。
从“能不能做”,移向“谁敢让它做”。
真正稀缺的东西,可能越来越是:
Context、Data、Environment、Verification、Trust、Workflow、Tool Access、Real-world Execution、Feedback、Attention。上下文、数据、环境、验证、信任、工作流程、工具访问、现实世界执行、反馈、注意力。
06 GPU将更加不够用
很多人仍然在用一种线性的方式理解AI降价:
单位成本下降十倍,企业总账单就该下降九成。
技术史很少这样发展。
当效率提升让某种资源变便宜,人们通常不会只做原来的事情、然后少花一点钱。
他们会开始做更多以前不值得做的事。
这就是Jevons Paradox当年的直觉。
煤炭效率提升,未必减少煤炭消耗;因为更便宜的能量会被用于更多机器、更多工厂、更多场景。
AI也一样。
单位推理成本下降,不必然意味着总推理量下降。
它可能意味着:
cost/task成本/任务↓
number of tasks任务数量↑↑
total inference推理总量↑
total compute计算总量↑
所以,“模型越来越便宜”和“数据中心越来越庞大”,互为因果。
尤其是Agent出现之后。
聊天产品的基本模式是:
人问一次,AI答一次。
它天然受人类注意力约束。
一个人每天不可能发十万条prompt。
Agent改变的,是这个约束。
它把:
Human attention→inference
变成:
Machine loop→inference
一个目标,可能触发数百次推理。
一次任务,可能触发数千次工具调用。
一个系统,可能让大量Agent在后台持续检查、比对、验证、重试、监控和升级。
所以Agent经济真正需要的,不只是“模型变聪明”。
还需要:
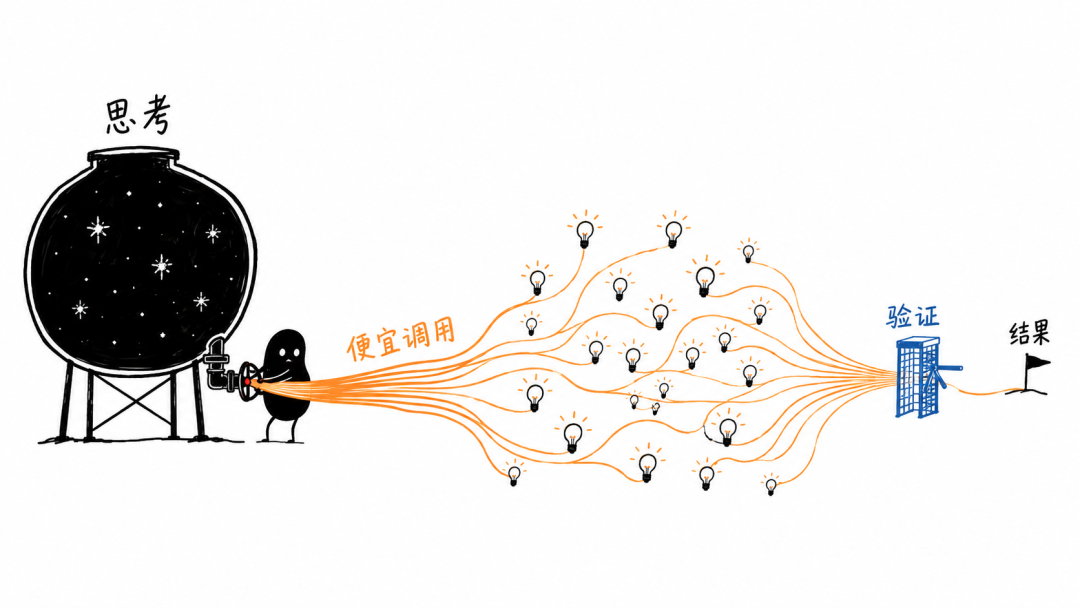
单位认知便宜到可以浪费。
这句话听起来有点反常识。
但所有基础设施都会经历这个阶段。
存储便宜到人们开始保存几乎一切。
带宽便宜到视频成为默认媒介。
计算便宜到软件开始出现在每个物体里。
AI真正大规模爆发的标志,可能也是同一个:
它不再是一种必须精打细算调用的服务。
它开始成为一种可以被后台挥霍的资源。
07真正会爆发的,是过去没人值得花钱思考的问题
我们今天讨论AI,仍然经常问:
它能替代多少人工?
它可能严重低估了成本曲线的影响。
存储价格下降十个数量级之后,人类没有只是“更便宜地保存原有文件”。我现在都还能记起来,2000年时我想用光盘保存我所有喜欢的影片、照片、然后用纸包起来埋在地下的这个想法。
人类开始保存照片、聊天记录、短视频、日志、版本历史、位置轨迹、用户行为。
很多今天看起来理所当然的产品,在过去不是“没有人想到”。
而是根本不值得做。
如果保存、复制、搜索、传输一条信息太贵,那么永久保存几十亿人的日常生活,本身就是一个荒谬的商业命题。
认知成本下降也会发生同样的事。
如果一次机器思考只值0.001元,我们会让它去思考哪些今天根本没人会花钱想的问题?
也许是每个客户都有一份持续更新的研究。
也许是每一条销售线索都被长期跟踪。
也许是每行代码都被持续review。
也许是每篇论文都被多个Agent交叉检查。
也许是每个学生都拥有连续数年的私人tutor。
也许是每一项重要决策,都有不止一个独立的第二意见。
也许是一个组织面对每次外部变化时,都有成百上千个后台Agent在重新计算它意味着什么。
这些需求今天看起来夸张。
就像几十年前,“为什么要保存所有照片”一样。
但当某种资源穿过成本阈值,需求的边界会自己移动。
08真正值得争夺的,是部署前沿
因此,理解AI不能只看一条frontier边界。
第一条是Capability Frontier:
AI最强能做到什么?
第二条是Cost Frontier:
做到同样的能力,要花多少钱?
第三条则是Deployment Frontier:
什么能力已经足够便宜、足够可靠、足够容易集成,以至于值得大规模部署?
第三条才真正决定产业格局。
很多能力,已经足够惊艳。
但还不够可靠。
很多能力,已经足够便宜。
但没有上下文、工具权限、数据入口和验证机制。
很多产品,已经有模型。
但没有工作流、责任边界和用户信任。
这就是为什么未来价值不会简单停留在“最强模型”。
它会越来越多地迁移到模型的互补品上。
当标准化认知能力越来越接近归零,哪些东西会突然变得更贵?
09思考会不会成为下一种基础设施?
Epoch这篇报告自己也承认,benchmark不等于真实工作;不同能力并不天然可比;所谓“Price of Thought”,更像一个由多类benchmark串起来的早期价格指数。
但它已经让一个过去很模糊的问题,第一次出现了轮廓。
也许未来真正重要的指标,不会是$/token。
甚至不会只是$/capability。
而会是:
Price of Verified Useful Work。
获得一单位可验证、有用、可进入现实流程的机器工作,究竟要多少钱?
如果有一天,这条曲线也开始持续向下。
那么AI的临界点,就是:
它什么时候便宜到,我们不再需要决定“这件事值不值得让AI想一下”。
到那时,思考或许会像今天的CPU cycle、存储和带宽一样。
大量存在于后台。
持续被调用。
便宜到几乎不可见。
而世界真正的变化,才刚刚开始。