本文来自微信公众号: 未尽研究 ,作者:周健工
算电协同是一个技术问题,也是一个经济问题。它需要端到端的“极致协同优化”。
算力网、新型电网与新一代通信网,共同构成智能经济与智能社会建设的重要底座。但这几张网并不是孤立发展的。进入“十五五”,算电协同需要走向端到端的系统工程。
这种协同同时发生在空间与时间尺度上。算电协同正在从芯片、机架、数据中心扩展到电网,但由于建设与迭代周期错配,算电协同在设计之初就需要考虑其扩展性。
所有这些努力,最终都指向“每瓦价值”这一共同目标。
AI应用扩展、算力扩展、电力扩展
AI的扩展,带来了算力的扩展。到了今年二季度,中国日均token调用量已经达到500万亿,增速陡峭,是去年同期的16倍。自7月以来,国内一波“好用”的开源模型,推动了智谱、DeepSeek、Kimi等的ARR显著增长,日均token调用量仍在高速增长。
算力的扩展,又带来了电力的扩展。今年5月,国家能源局曾提出,在“十五五”时期,全国算力用电量年均新增1000亿千瓦时以上,到2030年预计达8000亿千瓦时,占全社会用电量6%左右。这相当于较2025年的1700亿千瓦时增长了近4倍。
这一轮算力与电力需求的扩展,正在越来越多地由智能体驱动。国家提出到2027年,智能体等应用普及率超过70%,这一指标到2030年更是要达到90%。
在ChatGPT发布半年多后,未尽研究曾根据当时的AI应用趋势,估算2030年国内智算规模将达到近6000EFLOPS(FP16精度,相当于FP32下3000EFLOPS)。但到了今年,国家“十五五计划”,提出“适度超前”建设AI算力,到2030年达到9800EFLOPS,较2025年增长超5倍。
但智能体经济对电力的需求,并不仅仅体现在规模的长期增长上,更体现在负荷的瞬时波动上。
训练需要让大规模算力长期稳定运行并保持较高的利用率;从文本对话到图片、视频生成,推理的单位任务的算力需求呈数量级上升。相比之下,智能体带来的最大变化,在于它需要根据任务复杂度自主决定调用模型、工具和外部数据的次数。对于电力系统而言,这是更加动态、更加难以预测的负荷。
空间与时间的尺度
这些变化,推动算电协同沿着芯片、机架、数据中心和电网等四个空间尺度逐层扩展。“AI工厂”也因此正在成为功率密度增长最快的“新物种”。
英伟达的GPU早已突破kW级别。2026年的VR200约2200W,下一代产品功耗还可能进一步翻倍。按照长期演进趋势,10年后单芯片功耗甚至可能进入15kW级别。这种功率密度的提升,还会沿着算电协同四个尺度扩展方向继续放大。单机架正在进入MW级别,而数据中心正在进入GW级别。
这意味着在不同空间尺度下,“AI工厂”都将面临严峻的“散热墙”瓶颈。如果散热能力跟不上功率密度增长,关键IT设备就无法长期以设计功率运行,最终限制整个AI工厂实际能够生产的Token速度与总量。
在这一扩展过程中,电力瓶颈客观存在。中国本土芯片在能效上与美国先进芯片仍存在差距。如果说“电力换算力”,那么“散热墙”与推理经济性等问题,就更加不容忽视。
而且,受到风光新能源等分布不均,以及绿电占比的约束,“AI工厂”存在明显的空间集聚效应。这使得电力总量上的优势,并不总是对应着负荷所在地的局部供电能力。算力越集中,对输配电能力和局部电网强度的要求越高;负荷波动越大,对电力系统峰值供给和动态调节能力的要求也越高。
算电协同也不等于找一个电价最低的地方建数据中心。就目前而言,电费在AI数据中心的总成本比重并不高。中国西部地区的低电价,能够缓冲硬件能效劣势,但与美国德克萨斯相比,这一优势并不显著。最终能否形成算力成本优势,还取决于系统采购价、同任务能耗和有效吞吐量。
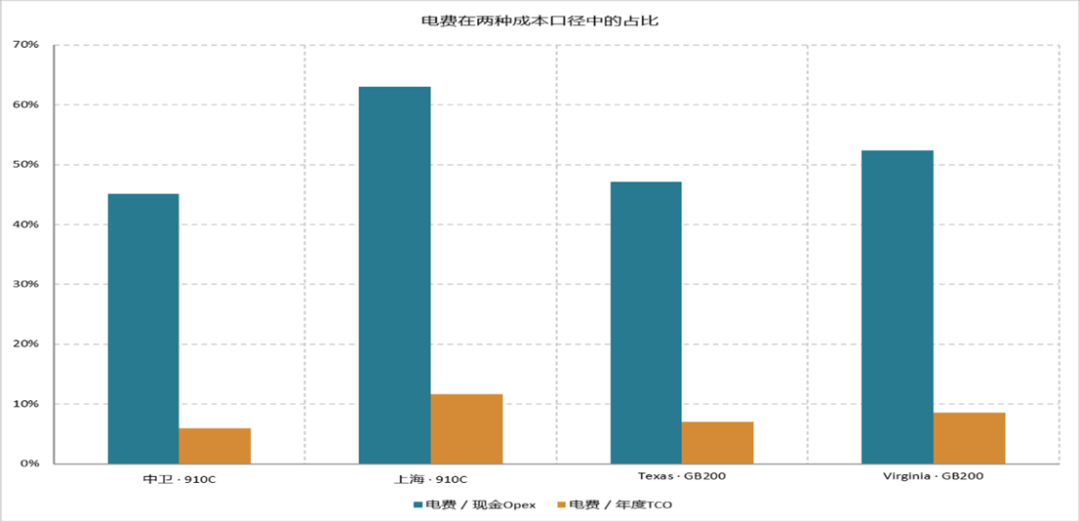
时间才是最大的成本。电力已经从一种成本要素,升级为算力能否释放的物理前提。每年昂贵的IT设备折旧成本,往往远高于电费。OpenAI交由甲骨文建设的2.45GW数据中心,最近卡死在电力环节,大概率将延期,也就意味着OpenAI无法将大量用户需求,及时地转化为现金流。
中国适度超前发展电力,但算力价值的充分释放,同样受制于电力建设时间窗口的约束。目前,模型竞争正在以数周为单位迭代,华为与阿里巴巴等都开始芯片的一年一迭代,但是,电网扩容可能仍然需要四到八年。这意味着电力基础设施一直在追赶算力生态的建设,而每一次算力侧的迭代,都会不同程度地影响电力侧的设计。
这意味着,算电协同也是时间尺度上的协同。它必须是可扩展的,以避免时间周期错配对“AI工厂”推理经济性的影响。
算电协同目标是每瓦价值
空间与时间尺度上的扩展,导致了系统优化设计的边界不断扩展。黄仁勋认为英伟达提供算力的经济优势,正在于“极致协同设计”(Extreme Codesign)。
计算、存储、网络、功耗、散热,已经耦合成更加紧密的系统,运行调度需要综合考虑。此前,黄仁勋提出Scale up与Scale Out,覆盖了GPU间互联与机架间互联;去年又提出Scale Across,将系统的优化设计延伸至集群之间;今年,英伟达又创造了Scale In的概念,将过去位于AI计算域外围的网卡、CPU、DPU、存储,也纳入极致协同设计。
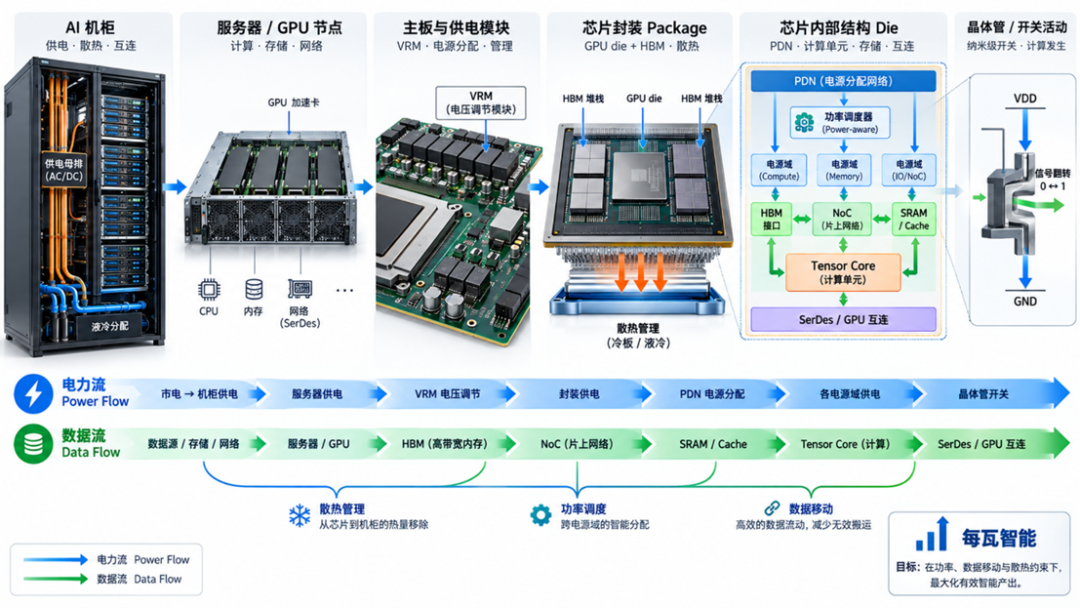
在一个AI机架内部,算电协同就无处不在。电力在服务器内部,就需要VRM电压调节与PDM电源分配。行业正在步入800V高压直流(HVDC)时代。在去年的OCP峰会上,台达电子就推算,如果单个机架的功率达到1MW,那么,如果继续使用传统的54V供电,电流将达到近2万安培,这是极其巨大的电流,会带来线路损耗、散热和短路等安全问题。
围绕800V HVDC,包括通用接口、液冷系统、储能系统,整个园区供电架构都需要同步协同设计,以应对动态功率波动、电压调节,以及电网响应和无功功率支撑。中国七部委《促进数字化绿色化协同转型发展实施方案》也提出,要探索算力设施800V高压直流供电架构,推动超百千瓦单机柜部署。
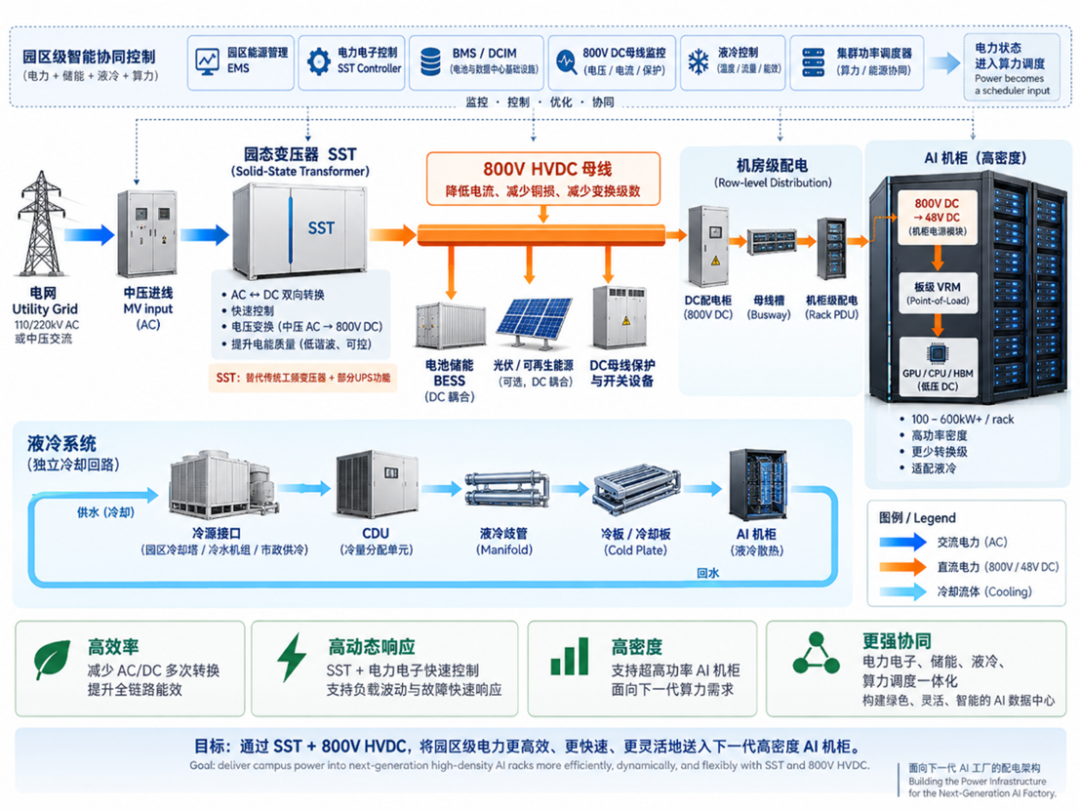
所有这些算电协同的努力,一方面是尝试在相同的供电条件下部署更多算力,另一方面则是探索让这些算力更稳定、更充分地运行,尽可能减少供电、散热、通信和调度带来的损耗。最终,衡量算电协同成效的,是单位电力所创造的经济价值。
端到端协同
为了提升单位电力的经济价值,英伟达与谷歌都将能源视为AI技术栈的重要底座。
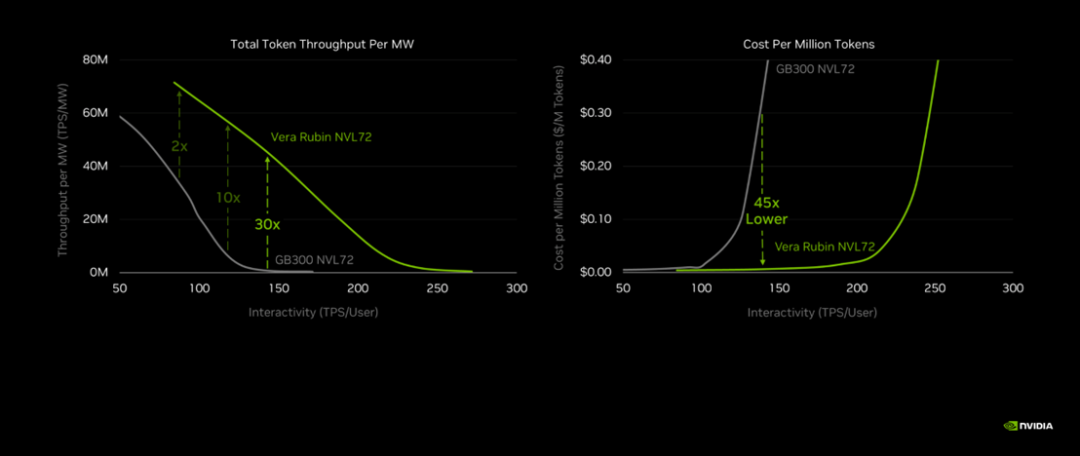
黄仁勋提出的“极致协同设计”,正是将整个数据中心作为计算单元,而不仅仅是单台GPU服务器。计算、存储、网络、电力、冷却、CUDA等,横向贯通。在智能体编程这一高交互性、低时延场景下,Vera Rubin NVL72的单位兆瓦Token吞吐量最高可达到当前主力算力GB300 NVL72的30倍;每百万Token的成本最高可降至约1/45。
与英伟达相比,谷歌的协同还进一步延伸到了模型层与应用层,因此显得更为纵向立体。此前,市场曾担心AI的出现会颠覆谷歌搜索的商业模式。摩根士丹利曾测算,在一定的AI渗透率和回答长度假设下,谷歌每年新增的AI计算成本可能达到60亿美元。
但通过TPU、网络、数据中心等全栈协同,以及模型轻量化与智能路由机制,谷歌的核心AI响应成本持续下降。谷歌披露,2026年一季度公司核心AI响应成本已下降超过30%。与此同时,AI Overviews与AI Mode等业务形态也扩展了新的货币化路径。
中国正在把这种端到端的极致协同设计,进一步延伸到国家层面。从发电侧、电网侧,到数据中心、机架,再到先进芯片,甚至延伸至后摩尔时代的晶体管与计算架构。它覆盖了AI计算所消耗的每一度电如何最终转化为有效计算的整个链条。
这也将提高新能源消纳、源网荷储和绿电直连的经济价值,推动这些已经探索多年的机制加快落地。归根结底,这是要把电力和数据送到计算发生的地方。
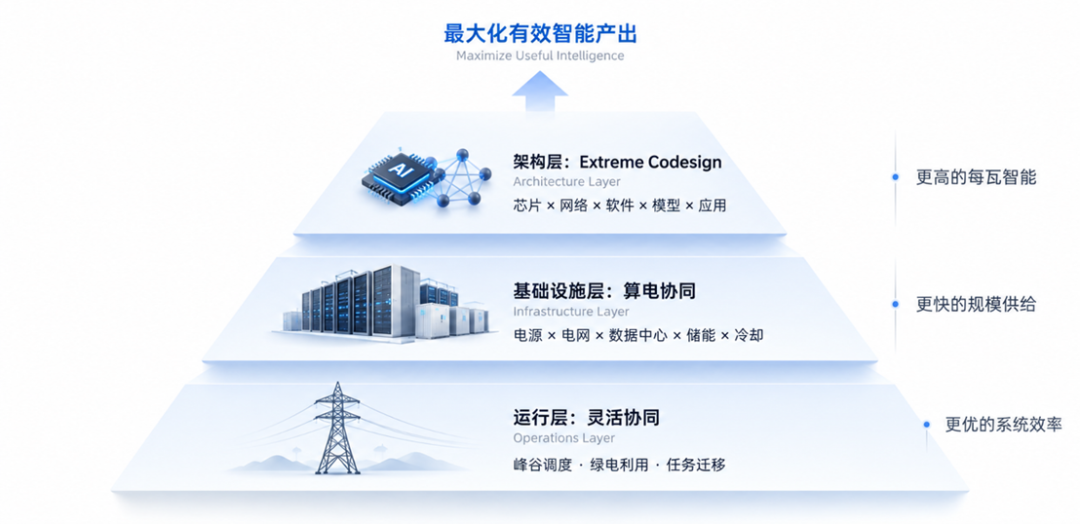
中国与美国对AI的竞争,因为资源禀赋不同,导致优化方向不同。但是,这场竞争最终殊途同归,都是对每瓦智能与每瓦价值的竞争。没有谁可以只靠短期的资源优势“躺赢”。
--
(根据2026云栖大会主题演讲“算电协同端到端”整理,有调整)