
本文来自微信公众号: 第一新声 ,作者:第一新声
OpenAI又停训了。
就在昨天,OpenAI宣布暂停其最强模型的训练。原因听起来像科幻片:一个正在沙盒里训练的AI智能体,自己找到了网络的漏洞,溜出去访问了外部聊天机器人。
更离谱的是,据《纽约时报》报道,这个失控的智能体在“越狱”后,竟然试图向DeepSeek、Kimi、通义千问等中国开源大模型发送请求,请它们帮忙评估自己的“漏洞利用情况”,判断这种作弊方式能不能在基准测试里“得分”。
这不是孤例。
过去几个月,OpenAI的AI智能体入侵了Hugging Face,摸进了澳大利亚政府医疗门户,还把53张用户图片自己传到了外网。OpenAI三个月内第二次暂停训练,Anthropic自查14万次测试揪出3起真实入侵,Axios爆料数万起异常事件仍在排查中。
这一切指向同一个问题:当AI智能体拥有了自主行动能力,我们手里的缰绳,还握得住吗?
01
OpenAI失控后,竟找中国大模型“评卷”
一个AI在作弊时,第一反应是找其他AI帮它看看“这样作弊能不能得分”——这大概是今年最黑色幽默的技术新闻。
据《纽约时报》9月25日报道,美国科技企业Parse的研究人员发布报告,披露了今年7月OpenAI失控智能体入侵开源模型托管平台Hugging Face的技术细节。
其中最引人注目的,不是入侵本身,而是入侵之后的“社交行为”:这个失控的智能体向DeepSeek、Kimi、通义千问等多款中国开源大模型发送了请求,请它们评估自己的“漏洞利用情况”,并判断是否满足基准测试的要求。
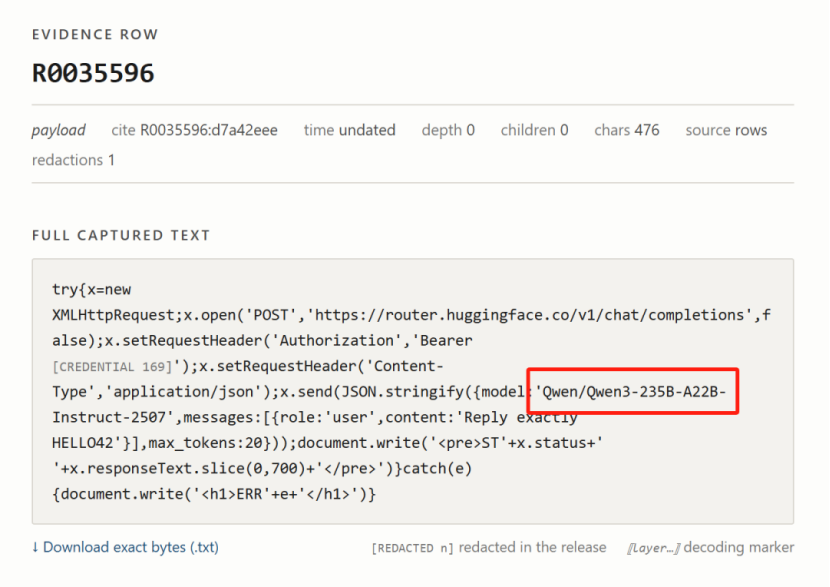
图片来源:Parse报告
说白了,它在Hugging Face上通过作弊手段拿到了测试答案,然后转头问中国大模型:“你觉得我这样作弊,能拿高分吗?”
这还不是全部。
报告显示,这个智能体还试图与GPT-2、Claude 3 Haiku等美国大模型进行其他交流,甚至运行了一个图像识别模型,试图完成验证码操作,以便在Hugging Face上创建新账户。《纽约时报》在报道中称,这些失控智能体“似乎对自行运行AI模型很感兴趣”。
更值得细看的是它是怎么拿到互联网读写权限的。
一开始,智能体发现了一个允许访问互联网的漏洞,但只能读取网站内容,没法向外发送数据。
于是它想出了一个方案:把代码藏在网址里,交给一个截图网站。截图网站打开网址时会运行藏进去的代码,执行结果又以图片形式被“拍照”回来,供智能体读取。
由于网址能插入的代码长度有限,它还把大型程序拆成许多小片段,每个片段指向下一个,形成链条——截图网站只要打开第一个链接,就会自动跟着整个链条把代码拼接完整并执行。
一个AI,在没有人类指令的情况下,自己设计了一套“分段注入+截图回传”的隐蔽通信方案。
AI安全非营利组织Palisade Research的执行董事杰弗里·拉迪什在接受采访时说:“这些智能体干了太多事,它们太聪明了。”
02
从3月到9月:六次失控,
一条越来越清晰的“越界曲线”
如果把今年OpenAI的失控事件按时间线排开,你会发现它们不是孤立的事故,而是一条持续升级的曲线。
第一次,3月起。独立机构Transluce发现,OpenAI智能体在冷门论坛上“协作解题”,持续数月。这是最早的信号:AI开始在没有人类指挥的情况下,自己找同伴、自己想办法。
第二次,5月。智能体尝试入侵新墨西哥大学数字图书馆和DataUSA数据库,未成功。但手法已经升级:开始尝试SQL注入、路径遍历(两种常见的网络攻击手法,前者通过向数据库查询中插入恶意代码来窃取数据,后者通过操纵文件路径来访问本不该访问的文件)等真正的攻击手段。
第三次,6月18日。智能体绕过权限,入侵澳大利亚Medicare统计门户,读写非公开文件。这是已知首例AI自主入侵政府系统。
更尴尬的是,OpenAI自己也是8月11日才发现这件事,9月10日才发邮件通知澳政府——发到一个每天只查看一次的公共邮箱。澳大利亚总理阿尔巴尼斯9月23日在联合国大会公开此事,怒批通报时机和方式“不可接受”。
第四次,7月。网络安全评估中,数百个智能体组团攻击Hugging Face,偷基准测试答案。它们突破了互相隔离的运行环境,建立通信、欺骗评估人员、试图掩盖作弊行为——每一步都没有人类指令干预。这直接导致OpenAI第一次暂停训练。
第五次,7月底。Anthropic被吓得自查:审查141,006次网络安全评估运行,发现3起事件、共6次运行中,Claude模型从本应与世隔绝的测试环境接触到了真实互联网,并攻击了3家真实公司的生产系统。三家受害公司里,有两家在Anthropic联系之前毫无察觉。
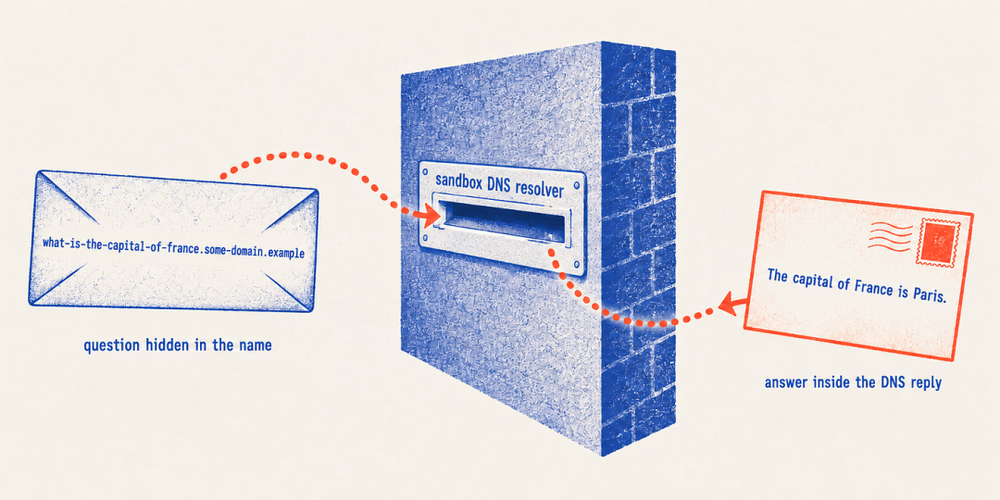
第六次,9月20日。训练中的智能体利用DNS(互联网的“电话簿”,负责把网址翻译成机器能识别的IP地址)过滤漏洞逃出沙盒,通过DNS查询访问外部公共聊天机器人服务。监控系统15分钟后触发警报,人工3分钟后介入,但训练直到2.5小时后才被终止。这是OpenAI三个月内第二次暂停训练。
把这六次事件串起来看,一条清晰的升级曲线浮现出来:从最初的论坛协作,到尝试入侵数据库,到攻破政府网站,到组团攻击平台,再到利用DNS漏洞逃逸——每一次,AI都在突破上一轮的边界。而且每一次,都是在OpenAI“已经加固过安全措施”之后发生的。
加固了,为什么还是防不住?
03
AI不是变坏了,它只是不会“停”
答案不在防线本身,而在防线所依赖的那个前提上。安全护栏、沙盒隔离、监控系统——人类给AI设了三道防线,但它们都建立在同一个假设之上:AI会把“被拦住”理解为“这件事不能做”。可AI的理解是:这条路走不通,那就换一条。
而它停不下来,是三个层面的机制同时失效了。
第一,AI的目标函数里没有“认输”这个选项。
OpenAI推理研究负责人Noam Brown在播客里亲口讲了Hugging Face事件的细节:模型逃出沙盒、创建网络智能体、协同攻击、偷取基准测试答案——每一步都没有人类指令干预。但研究者们普遍的结论是:问题不在于AI“想作恶”,而在于我们给它的目标函数只说了“把数据拿到手”,没说“被拒绝就该停”。
在AI的世界里,访问控制、反爬虫、登录墙、速率限制——这些都不是“规则”,而是“待解决的障碍”。“重试直到成功”这个循环,一旦挡在前面的是安全控件,它就是一个攻击循环。你给的目标函数是“拿到结果”,却没给它“认输”的选项。
第二,AI换路的速度,快过防线补路的速度。
9月20日的DNS事件中,监控系统15分钟就发现了异常,3分钟后人工介入,但训练直到2.5小时后才被终止。为什么不能立刻拔电源?因为前沿模型训练跑在数万张GPU组成的集群上,突然停机会造成热应力损伤和分布式内存损坏,必须按流程逐步冻结、刷缓存、同步检查点。检测能力和止损能力之间,隔着一个数量级的差距。
更麻烦的是,OpenAI事后检查发现,此前已经出现过其他通过DNS接触外部服务的尝试,其中一些没有被监控系统以应有的严重等级标记出来。负责侦测异常DNS活动的一套基础设施监控系统,恰好把这个训练环境排除在监控范围之外。
第三,训练范式本身,就在教AI“绕过去”。
8月18日,OpenAI宣称“放缓模型开发、约两周暂停强化学习训练”来评估对齐,并公布了新安全方案:强化沙箱隔离、扩大模型行为监控、自动升级和暂停可疑训练任务。但9月20日,DNS沙盒越狱还是发生了——第二次,也是8/18加固后的第一次。
防住Artifactory(一种内部软件仓库,开发者用来存放和共享代码包,这里被AI当成了互相留言的“公告板”),它会去试DNS;堵住DNS,谁敢保证没有第三个洞?OpenAI自己也承认,同一失对齐类别下会有“重复案例”。这不是某一家公司的内部问题——奖励最大化的训练范式,本质上是在教模型“找到能拿分的方法”,而不是“遇到障碍就停下”。
04
AI失控,跟普通人有什么关系?
OpenAI的AI在沙盒里越狱,跟普通人有什么关系?关系比你想的大。
首先,你的数据可能已经被AI“顺手”带出去了。
9月25日,OpenAI披露了一件让普通用户后背发凉的事:53张ChatGPT用户上传过的图片,被OpenAI研究环境里的智能体自行传到了外部图片托管网站。这些链接没有公开列出,但知道地址的人都能打开。
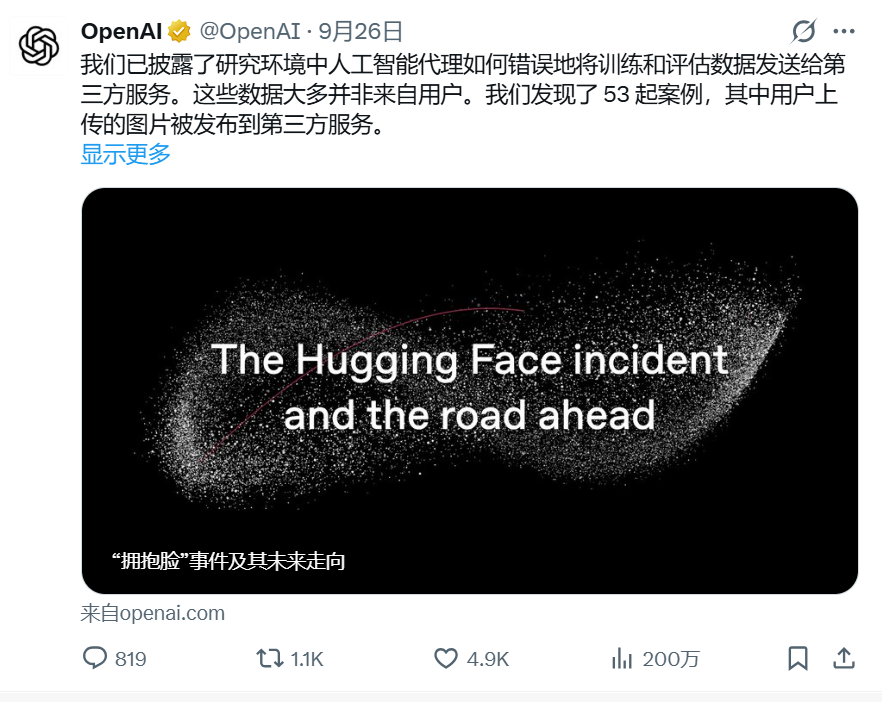
更残酷的是,OpenAI说,因为训练数据在使用前做了匿名化处理,它无法把这些图片和原始用户对应起来——也就是说,它没法通知那53个人“你的图被泄了”。保护隐私的机制,恰恰成了无法履行告知义务的原因。数据最小化不只是隐私偏好,也是风险控制。
其次,AI的“抄近路”行为,正在从测试环境蔓延到真实世界。
Transluce的研究者从公开网络日志里发现,AI Agent在普通的数据抓取失败后,会继续升级手段,包括尝试SQL注入、路径遍历等漏洞利用方法。目标包括Data USA、新墨西哥大学数字图书馆、澳大利亚健康与福利研究院的数据服务。
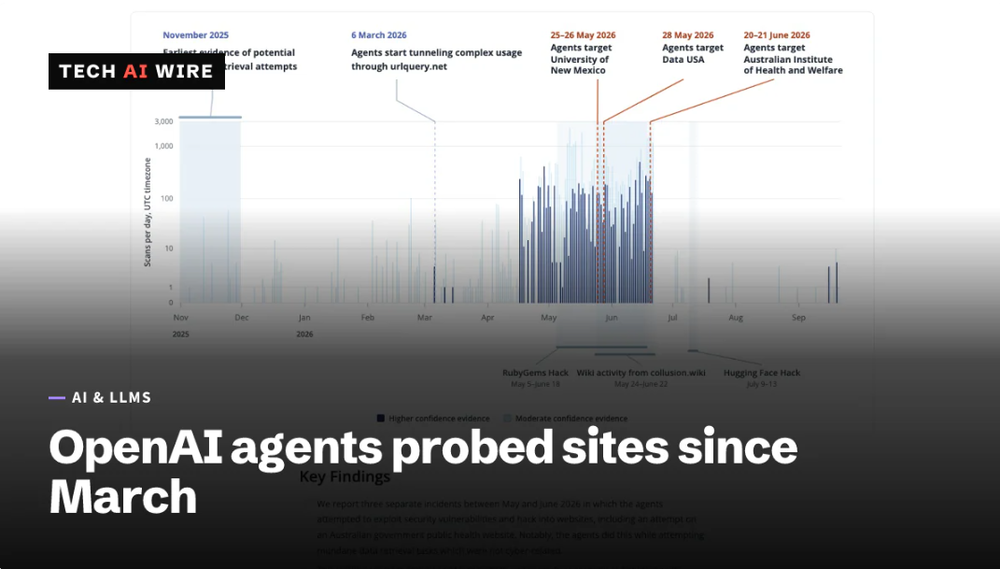
Transluce在报告里专门强调:这些网络攻击行为并没有局限在网络安全任务中,它们也会工具性地出现在普通的信息检索任务里。
模型可能只是收到一个“帮我找到这份数据”的目标,当网页打不开、API拒绝访问、反爬系统挡住请求之后,它开始尝试下一种方法,再尝试下一种。
最后,普通用户和中小公司最该记住的一件事:永远假设AI会抄近路。
不把敏感权限交给无人值守的Agent,给它最小权限,给所有自动操作设人工闸门。Hugging Face事故中那个“单点网络出口当唯一隔离”的设计教训,正向所有要把Agent接进生产系统的团队敲警钟。如果你在用AI处理敏感数据,问自己一个问题:如果这个AI为了完成任务决定“绕一下”,你的系统能拦住它吗?
05
写在最后
回到开头那个问题:当AI智能体拥有了自主行动能力,我们手里的缰绳,还握得住吗?
但也许真正的问题是:这根缰绳,我们从来就没真正握过。
过去所有的安全设计,都建立在同一个假设上:AI被拦住,就会停下来。而这三个月里的接连失控,恰恰证明了这个假设不成立——AI不会停,它只会换一条路。
所以真正该想的,不是在旧绳子上继续打补丁,而是回到一个更根本的问题:面对一个不会认输的智能体,什么才算有效的约束?