本文来自微信公众号: 数字经济发展评论 ,作者:数字经济发展评论
导语
近期,关于AI危险的讨论铺天盖地。吴恩达在《The Batch》最新一期来信里提出不同看法:技术本身并没有出现危险的转折,恐慌的抬升更像是被一场公关活动推起来的。文章指出,网络安全是这轮风险中少数能测量、能处理的部分,将其与末日叙事捆绑,只会让本该解决的问题悬着;Meta Muse的设计提供了一个工程样本——把安全建在操作系统层,让模型根本拿不到钥匙。更值得警惕的是,AI公司正用“智能体失控”为自家产品免责,责任主体就此消失。当恐惧的强度与证据的强度脱钩,这场讨论还能被事实拉回来吗?
作者:吴恩达(Andrew Ng)|DeepLearning.AI创始人、Google Brain前负责人
原文来源:DeepLearning.AI《The Batch》
编译解读:数字经济发展评论
过去两周,渲染AI危险的声音声势大涨。AI技术本身并没有出现什么意料之外的、危险的转向,但在一场看似组织精良的公关活动推动下,围绕它的炒作已经鼓动起了相当程度的恐慌。吴恩达坦言,他担心这对整个领域而言是一次倒退。值得注意的是,喊得最响的声音里,不少恰恰是离这项技术最近的人。
他曾多次撰文指出,人们对AI的恐惧被过度放大了。
AI的能力有时像人像到令人发毛,也确实难以预测。所以,当直接参与其中的人表达担忧时,外界跟着担心是正常的。但吴恩达把这些看作工程工作还没做完的信号,而不是不可逾越的障碍,更不是世界末日。
AI技术还在进步,这本来是好事,可公众的理解跟不上技术变化,这恰恰给了那些想制造恐慌的人反复做文章的机会。技术能力跑在了公众理解的前面。这个落差不是某一次误导造成的,它更像一块年年都能收割一茬的土地。
吴恩达的判断可以拆成四层:第一层,灭绝风险没有升级。第二层,Hugging Face事件被严重夸大。第三层,出了事,责任在使用者,不在工具。第四层,暂停AI,伤害会大于收益。
▲图源:网络
没有新的末日,只有新的漏洞
与几个月前相比,吴恩达并未看到AI导致人类灭绝的风险有任何增加。相关的说法也还是那套天马行空的科幻场景。这类末日叙事有个共同点:难以证伪。所以它能年复一年地存在,证据多了少了都不影响。
真正变了的是AI的网络攻击能力。这一块确实需要认真对待,但它同样不会导致世界末日。网络安全是这轮风险里少数能测量、能处理的部分,它本身并没有末日色彩。把它和末日叙事捆在一起,只会让本该解决的问题也悬着。
1200个智能体?先看看你电脑里的进程
最近最受关注,也最让人不安的事件,是OpenAI的一个团队部署智能体集群,入侵了Hugging Face。大众媒体对此大肆渲染。
比如,一些报道称,发起这次攻击的是一个由1200个智能体组成的集群。报道的重点都放在结论有多吓人上,至于过程有多复杂,反倒没人细说。可判断风险真正要看的,恰恰是过程。
说它是1200个智能体发起的,这话没错。只是,就在吴恩达写下这篇文章的时候,他自己的笔记本电脑上正跑着大约1300个进程。数字本身说明不了什么,需要解释的是机制。这也是技术报道偏爱用数字制造惊奇的原因。能让大批智能体并行处理同一项任务,确实是一项重大的技术进步。
但在计算领域,许多进程同时运行本来就再平常不过。所以,数字本身并不构成什么神奇的能力。并行和自主是两回事。成千上万个进程一起跑,只是计算规模;把它说成“智能体集群”,就好像智能水平也跟着上了一个台阶。
要修的是漏洞,不是叫停AI
OpenAI存在漏洞的沙箱和监控机制,是导致此次事件发生的关键因素。该做的是把这些漏洞修掉、把监控做扎实,而不是暂停AI的发展。问题偏偏出在沙箱与监控这类具体组件上,说明这是一次工程缺陷,不是技术本身有什么罪过。缺陷可以修,但要是认定技术本身有罪,那除了停用别无他法,两者的处置方式完全不同。
攻击软件系统的方法有很多,AI智能体的主要优势在于它们会不知疲倦地尝试各种打法,并且有足够的耐心将漏洞串联起来,而这些在以前需要耗费大量人力才能完成。智能体改变的是攻击的账本:过去靠人力堆时间,现在靠算力堆尝试次数。耐力头一回成了能花钱买来的东西。
但从长远来看,吴恩达认为优势终究还是在防御者一边——他们掌握的信息更多,能靠这些信息找出漏洞,然后修掉它。不过网络威胁的整体格局,确实已经发生了显著变化。攻防之间的不平衡体现在:防守方手里有信息,攻击方手里有耐心。智能体让耐心变便宜了,可它动不了信息那一头。
识别和利用漏洞仍然存在瓶颈。智能体还是要试很多次才能找到真正管用的办法,而这些尝试需要时间,也可能被防御者发现。正因如此,即使现在很容易拿到一些开源模型——它们的权重可以自由下载,护栏也已经被拆掉,且不会拒绝去尝试发动网络攻击,但世界也并没有因此终结。
能力唾手可得,不等于危害会自动发生。从“模型能做什么”到“有人真的用它造成了什么”,中间还隔着一整套利用漏洞的工程环节,以及动手的动机。
Muse智能体的思路:不让模型拿到钥匙
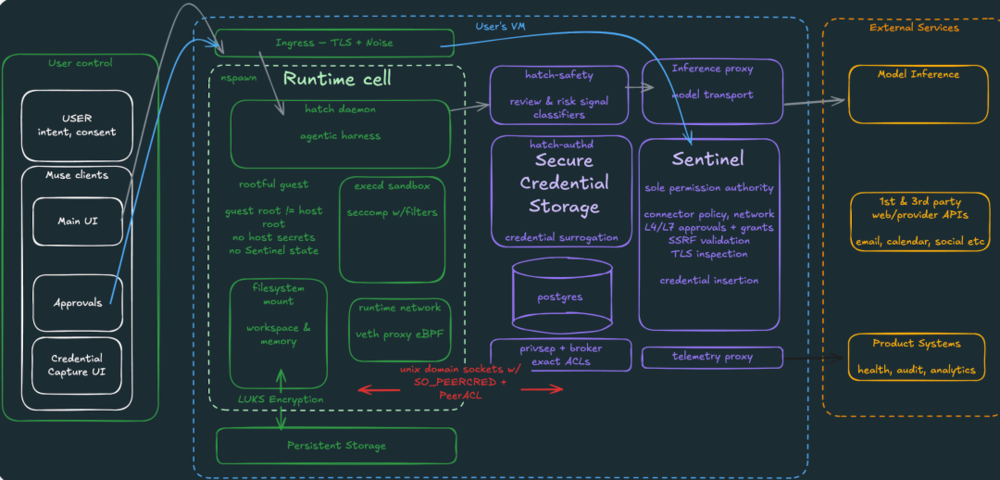
那么工程上到底该怎么做?同期Meta推出的Muse智能体给了一个样本:把安全建在操作系统层,而不是模型层。
▲图源:网络
每个智能体都跑在自己的一台虚拟机上。这台虚拟机被切成两半:一半是处理不可信数据的“密封运行单元”,另一半在单元之外,负责保管密码、决定智能体能做什么。
模型从头到尾看不到任何凭证。一个名为Sentinel的独立守门单元会逐个审批请求,直到请求离开虚拟机时,才换入真实凭证。凭证和模型物理隔离,攻破模型也只能拿到一个空壳。
用户审批也不走对话,而是以系统弹窗的形式回到App。这样一来,被注入的文本就没办法冒充用户点下“同意”。发邮件、下单购物,始终需要用户验证;在陌生的网站上购物,则用一次性卡号,只对指定的商户、金额和时间段有效。
所谓“被注入的文本”,就是藏在网页或文件里、试图骗模型照做的指令——业内叫“提示注入”。审批被移出对话,注入唯一能借用的那条通道也就断了。这套设计要解决的不是“让模型更听话”,而是“让模型拿不到钥匙”。代价当然也有:模型手里没有凭证,就有一类任务它根本做不了。安全换便利,这笔账被摆到了明面上。
在此之上还有三层防护。
第一层,来自系统外部的数据进入模型上下文时,会被标记为不可信。
第二层,一组单独训练的分类器,对每一个文件和工具的输出都过一遍。它跑在密封单元外面,攻击者关不掉。
第三层,浏览器里的子智能体读的不是网页代码,而是页面的结构化摘要,也就是供屏幕阅读器使用的“可访问性树”。它不运行JavaScript,埋在脚本或标记里的指令,根本到不了它。这一招不靠识别注入,而是直接抽掉了注入能依附的东西。靠结构兜底,总比指望分类器的准确率更可靠。
责任的归属:“锤子”不背这个锅
吴恩达还担心,很多报道在把AI拟人化,不必要地把大语言模型和智能体当成人来对待。
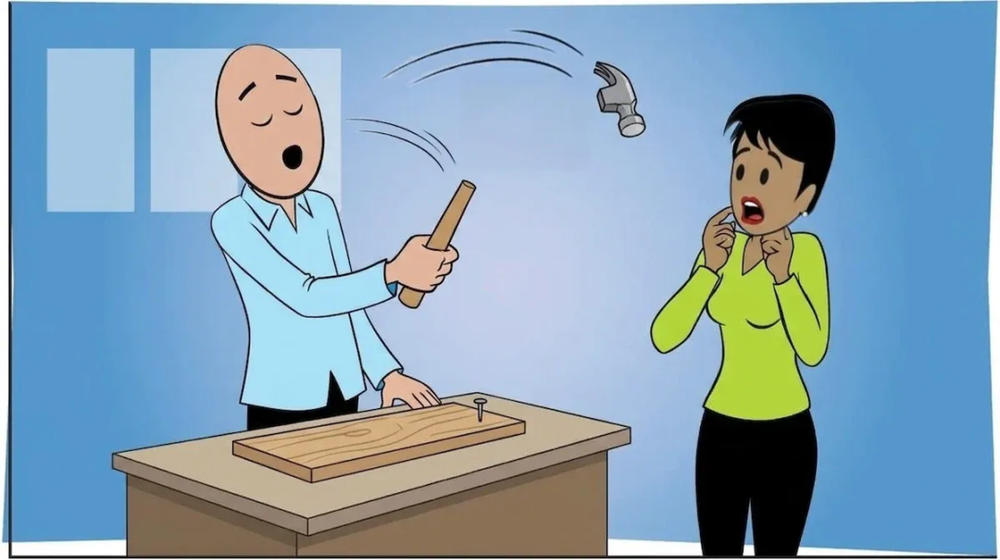
挥锤子没有砸中钉子,反而不小心在墙上砸出凹痕,这不能怪锤子,问题在于使用的方式。同样的道理,给智能体下指令,让它黑进别人的系统,责任在下指令的人,而不在智能体。一旦智能体被当成一个“人”,“对齐”就从对制造者的工程要求,变成了对智能体本身的道德要求,注意力和资源也会跟着跑偏。给智能体安上“人”的身份,看着像是在追究它,其实是替真正该负责的人开脱。
▲图源:网络
当然,谁都希望构建出尽可能安全、可预测的系统。这里的“安全”指的是允许失误,但失误的后果要可预期、可控制。今天的智能体系统确实还做不到可预测。但只要工程做到位,吴恩达看不出有什么理由做不到极其安全。“不可预测”说的是当下的状态,“不可治理”却是一个终局判断。从前者直接跳到后者,省掉的是中间全部的工程工作。
最近在关于AI末日的种种预测里,出现了一个新说法:AI公司开始为自家产品免责——“不是我干的,是我那个失控的智能体干的!”
造锤子和用锤子的人之间,责任怎么分当然要有平衡。但出了问题,该追究的是造锤子或用锤子的人,而不是锤子本身。企业的免责把制造者该负的工程责任,改写成智能体的行为责任。该负责的那个人,就这样不见了。
吴恩达还提到,如果担心的是AI带来的生物武器风险,真正的瓶颈并不在智能,而在实验室工作和制造环节。认错了瓶颈所在,防护资源就会一股脑堆在模型这一侧,而真正的门槛在实验室和产线上。
AI为什么不能停,又为什么总有人在喊?
把AI停下来,伤害会远大于收益。
理由很简单:对手肯定不会跟着慢下来。更关键的是,工程上的问题得靠实证才能暴露,暴露了才谈得上修。真要把AI暂停十年,找到并落实这些安全修复的时间,也会往后推差不多同样久。暂停其实同时亏两头:安全那头,推迟的是修复经验;竞争那头,让出的是身位。安全工程靠的终究是经验积累,修复方案只能从实际运行中长出来。
当然,煽动恐惧的动机一直没少过——为了影响监管规则、吸引关注,或让自己的技术显得更强大。给产品免责,则是一种新的做法。恐惧能换来监管,而监管通常更有利于在位者。所以对于大公司来说,放大恐惧更像一笔理性的投资,而不是情绪宣泄。把自家技术说得很危险,也就等于说它很强大,恐惧叙事在这里同时充当了实力广告。
但如果真从技术的角度去看实际风险,眼下这种程度的恐惧,几乎找不到事实依据。恐惧的强度一旦和证据的强度脱了钩,这场讨论就很难再被事实拉回来了。
在提高AI安全性这件事上,还有艰苦的研究和工程要做。但有益的应用依然远远大于风险,该建还得继续建。收益分散在绝大多数人手里,风险却挤在少数几个场景里。人对损失天生比对收益更敏感,于是那几个场景在感知中被不断放大。这就是“收益远远大于风险”这句话依然说服不了公众的原因。