本文来自微信公众号: 海豚研究 ,作者:海豚君,原文标题:《拿 DSec 来套?Muse 如何真正撬动 CPU 需求》
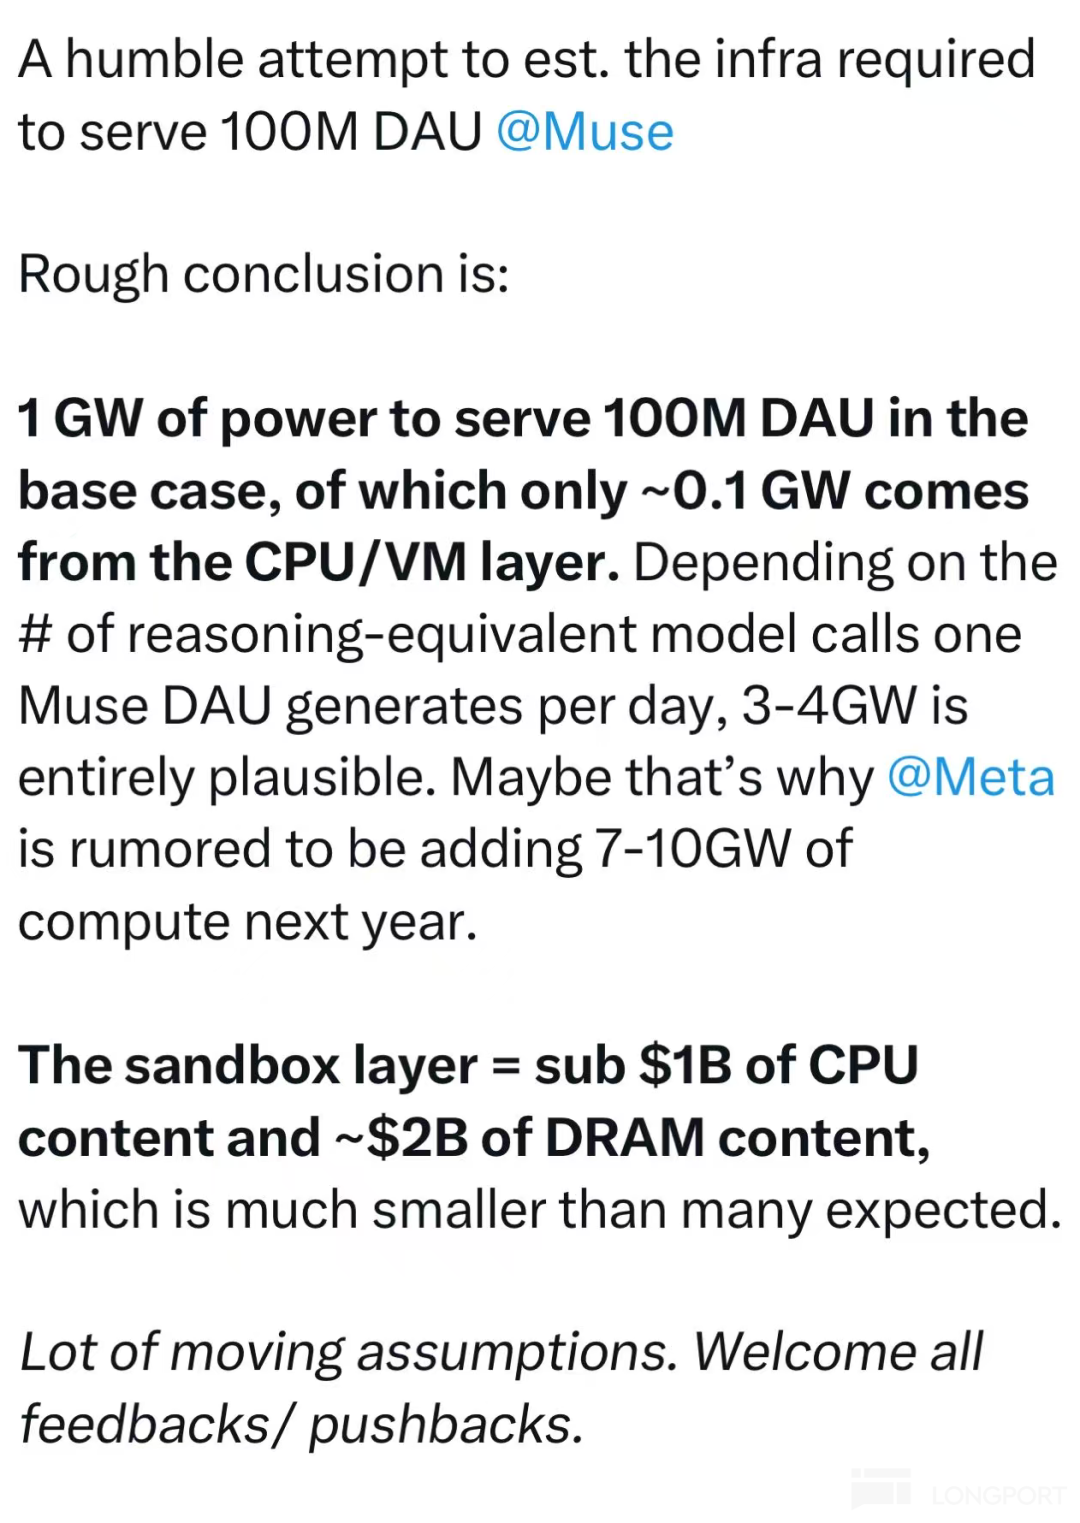
对于Muse对CPU的带动,前两天海豚君已经做了讨论(点此回顾)。我们注意到X上有人提到了不一样的观点,先来看看不一样的声音:
“基准情形下服务1亿DAU需要1GW电力,其中只有约0.1GW来自CPU/VM层。取决于每个Muse DAU每天产生多少次推理等效模型调用,3到4GW完全说得通。”
下面海豚君再来讨论下具体差异:
1.计算方式对比
首先我们来对比下计算方式:
Freda:“CPU核数=DAU×(活跃时长/24)×峰均比×冗余系数×每live VM物理核数”;
海豚君:“CPU核数=(A头节点)GPU出货量×每GPU头节点核数+(B固定层)总注册用户x日活率x(活跃时间/24)×每用户2vCPUx峰均比÷超售比÷2(单核两线程)+(C弹性层)活跃用户×任务并发率×每任务沙箱核数”。
可以看出对方的测算中,并没有测算A头节点(GPU侧)的CPU核数。当然这也能理解,这个也不能算Agent CPU带来的增量部分。
关键在于Agent CPU主要带来的部分,就是用户侧和Agent侧两部分,海豚君将其拆分成B固定层和C弹性层两块,而Freda的测算并没有进行拆分,而是直接用一个live VM物理核数来给设定。
2.概念的混淆性
Freda的测算中,关键在于live VM物理核数的选定,她直接参照了DSec。
原本提到“DSec also demonstrates stable operation at around:800 microVMs per node.”她测算的是,188物理核/节点÷800microVMs/节点=0.23物理核心per live VM。
值得注意的是,DSec当时的设计目标是:当Agent需要执行代码、操作shell、读写文件等工具时,按需创建microVM沙箱来隔离执行。因而这里的microVM,实际上并不是用户数,而是沙箱数。之后再把这个数去乘以用户数,来测算整个规模明显是不对的。
另一方面,Freda选用的800个microVM只是演示上限,按生产实测峰值表现为524个micro VM,拿188物理核/节点÷524microVMs/节点=0.36物理核心per live VM,而不是给出的0.23。
这两者只有在“一个用户在峰值时恰好只持有一个沙箱”时才相等。而Muse显然不是这样的,用户VM本机没有浏览器,broker要去租另一台跑浏览器镜像的VM。光这一条,一个正在浏览的Muse用户就至少占两个沙箱。
这么看来,Freda只是测算了C(弹性层)的部分,并未测算A头节点(GPU侧)和B固定层(用户侧)的CPU核需求。
3.不合适的参照对象
当然,C(弹性层)本身也是Agentic AI需求的主要增长来源,姑且来看这部分:
DSec和Muse本身就是不同的,拿着DSec来参照也不太合适。DSec是DeepSeek用来跑代码执行的沙箱:跑一段代码、返回结果、销毁;而Muse的沙箱是常驻的个人计算机:带浏览器、带持久记忆、带Chromium多进程调度、关掉App还在跑。
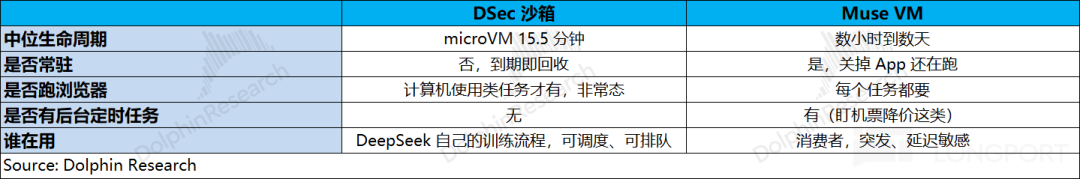
Freda的整条逻辑建立在“90%的沙箱平均只用不超过申请CPU的5%"这个实测上。但这个5%是在DSec的负载构成下测的,是被大量“跑脚本、编译、跑测试”稀释出来的均值,不是浏览器负载的占空比。
Muse是完全不一样的。一次跨平台比价可能触发多达146次页面加载,而每次页面加载都是完整的HTML解析+JavaScript执行+DOM构建+渲染。Chromium的JS主线程是单线程且CPU-bound的,一个现代商旅页面的渲染要占满一个核好几秒。
本身单个客户不一定只有1个任务,因而海豚君在C(弹性层)中引入了并发率的概念(情景假设),即对应单个活跃客户的平均任务数(1个任务对应1个并发沙箱),这部分要关注后续Muse等Agent的使用情况。
对于C(弹性层)的测算,在1亿Muse用户(日活30%)、每天活跃3小时、峰均比2的情况下,假定每个任务沙箱需要的CPU核数为1.5个(此前的4个是参照NemoClaw的配额上限),以并发率来做情景假设:其中峰值活跃达到750万(=1亿x30%x3/24x2)
中性情况对应着并发率=150%(从此前的100%上调),即单个活跃客户平均有1.5个任务。如果单个CPU机架和GPU机架均为200kW,CPU机架的占比下调至在15%的情况下(此前假定占比25%),对应着1GW的配套工厂。
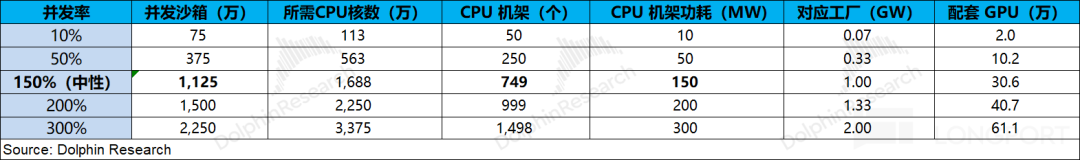
在这情况下,单GW对应的CPU核需求量=A(GPU侧)1836万个(=30.6*60)+B(固定层)188万个(=1亿x30%x3/24x2x2/4/2)+C(弹性层)1688万个=3712万个,大约是原来纯GPU机架方案的2倍左右(相比于1836万个)。
在调低单个任务沙箱需要的CPU核数的情况下,也相应的调低了CPU配比情况,对应着CPU需求倍数从3倍调整至2倍,仍远高于Freda的预测。考虑到英伟达存储机架(DPU)等部分的额外需求,海豚君预估Agentic CPU有望带动CPU核数需求仍会达到2倍以上。
整体来看,这份Freda的测算中混淆了microVM(任务沙箱)和用户的概念,他仅仅算了C弹性层的一部分,并且在计算过程中参照的DSec和Muse的方式本身就有很大的不同,这样的参考是明显不合适的。