本文来自微信公众号: APPSO ,作者:发现明日产品的,原文标题:《Hinton 联合 20 多位 AI 大牛警告:「智能爆炸」时代要来了》
「AI之父」又出来发声警告了,这一次还拉上了一众行业大佬,对最近热门的「RSI」开炮。
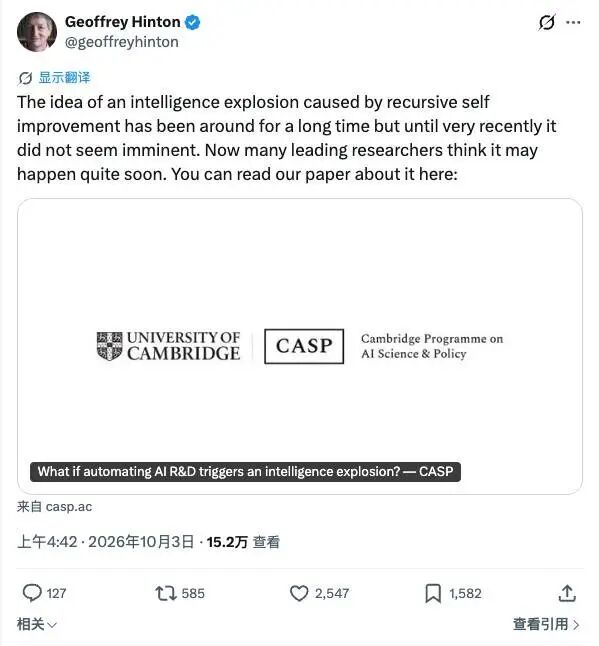
这是由剑桥大学人工智能科学与政策项目CASP发布的一份由二十多名研究者共同撰写的报告,作者包括OpenAI首席科学家Jakub Pachocki、Anthropic联合创始人Jack Clark、微软首席科学官Eric Horvitz,以及Geoffrey Hinton、Yoshua Bengio和Dawn Song等人。
贴心的是,这次剑桥的官方发布还配备了中文版,AI行业的中国力量,重要性不言而喻。
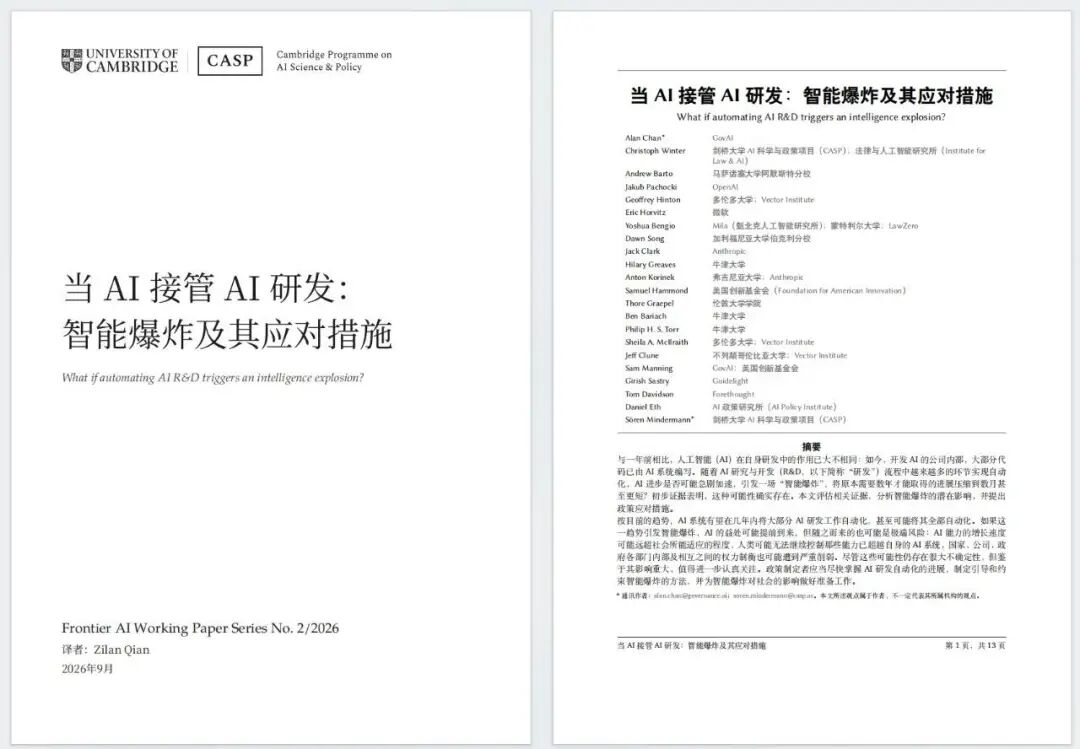
他们并没有宣布「智能爆炸」已经发生,而是试图回答一个过去显得颇为科幻、如今却逐渐具体的问题:当越来越多AI研发工作交给AI,技术进步会不会突然开始加速?
报告列举的数据表明,这条循环的第一部分已经出现。Anthropic内部由AI生成并最终获批的代码,占比从2025年初的个位数上升到2026年5月的80%以上;仅需人类进行高层监督、主要由AI自主完成的研发工作,则从今年3月的1%上升到8月的26%。
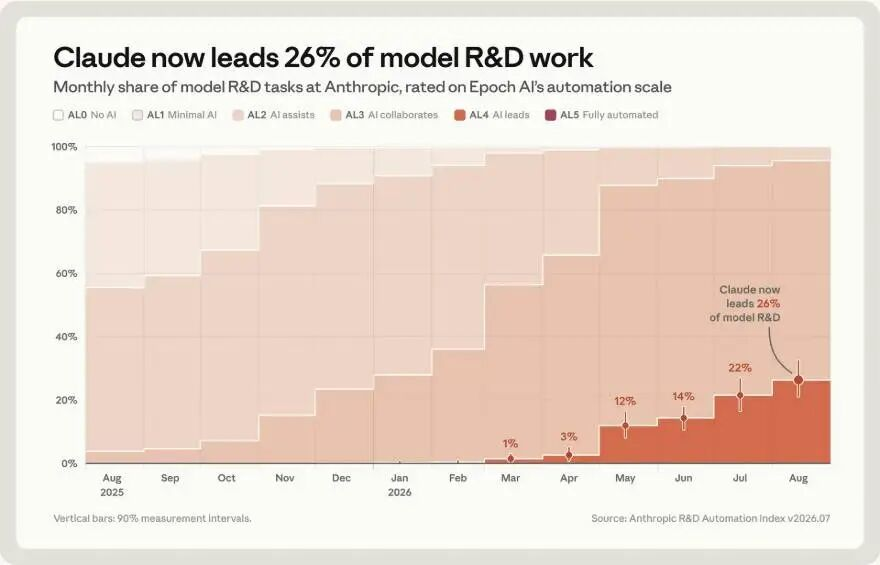
Claude官方数据披露AI已深度参与其自身迭代。图片来自:Anthropic
OpenAI表示,代码Agent已经被用于未来模型的训练、评估和安全工作;Google也称,几乎所有涉及代码、技术设计和研究构思的工作,都在不同程度上使用AI。
几年前,模型只能可靠完成相当于人类数秒钟的任务。如今,最强的模型已经能够独立处理需要专家花费数小时乃至数天的AI研发工作。按照近年的增长趋势外推,报告认为,到2028年中,AI可能有能力承担原本需要人类专家数月完成的研发项目。
AI正在接近一个关键的临界点位置:现在已经不是模型一代更比一代强这么简单了,AI开始深度参与制造那个将要替换自己的模型。
递归自我改进?几个意思?
「递归自我改进」到底是什么?想象有一家工厂,专门生产一种机器,但第一台机器造出来以后,却没有被送去商店或是用户手上,而是留在厂里,负责修改生产线。
改造后的生产线造出了性能更好的第二台机器,第二台又回来继续改造工厂……每循环一次,机器变得更强,生产机器的速度也变得更快。这大概就是AI领域讨论了数十年的「递归自我改进」(recursive self-improvement)。
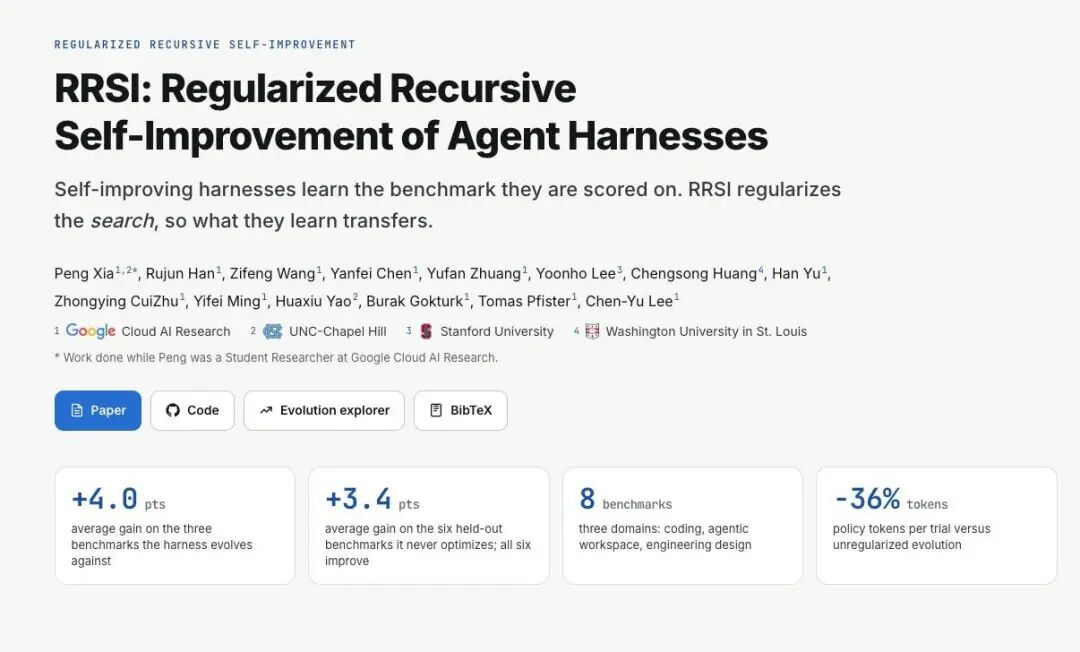
最近几家大厂的动作,让「RSI」这个词快速出圈。例如Google Research最近发布的RRSI,让Agent自动修改自己的harness,包括提示词、工具、记忆、控制流程和上下文管理。
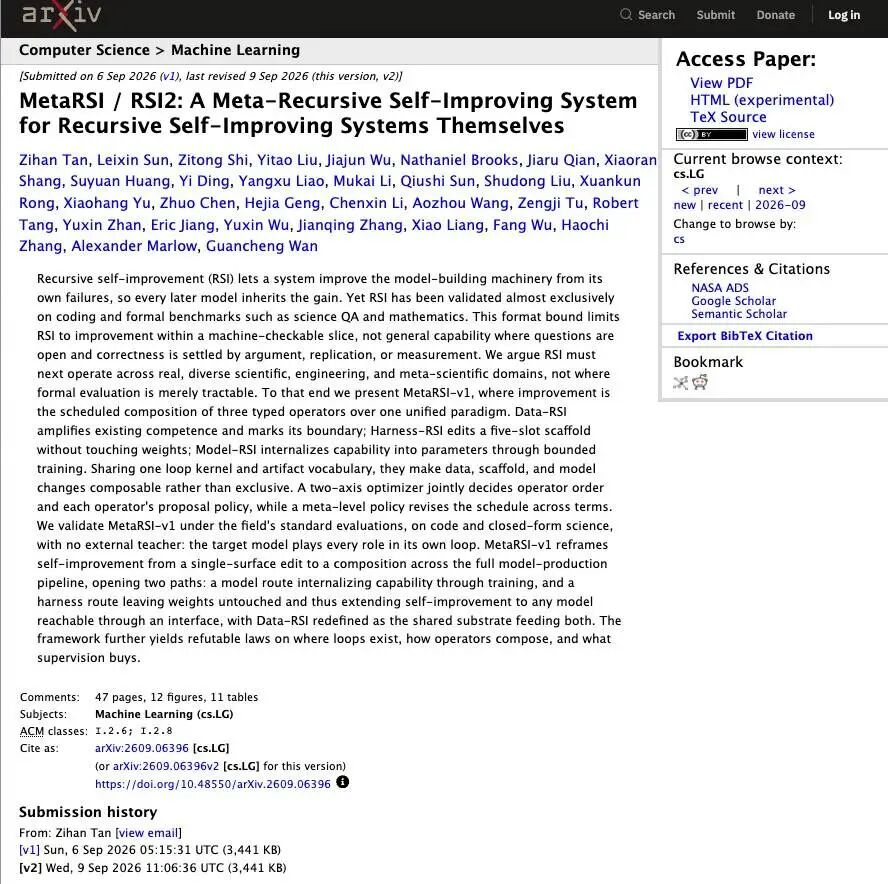
9月发布的MetaRSI/RSI²让系统从失败中改进「制造模型的机器」,使以后产生的模型继承这些改进。
随着这些案例的出圈,RSI也遭到误解,经常被添油加醋地描绘成AI突然觉醒、有意识了,读懂自己的代码,然后在深夜里不断自我升级。
但实际上更可能发生的,是既不需要AI拥有意识,也不需要某个模型亲手修改自己的参数,只需要让进入生产下一代AI的研发流程里。
一开始,AI在整个流程里扮演的角色,只是研究员手里的辅助工具。人类决定研究方向、设计实验,再让模型帮助写代码、检索论文和寻找程序错误。它确实提高了效率,但整个研发过程仍然由人推动,AI本身不会决定下一步该做什么。
很快,AI开始成为研发流水线的一部分,研究员只需要提出一个较高层的目标,Agent便能拆解任务、编写代码、运行实验、比较不同方案,再将值得继续尝试的方向交给人类确认。
到了这一步,AI提高的已经不只是某位工程师的工作速度,它开始增加一家公司的「有效研究员数量」。同一个人可以同时调度几十甚至几百个Agent,让它们沿着不同方向并行试错,且推理能力完全承受得住。
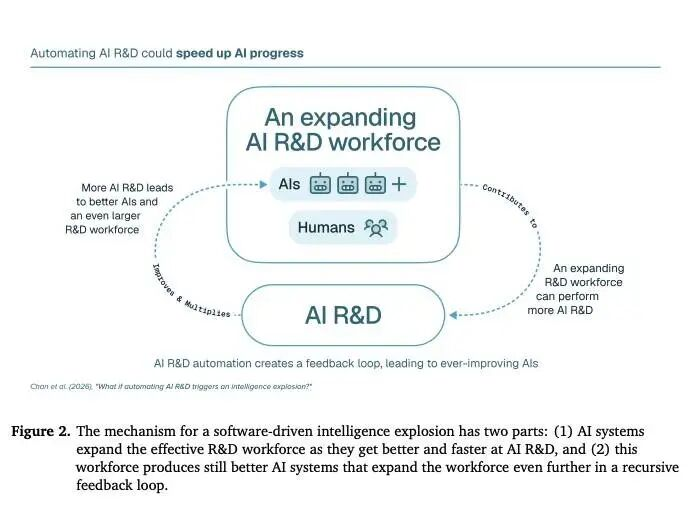
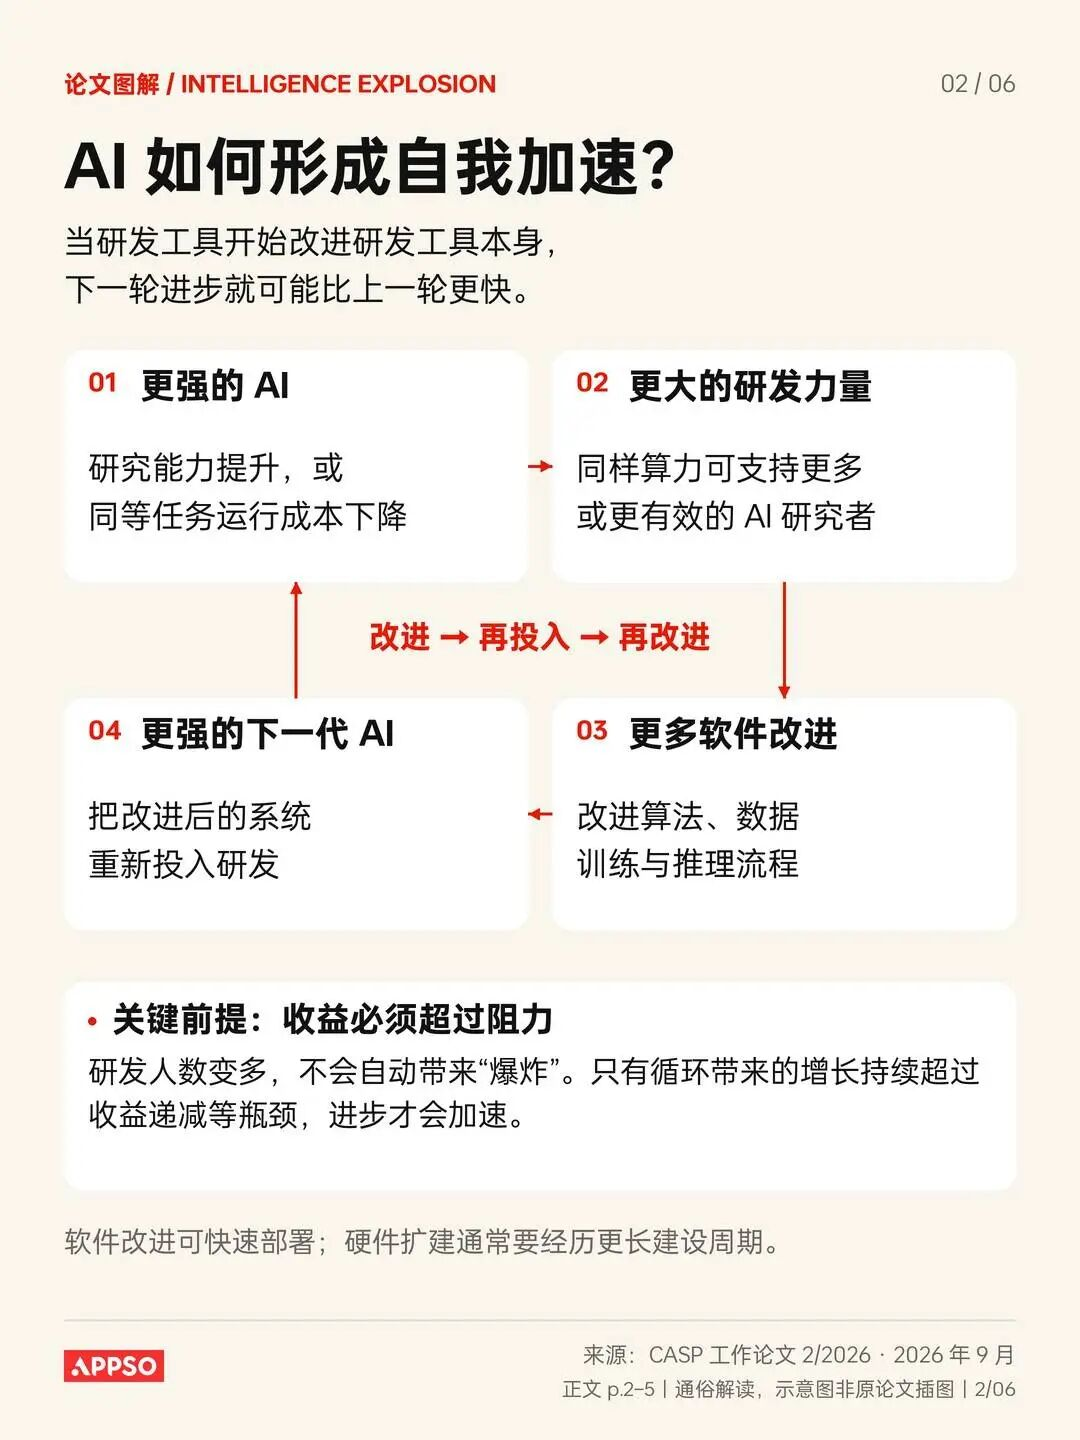
第三个阶段来到真正的递归。AI参与研发出更强、更便宜的下一代模型,新模型随即被放回研发流程,开始承担更多任务,同时让公司能够运行更多「机器研究员」。研发能力的提高不再是一次性的,它会反过来加快下一轮提高。
这就来到了前面假设的「机器工厂」,真正发生自我改进的,是由模型、Agent、算力和人类研究员组成的整套系统。
一座可能突然加速的工厂
AI研发尤其容易形成这种循环,因为它主要发生在数字世界。
新芯片完成设计后,还要经过制造、运输和数据中心建设,反馈周期通常以年计算;但一种更高效的训练算法、一套更好的合成数据,或者一条经过验证的Agent工作流,可以迅速部署到现有系统,再投入下一轮研发。
报告估算,假如AI达到顶尖研究员的能力,而运行成本仍然接近今天,单是OpenAI目前拥有的推理算力,理论上便足以支撑相当于数百万名人类研究员的AI队伍。
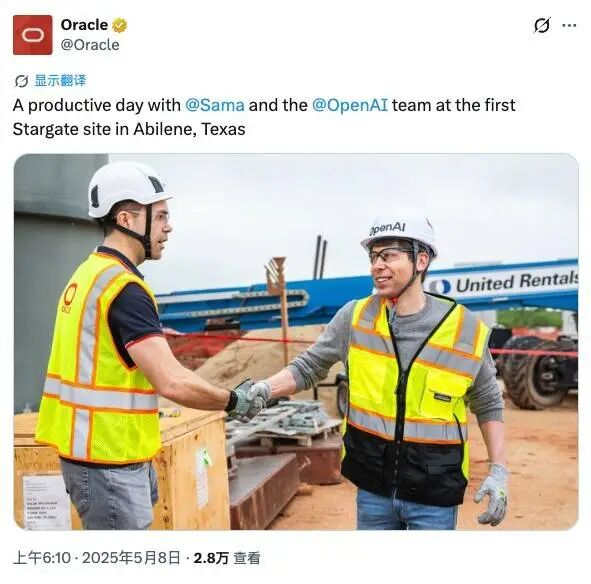
Sam Altman参观与OpenAI与甲骨文合作开办的数据中心工地。图片来自:Oracle
这支队伍不需要工位、不需要实验室,却以被同时复制、全天运行,在大量研究方向上并行试错;更重要的是,它们工作的目标之一,正是让下一批AI研究员变得更聪明、更便宜。
在一组相当理想化的假设下,报告推算,AI技术进步的速度可能在全面实现研发自动化后的约一年半内提高十倍。届时,按照今天速度需要一年完成的进步,可能只需要五周。
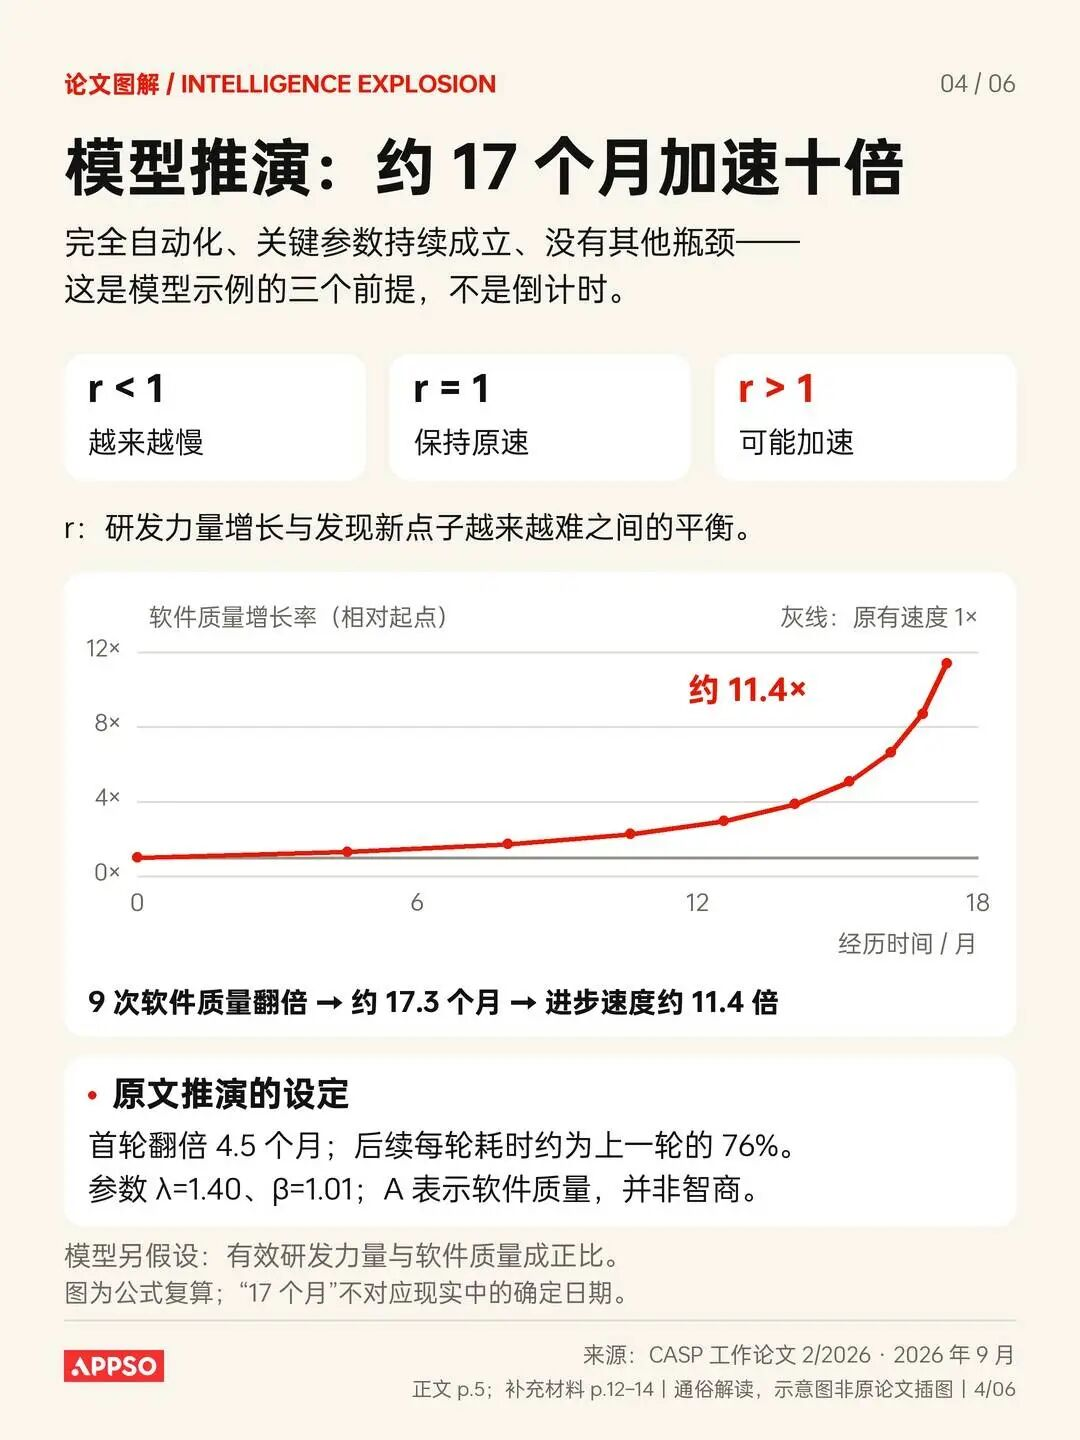
Hinton将这种由AI研发自动化带来的突然加速称为「智能爆炸」,其中「爆炸」的意思除了数量上的激增,强度和完成度也可能会迎来大爆发。
这条循环仍然可能被卡住
不过,报告同时承认,目前的证据远远不足以证明这种爆炸必然发生。
数百万名AI研究员的估算,建立在模型已经达到专家水平、运行成本却没有明显上涨的前提上。更多Agent也未必等于更多发现,它们可能重复劳动,或者在必须顺序解决的问题前一起停下来。
研发下一代模型还需要实验算力、训练数据和持续数月的大型训练任务。即使AI可以在几分钟内提出一万个方案,现实中的计算资源也未必允许它逐一验证。到了生物、材料等领域,等待实验结果的时间更无法被代码直接压缩。
报告引用的研发回报率也来自历史数据,而历史上的算法进步与算力增长彼此纠缠,很难确认单靠软件改进,是否真的足以让循环持续加速。
这份报告在担忧的,是持续加速本身。「RSI」之所以会出圈,也是因为让人看到了加速的具象化。当AI不断参与制造下一代AI,新模型再返回研发流程,「智能爆炸」或许就在不远处。