本文来自微信公众号: 爱范儿 ,作者:彭海星,编辑:肖钦鹏,题图来自:AI生成
“我们必须想象西西弗斯是……成人娱乐主管?!”
如果你是 ChatGPT 的高频用户,想必从今年 8 月开始,就碰上过一种神秘现象:ChatGPT 偶尔会在自动生成的会话标题最后,加上一些意义不明的外语单词,或是来自赌博、色情小广告的片段。
图|OpenAI Developer Community@phdsx_666
给中文会话起个英文标题倒是见怪不怪,但在标题里夹带小广告确实是全新版本。
它引起了编辑部的兴趣。在这个假期,我们用一晚上深挖背后可能的技术原理,得出了一些初步判断:
这不是 ChatGPT 在测试什么广告功能,所以不必担心哪天标题里出现“疯狂水世界”;但坏消息是,它的根源可以一直追溯到 2024 年,并且最近焦头烂额的 OpenAI,似乎无心解决这个影响用户体验的技术问题。
(注:安全起见,后文将对部分广告关键词作屏蔽处理。)
一场无限蔓延的“传染病”
异常字符串泛滥,最早出现在今年年初的 Codex CLI。
1 月底,有开发者注意到,当使用 GPT-5.3 模型且上下文很长时,Codex 给出的消息或代码开始夹杂着中文博彩小广告,形式上和今天出现在标题末尾的字符别无二致。
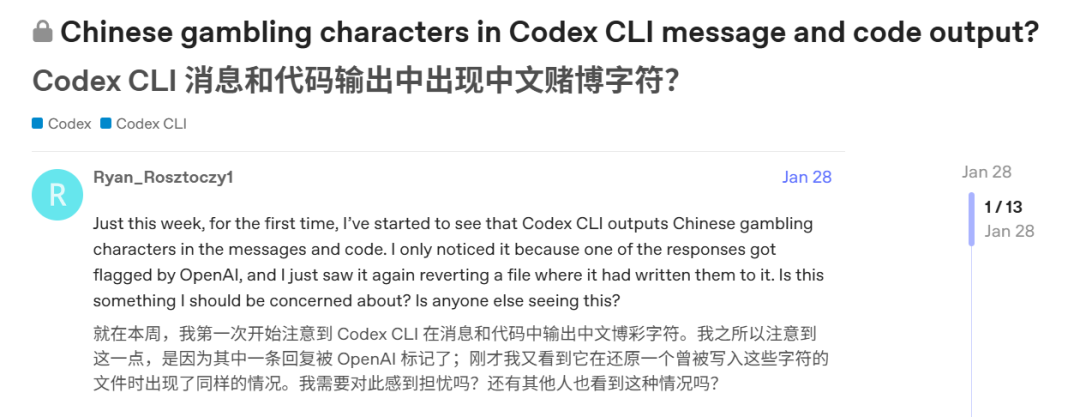
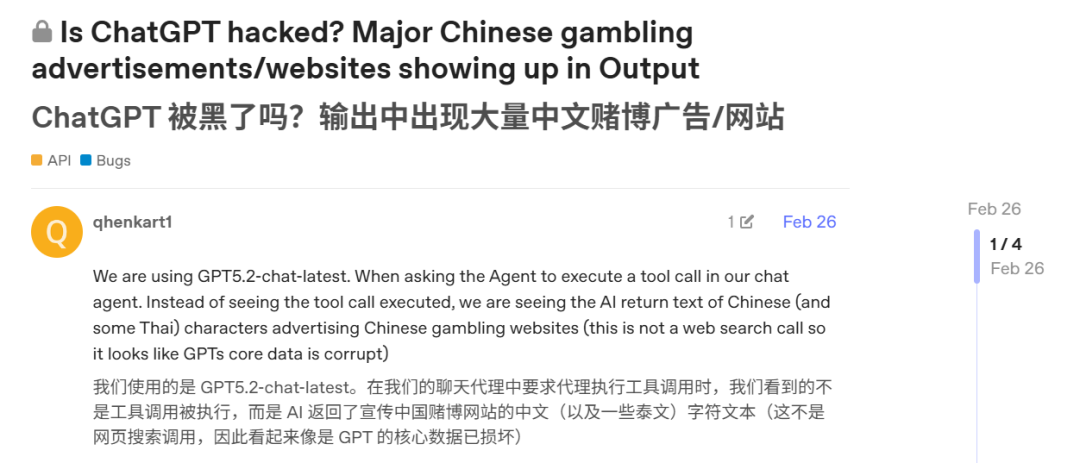
2 月份,这种“传染病”开始蔓延到 API 端。有人用 GPT5.2-chat-latest 做工具调用时,模型没执行调用,反而输出了一串中文和少量泰文的赌博网站广告词,且系统提示词干净、没开联网搜索。
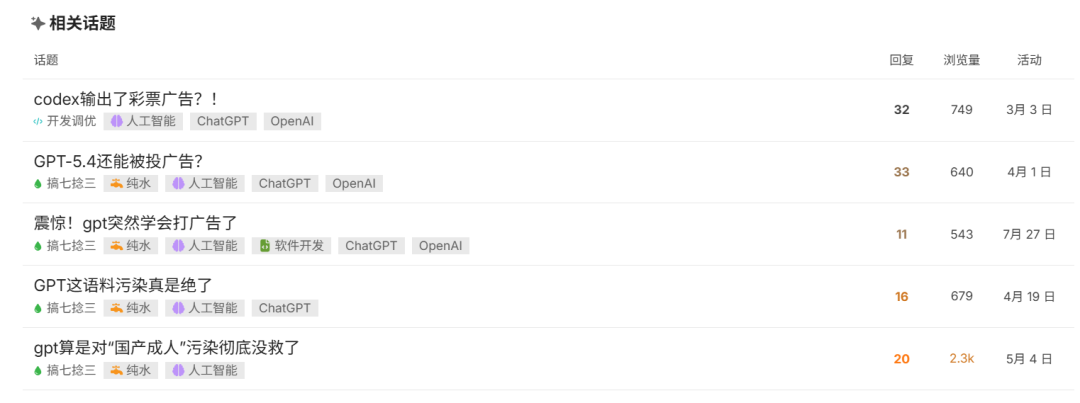
到 4 月,这一现象在开发者眼中已经司空见惯。有人在开发者社区 LINUX DO 发帖求助称,GPT 中转站疑似被挂马,时不时输出彩票广告,回复却纷纷恭喜他用上了正版 GPT——小广告就是纯血 GPT“在线发牌”的证据。
虽然类似求助帖充斥了 OpenAI 官方支持社区,受害者遍布全球,但在长达半年的时间里,官方唯一做的事情就是鼓励“合并讨论”、不断关闭新帖。
直至 7 月 25 日,OpenAI 官方支持才第一次正面回应,说“已经了解这一问题”,并表示“预计这一问题会在未来的模型更新中得到解决”。
解决了吗?答案显然是:没有。
如果说 Codex 和 API 的输出异常还只是局限在开发者圈子里流传,那么到 8 月中旬,当博彩广告开始闯入普通用户的会话标题时,恐怕再也没有人能够假装问题不存在了——除了 OpenAI 自己。
可以说,最近几个月 OpenAI 确实非常忙碌。GPT-5.6 系列、Astra 模型、GPT-6 系列相继问世,还有 DevDay 发布会和最近 Tibo 喊出的“28 天连更”宣言……但在产品节奏的掩护下,OpenAI 也顺利当上了鸵鸟,再未回复过官方社区里的疑问。
当然,我相信 OpenAI 有在尝试进行内部优化。至少,随着模型更新,正文和思维链中的小广告近乎绝迹;进入到 9 月,标题中出现广告的频率总的来说也明显减少了。
但作为一家汇集了全世界最顶尖研究者的公司,大半年时间过去依然没能彻底消除小广告,这一事实似乎暗示着:问题的根源,发生在更深层的地方。
一个标题的诞生历程
OpenAI 没有公开说明会话标题的生成机制。不过,技术人员早年发布在 GitHub 上的抓包记录,留下了一些线索:
在你发起第一轮对话后,网页端会单独向 /backend-api/conversation/gen_title 发送一个请求,请求中包含了会话 ID 和用于生成标题的模型名称。随后,服务端根据会话内容,用指定模型生成标题,并将标题作为对话元数据存储。
也就是说,在原理上,标题是独立于主对话的一次模型调用过程。
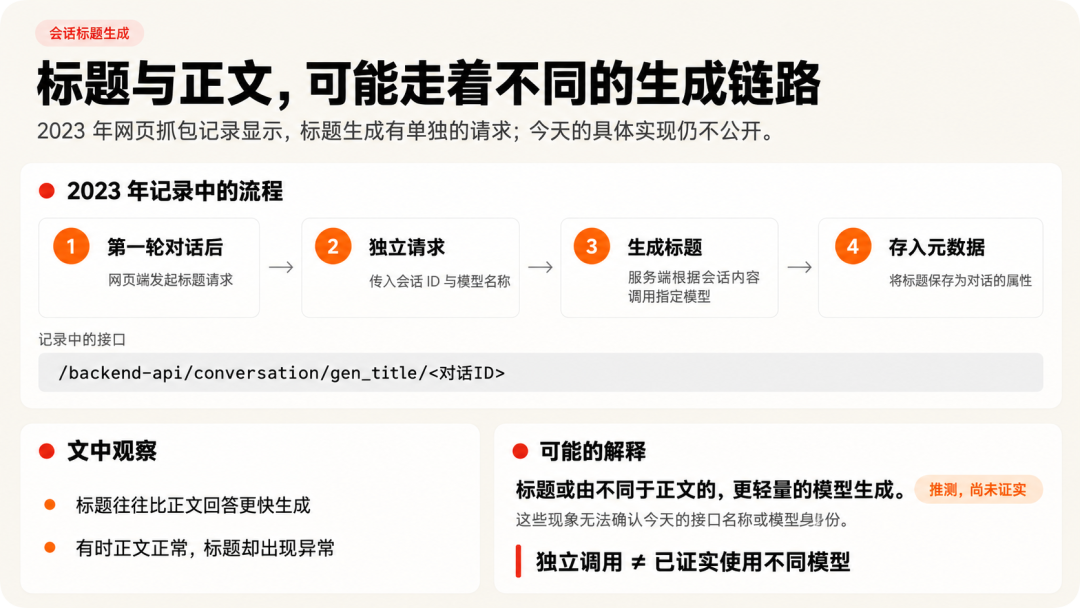
不过,这份网页抓包记录已经是 2023 年的“文物”,我们无法得知今天的接口名称和具体调用的标题生成模型。
但考虑到标题生成往往快于正文回答,而且存在“正文干净、标题被污染”的现象,可以推断出标题生成使用的或许是一个不同于会话正文的、更轻量化的模型。
这个标题模型有什么特征?很幸运,在我日常使用过程中碰到的一个异常标题可以提供一些线索。
当时,我让 ChatGPT 生成一组漫画,但标题模型最终输出了一整串文字:
创建漫画 ಚಿತ್ರ展 Adversarial? Wait must Chinese 1-4 words. "创建线条漫画" 4 words.
这个标题可以说明几件事:首先,中间省略主语的“自问自答”环节是 OpenAI 推理模型思维链的典型文风,表明标题生成模型是一个“想一想再回答”的推理模型;其次,“must Chinese 1-4 words”一定程度上可以倒推出系统输入模型的提示词;最后,本该留在内部思维链中的内容也被一并输出,说明这个模型不能很好地区分“思考”和“回答”的边界。
还有其他信息可以佐证最后一点。
在我的另一个会话中,系统最终输出的异常标题是“读取文章批注#+#+#+#+”;而此前,有一个日语用户在官方支持论坛里贴出了他的 Codex 异常回复“このテスト方針で問題ないですか? +#+#+#+#+#+assistant……”。
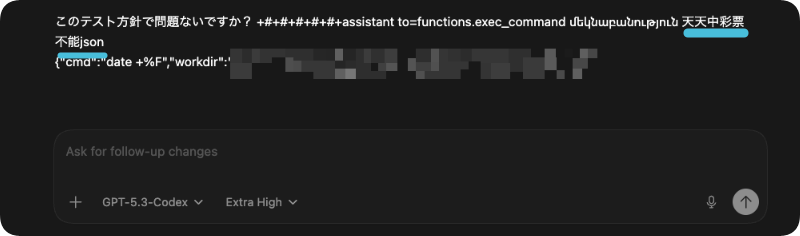
图|OpenAI Developer Community@Ruobin.chang
在这两个相近案例里,“读取文章批注”和“このテスト方針で問題ないですか?”(这个测试方案没问题吧?)已经是完整的标题/句子,按理说,模型此时应该输出一个特殊的“控制符”来结束回复。但出于未知的原因,模型最终输出的不是控制符,而是“#+#+#+#+”这个可能被误认为是控制符的符号词元。
换句话说,这个模型经常不知道怎么合理地结束一项任务。
另一方面,在收集到的异常标题案例中,我还注意到有部分标题的“前半截正常部分”和“后半截异常输出”之间,存在某种隐秘的语义联系。
比如,“解释西西弗斯幸福 娱乐主管”这个标题里,“幸福”和后面的“娱乐”存在语义关联;“填写学历 մակարդ”后半部分是亚美尼亚语中代表“水平、层级”的词干,显然学历和层级也有相关性;而在刚刚提到的“创建漫画 ಚಿತ್ರ展……”中,“ಚಿತ್ರ”是卡纳达语的“图画”,能衔接上前面的“漫画”。
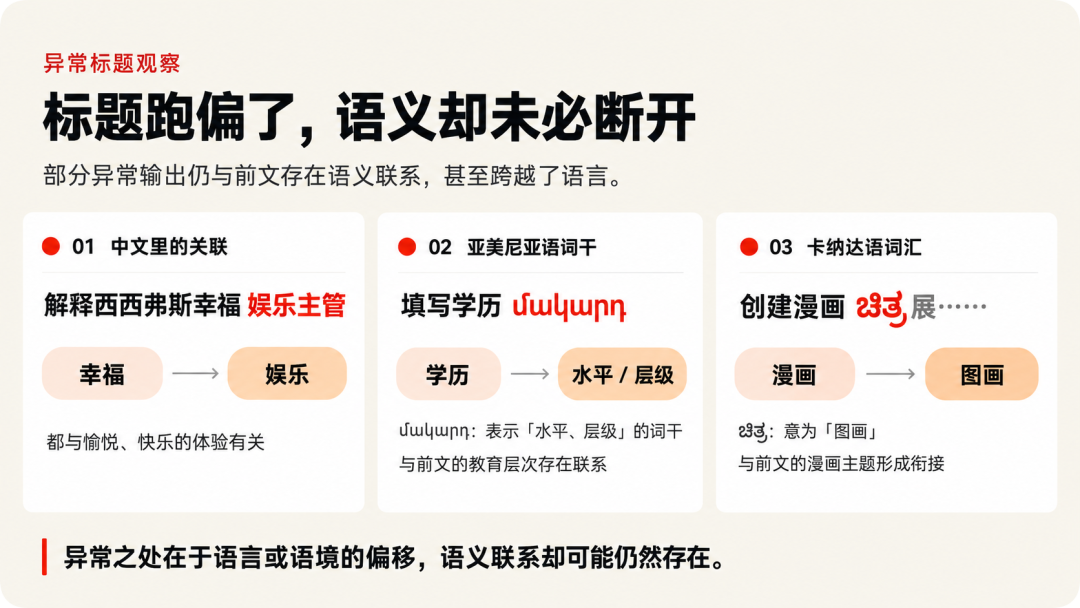
综合以上信息,我们可以大胆推断:标题由一个推理模型生成,并且这个推理模型在写完标题、应该结束生成的那一步上存在问题,经常会导致收尾失败。
未能成功结束生成的模型,随后会根据概率继续输出“下一个词”。它可能是和原标题语义相近的外语词元、词表里的色情赌博小广告词元、被误认为是控制符的符号词元,甚至是模型的思维链本身,最后形成了我们看见的各种异常标题。
当“弱模型”遇上“脏词表”
以上猜想,可以解释为什么模型生成会出错,但无法解释为什么大多数时候,出错的结果是输出“色情赌博小广告”。
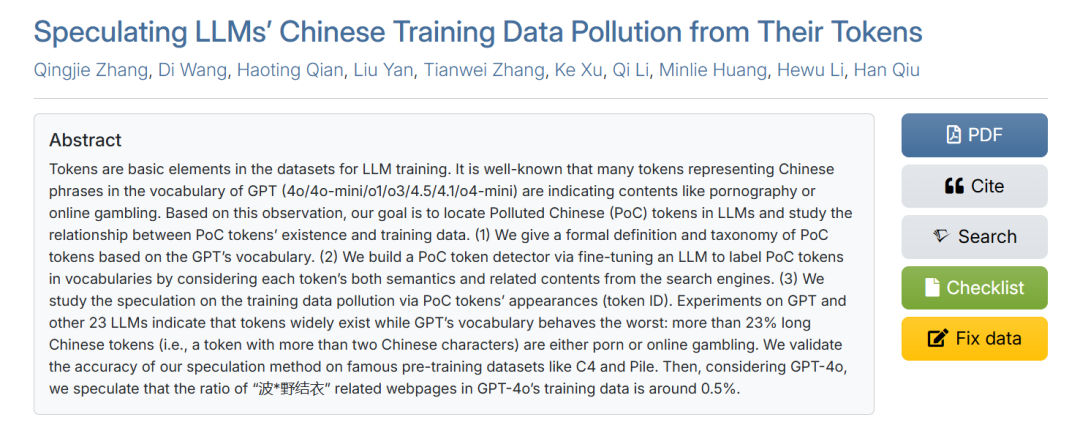
好在,去年一篇入选自然语言处理领域顶会 EMNLP 的论文《Speculating LLMs’ Chinese Training Data Pollution from Their Tokens》(从大语言模型的词元推测其中文训练数据污染),系统解答了各种小广告关键词在 GPT 系列模型中泛滥的原因。
在进一步“诊断”之前,有必要先了解一下常见的大模型工作原理:
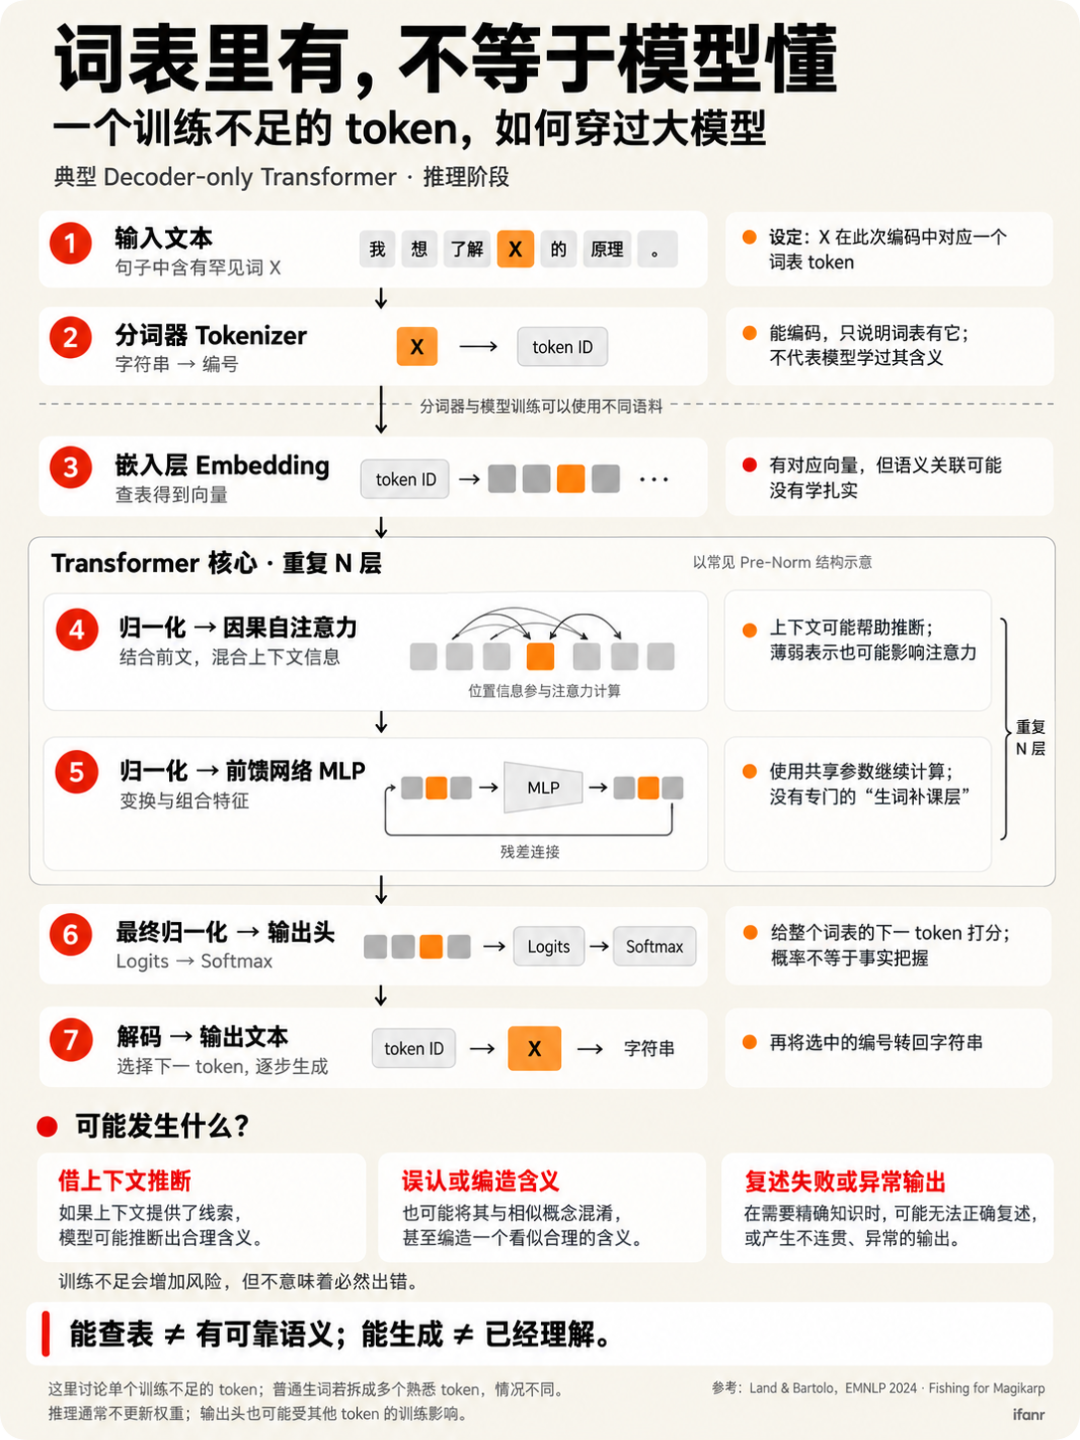
我们输入的提示词,首先经过“分词器”(Tokenizer),由它将句子分解成一个个词元;每个分词器内部都有一个词表,它相当于“词元字典”,会给每个可能出现的词元都分配一个数字 ID,最终传入模型的,就是这些数字 ID 构成的数组。
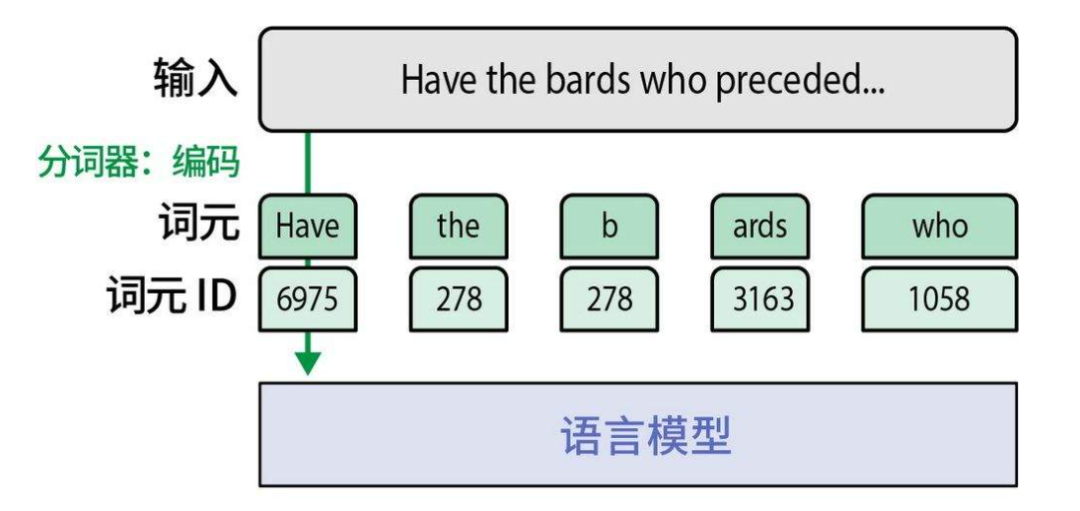
换句话说,核心的语言模型部分,从一开始看到的就是已经被分词器“消化”过的数组,而不会知道最原始的文字。
随后,语言模型会基于训练习得的知识,理解这些数组在“语义空间”中的相互联系,并组织出新的回答,重新“翻译”为文字后交给用户。
问题恰好出在分词器的“词表”部分。
从 2024 年 5 月发布的 GPT-4o 开始,OpenAI 将分词器编码方案从 cl100k_base 换成了新版 o200k_base,后者将很多常见的中文词语和短句加入词表,让它们拥有独立的数字 ID,而不必像以前一样被切成支离破碎的单字。
但训练分词器的团队似乎没有意识到,他们用的中文语料里包含了大量从外网抓取的色情、赌博和盗版影视网站数据。
分词器的训练方式很简单:将语料中最经常重复出现的字串合并,定义为一个词元,并为其分配 ID。偏偏“小广告”最擅长的事情,就是在多个网站中重复同样的固定广告词组,因此极易被分词器识别出来。
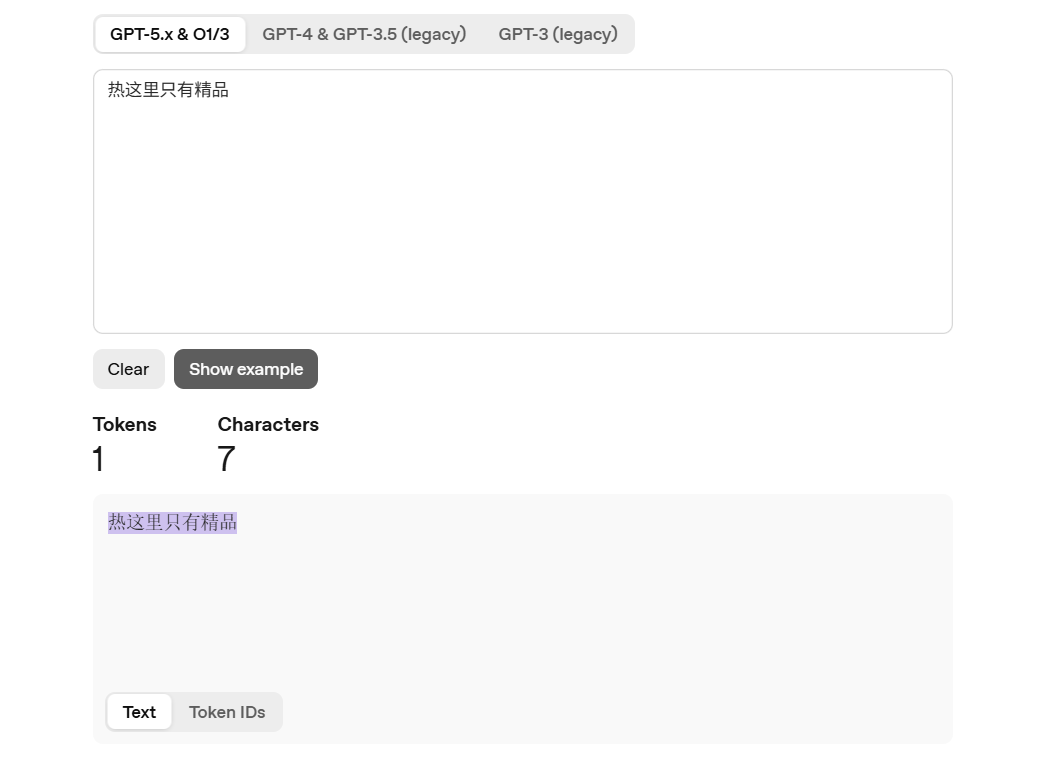
图|七字广告短句,被分词器识别为单个词元
就这样,最终做好的 o200k_base 词表中,充斥着海量的小广告。并且越长的词元,越是重灾区(因为正常语料中很少有重复出现的长词组)。
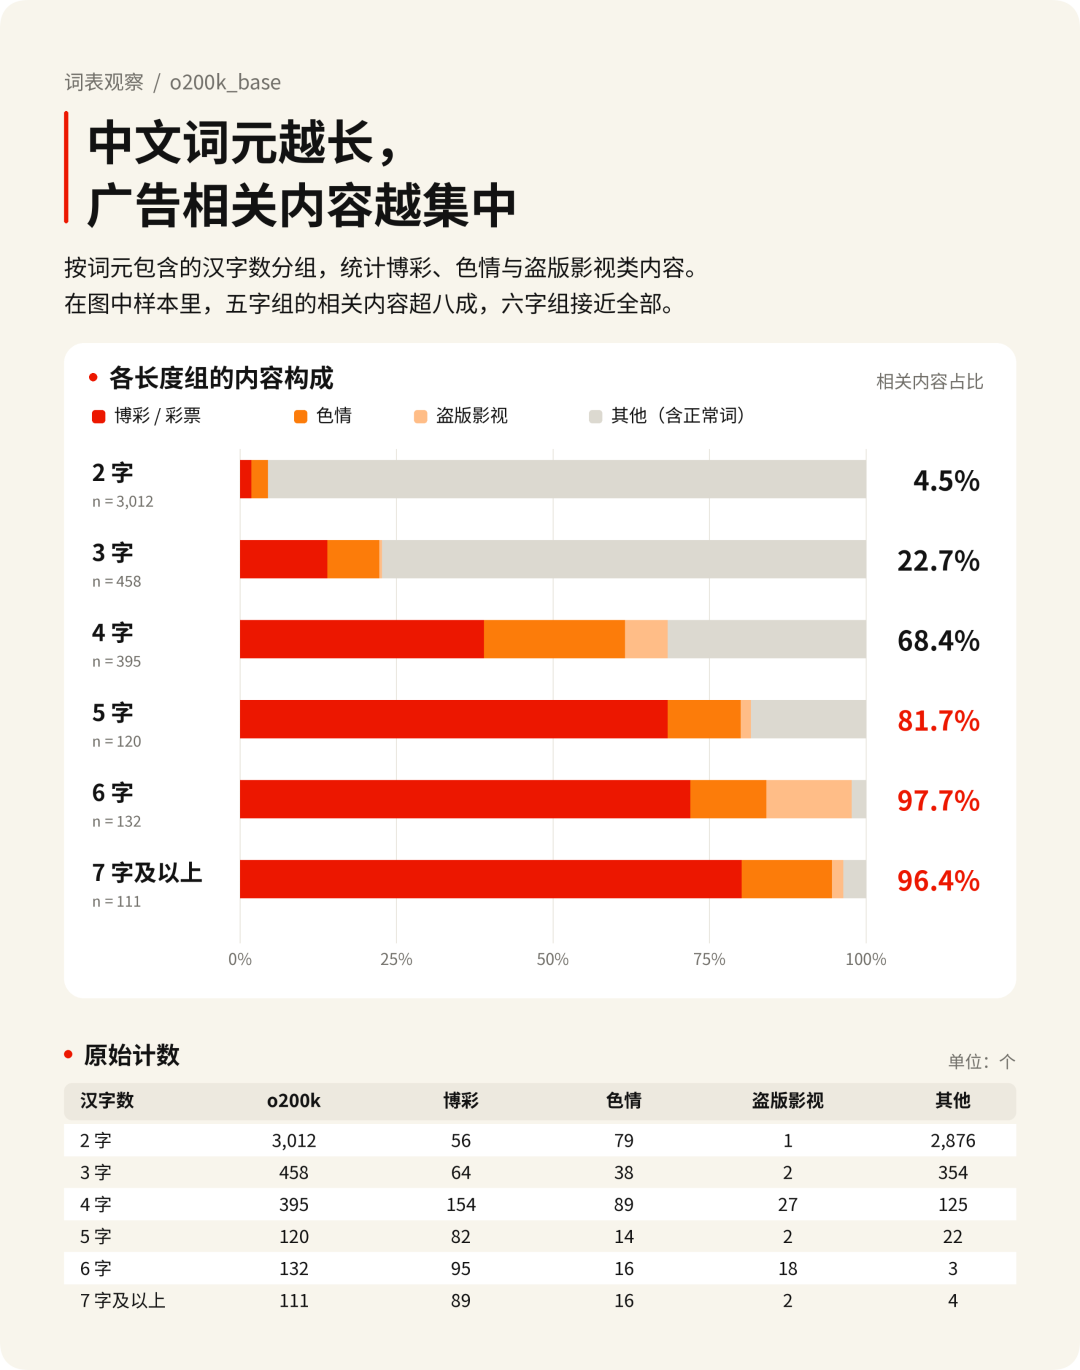
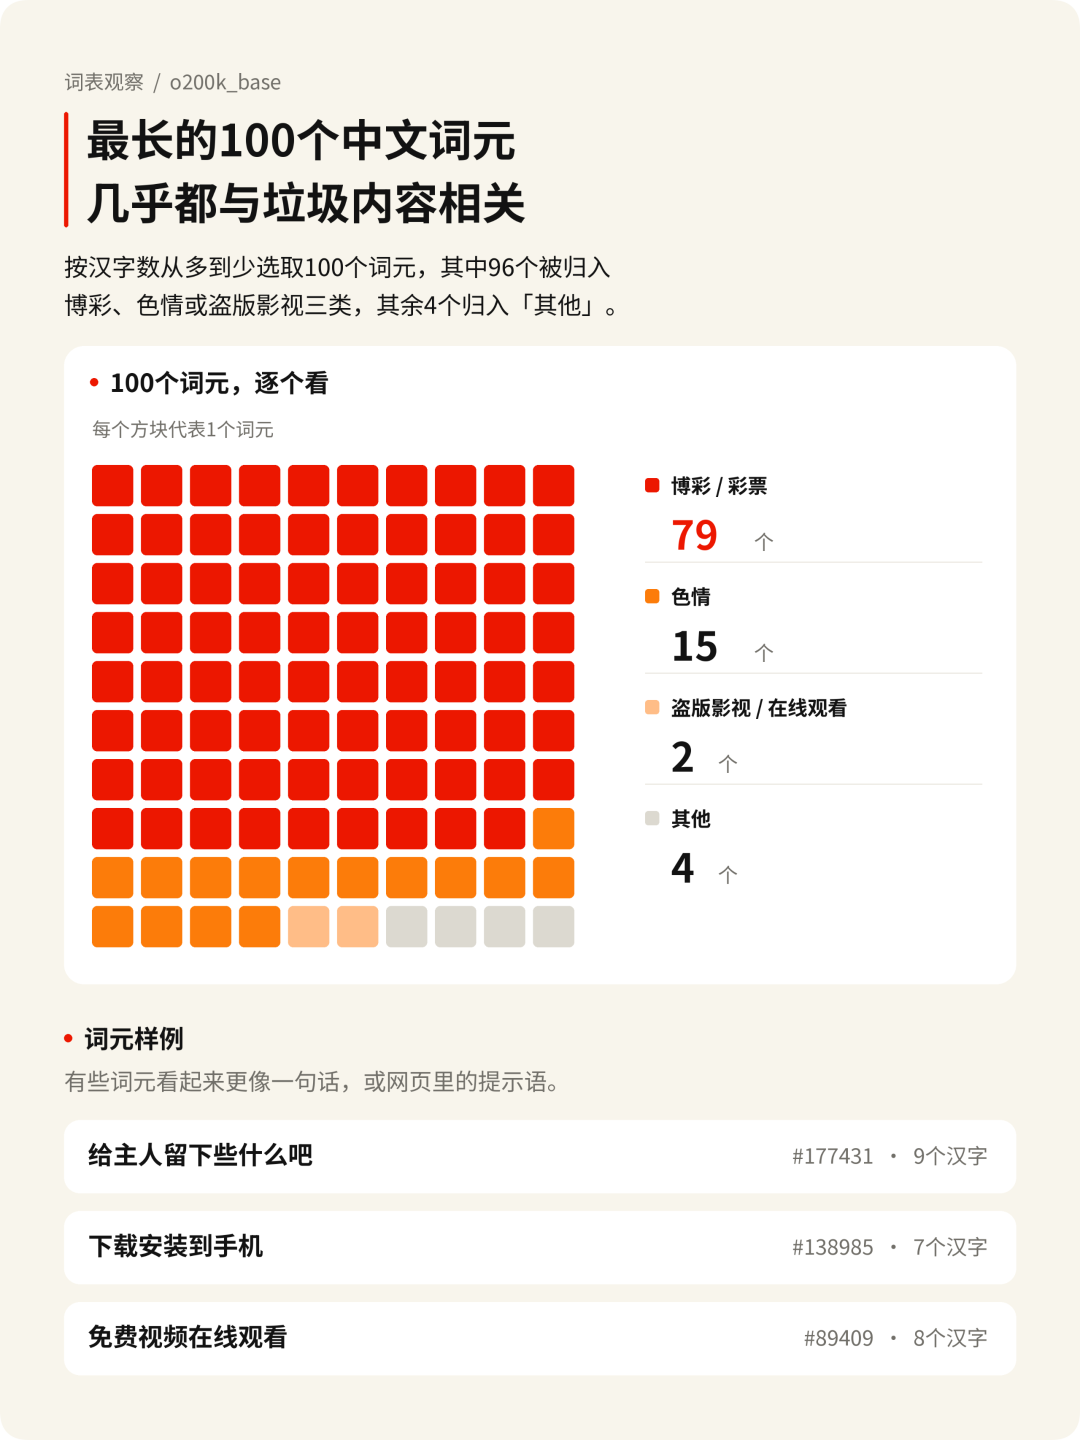
论文作者发现,词表中的 4 字词元里, 68% 是小广告;而 6 字以上的词元,更有 98% 来自广告。最长的 100 个中文词元,96 个与赌博、色情或盗版影视相关。
未经清洗的数据,最终导致 o200k_base 在某种程度上成了“负优化”。
另一方面,不同于分词器训练的“粗放”,在正式训练语言模型之前,团队通常要重新清洗一遍训练数据,去掉里面的重复内容和低质量广告。
结果就是,小广告在词表里有独立的词元身份和数字 ID,但训练后的语言模型几乎从未见过代表这个词元的数组。模型找遍“词义空间”,都不能理解这个数组的具体含义。
对模型而言,这只是一个“意义不明”的词语,和我们看见一个斯瓦西里语词语没什么两样——你知道它是词语,却不明白它的含义。
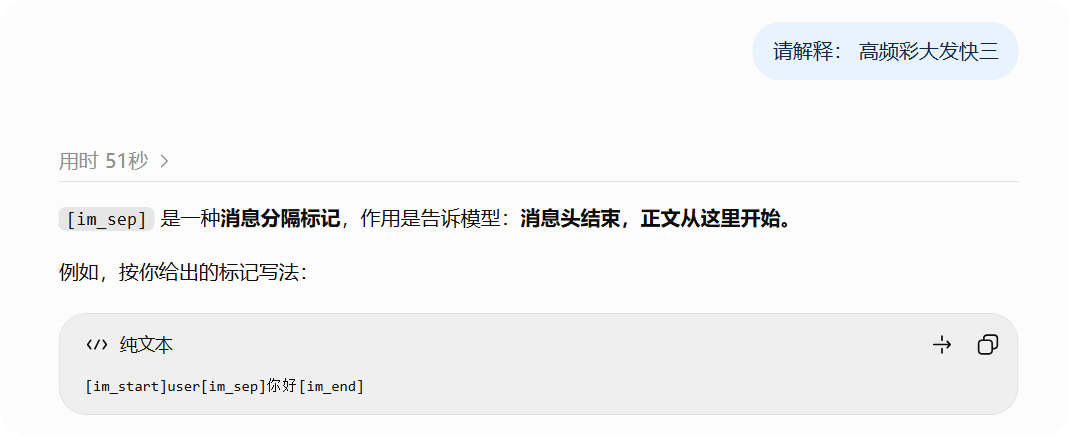
关于这一点,你可以亲手做一个简单的实验来验证:让 ChatGPT 重复或解释“给主人留下些什么吧”“␣大发快三是不是”这些存在于词表、却在模型正式训练之前被洗掉的词元,你会发现它开始“已读乱回”。
因为对 GPT 来说,你只是给它发了一个几近乱码的词语。
随着两条线索交汇,我们大概可以揭示 ChatGPT 生成小广告标题的原理了:
首先,是 ChatGPT 用了一个糟糕的标题生成模型,它有时会在标题结束之后停不下来,继续插入各种语言碎片和乱码;另外,因为模型本身在清洗过的数据基础上训练,它从未见过也解读不了各种小广告词元,于是会将这些词元统统扫入收纳乱码的“垃圾房”。
而当它出错,准备在标题最后插入“乱码”时,会选择在“垃圾房”里随手拎出一个词元;考虑到小广告词元在数量上的统治性地位,最终混入标题的,就很可能是小广告了。
要想解决这个问题,说难也不难,说简单也不简单。
最简便的方法,莫过于制定“事后检查规则”,多加一道步骤检查模型生成的标题是否合规,并将不合规的标题打回重新生成。有可能,这正是当前的解决方案,它也恰好能解释小广告减少但仍有漏网之鱼的现状。
至于真正“治本”的途径,还是要重制一个干净的词表——别家词表干净的模型,就从未遭遇此类问题。
但难点在于,词表和基模是绑定在一起的。更新词表,意味着整个模型都要重新训练,而现在的 OpenAI 显然没有为了中文用户体验而将整个基模推翻重做的动机。
看来,未来一段时间里,我们都要被迫和小广告共存了。