本文来自微信公众号: 资本不熬夜 ,作者:不熬夜研究院
这两天,黄仁勋在中国网友手里,当了一回迈克尔·杰克逊。
一段AI生成的视频,把1992年迈克尔·杰克逊布加勒斯特演唱会上的主角换成了黄仁勋。舞台下面坐着马斯克、库克、奥特曼、阿莫戴、梁文锋等科技公司掌门人,台上的黄仁勋在人群簇拥下完成了一场AI时代的“巡演”。
视频传到海外以后,马斯克转发时评论了一句:“这就是为什么内存这么贵。”后面跟着两个笑哭的表情。
虽说是个玩笑,但却落在了一个并不轻松的现实上。
因为视频利用人工智能技术制作,需要消耗算力和存储资源。而英伟达是人工智能基础设施的主要受益者之一,大量人工智能服务器采购也在影响全球存储器市场的供需关系。
过去两年,马斯克买了越来越多的英伟达芯片。xAI扩建Colossus,特斯拉训练自动驾驶,Optimus需要推理算力,SpaceX也开始把数据中心纳入自己的版图。
黄仁勋则一次次公开夸奖马斯克,但是换来的大多是马斯克相对克制的回应。
2024年,xAI用19天把10万张英伟达GPU组成的Colossus集群推进到训练阶段。黄仁勋把这个速度形容为接近“超人”,还称赞马斯克对工程建设和大型系统的理解。
到了2025年,英伟达参与xAI融资。黄仁勋后来谈到这笔投资,甚至说自己的遗憾是“没有给他更多钱”。
马斯克对黄仁勋的公开赞赏少得多。他会感谢英伟达团队,也会继续下单,偶尔再拿芯片和内存价格开一句玩笑。
但在商业世界里,更微妙的关系正在形成。黄仁勋希望马斯克买得越来越多,马斯克却越来越不能接受自己只能继续买。
与此同时,另一边的扎克伯格,也开始把AI的钱投向一个过去很少出现在科技公司资产负债表里的地方,细胞。
几年前,两人还在争社交平台。马斯克买下推特,扎克伯格随后推出Threads,一度连“约架”都被搬上互联网。到了AI时代,两个人又在同一个战场相遇。
只是争到最后,他们开始押注不同的生产资料。
01
马斯克不想再给黄仁勋打工了
马斯克想降低对英伟达的依赖,但现实正在把他往相反方向推。
SpaceX近期寻求约400亿美元融资,其中约300亿美元可能来自债券,另外约100亿美元来自银行贷款。重要用途之一,就是采购英伟达芯片。
xAI的Colossus 2还要继续增加GPU、特斯拉的自动驾驶训练继续需要算力、Optimus机器人进入更大规模训练和推理以后,同样离不开芯片。就连SpaceX,也在为未来的数据中心准备计算能力。
这些业务原本属于汽车、机器人、人工智能和航天四条不同的产业线,最后却在马斯克手里汇到同一个瓶颈:即如何解决算力?
这让马斯克的处境越来越矛盾。英伟达芯片买得越多,马斯克的AI业务跑得越快。AI业务跑得越快,下一轮需要采购的英伟达芯片又越多。
过去买芯片是一项采购。当采购规模从几万张GPU变成几十万张,就不再只由马斯克自己的工程团队决定了,而是取决于英伟达何时推出产品、能够交多少货、先进封装有没有排期、高带宽内存能不能跟上。
黄仁勋今年3月谈供应链时曾提到,内存、晶圆、封装、电力都在趋紧。对英伟达来说,资源越稀缺,优势反而越容易扩大。因为英伟达有能力提前锁晶圆、锁封装、锁内存,而客户越缺算力,也越没有理由在这个时候换掉性能最高的平台。
马斯克就在这套循环里。他不是买不起,而是有钱也不等于拥有决定权,这是依赖带来的不安全感。
今天多付一点芯片采购费并不会改变马斯克的商业版图。但xAI、特斯拉、Optimus和SpaceX未来几年能扩张多快,需要越来越多地建立在一家外部供应商的产能安排上,这件事开始和马斯克过去的经营方式发生冲突。
他很少愿意长期把关键能力完全留在别人手里。
SpaceX最初也可以只设计火箭,再把发动机和大量零部件交出去,但后来选择不断提高垂直整合程度。特斯拉也没有停在采购电池、软件和充电服务,而是一步步往电池、自动驾驶芯片、操作系统和充电网络内部伸。
现在轮到了AI,所以今年8月出现了Terafab。马斯克旗下SpaceX与特斯拉宣布,计划在得克萨斯州建设超级芯片制造基地,首期投资168亿美元,规划面积约1亿平方英尺。
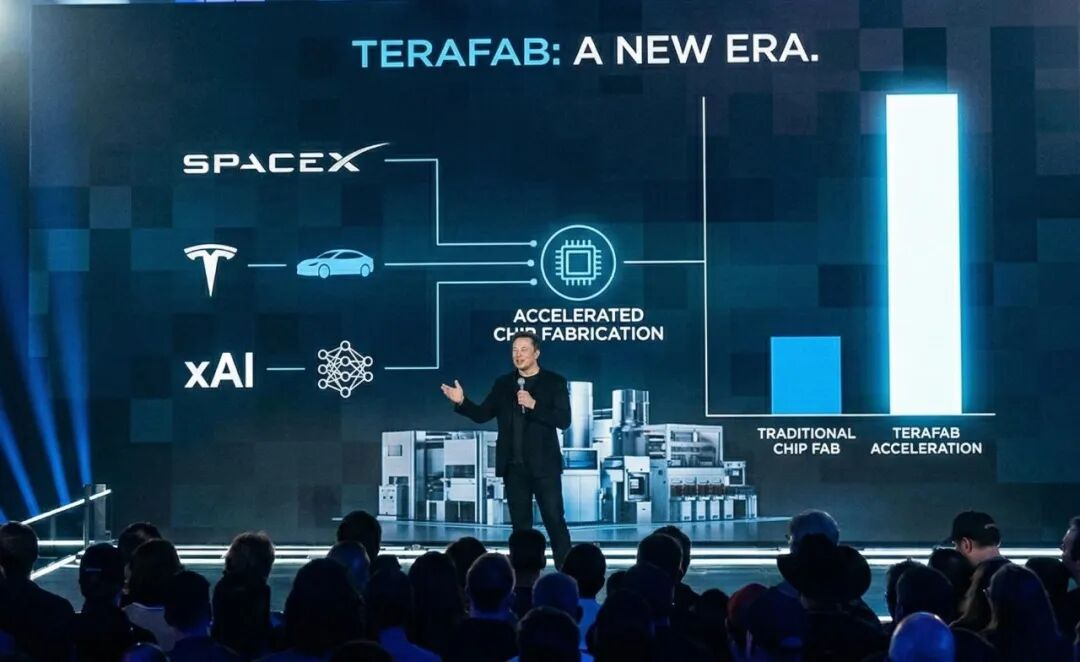
它不只是做一颗自研芯片。按照目前规划,先进逻辑、存储以及部分上下游制造能力都可能被装进这套体系,用来服务汽车、机器人和未来的数据中心。
谷歌做张量处理器,可以把制造交给代工厂。亚马逊做Trainium,微软做Maia,也主要解决芯片设计。马斯克开始碰的是制造,这意味着他现在面对的已经不只是“英伟达的GPU太贵”,而是一个更长期的问题。当下一轮算力扩张,还要不要继续完全由别人决定。
Terafab当然不能让马斯克明天就离开英伟达,未来几年,他甚至可能成为英伟达更大的客户,但它已经暴露了马斯克的选择。
以前马斯克需要更多芯片,现在他开始需要生产芯片的能力。
02
扎克伯格开始生产AI以前吃不到的数据
就在马斯克继续往算力上游走的时候,扎克伯格遇到了另一种短缺。
10月7日,美国政府、Meta、谷歌DeepMind、Isomorphic Labs,以及扎克伯格夫妇创办的Biohub,共同推进一项总投入约18亿美元的“虚拟生物学计划”。
Meta、谷歌DeepMind和Isomorphic Labs共同投入3亿美元,美国能源部未来五年投入超过5亿美元,美国国立卫生研究院把此前超过5亿美元形成的数据和数据库体系接进项目。
值得注意的是,Biohub此前已经投入5亿美元,而这次投入的钱没有继续流向GPU。它开始进入细胞培养、空间转录组、实验测量、科研仪器和数据库。
原因不是AI突然改行做生物学,而是AI第一次遇到一种互联网时代没有解决过的数据问题。
ChatGPT、Claude以及其他大模型能够迅速扩张,一个基础条件是人类已经替它们完成了大规模数据生产。模型需要做的,是把已有的东西收集起来、清理掉噪音,再用算力读进去。
生命科学却不同。一种药进入肝细胞以后,会让哪些基因表达发生变化;某个基因被敲除以后,细胞会不会改变状态;同一种刺激落在不同组织里,会不会产生完全不同的反应。
这些答案不会因为互联网存在就自动出现,实验没有发生,数据就不存在。
Biohub要做的,就是把过去散落在一个个实验室里的科研过程,改造成一条能够持续生产训练数据的流水线。
目的不是简单多养一些细胞,而是让AI看到足够多的“输入——反应”,直到模型能够从总结过去,往预测下一次实验推进。
打通这一步,将会改变实验室和AI之间的位置。
从前AI站在实验之后。研究人员做完实验,把结果交给模型分析。
现在实验室开始进入模型训练过程。模型暴露出一块不知道的区域,实验室去制造对应数据。新数据回来以后,模型继续寻找下一块空白,然后再做下一轮实验。
于是实验室不再只是检验AI答案的地方,它开始成为AI的数据工厂。扎克伯格争的也就不再是几盒细胞,而是要抢先一步建立这座数据工厂。
Biohub计划最终开放部分数据,但商业资金支持的数据允许出资企业获得一段提前使用时间。
表面看是提前几个月,可时间的优势不只来自第一批数据,而会沿着数据——模型——实验——新数据一轮一轮往后累积。
这就是为什么扎克伯格争的并不是谁拥有一批细胞,而是谁先拥有第一轮实验结果,以及谁能把这点时间差继续滚进下一轮实验。
互联网时代,大量训练数据已经摆在那里,科技公司主要争夺算力和模型。
到了生命科学时代,一部分最有价值的数据还没有出生。谁控制实验设备、样本、细胞和实验流程,谁就拥有生产下一批数据的入口。
03
AI开始重新给现实世界定价
扎克伯格不是唯一一个往生命科学里走的人。
9月,Anthropic确认已经在旧金山湾区建立湿实验室。Claude开始从DNA数据库里寻找规律、提出实验方向,再由实验人员完成验证。几天后,Anthropic公布第一项成果,Claude参与识别出一套具有类似CRISPR基因编辑系统特征的酶系统。
10月7日,同样的路线又从AI公司蔓延到实验设备公司。
丹纳赫宣布,计划在2027年初让首个AI自主研究实验室进入规模运行。AI负责设计,机器人负责制造和测试,仪器读取实验结果,再把数据重新送回模型。
丹纳赫预计,这套系统可以把相关分子发现速度提高至原来的8倍,并把年度靶点结合分子的生成能力提高至原来的10倍。
三家公司放在一起,方向已经很清楚,扎克伯格负责大规模生产生物数据,Anthropic让模型开始参与实验。丹纳赫则把仪器、机器人和AI接成自动化流程。
AI生命科学正在从过去的“模型分析已有数据”,往另一套体系移动:模型提出方向——实验产生结果——结果返回模型——模型再设计下一轮实验。
这套循环一旦建立,生命科学里的资产价值也会跟着移动。
过去几年大家争模型,随后争GPU。现在,实验设备、测序平台、空间转录组、细胞培养、药企历史研发数据,也开始进入AI竞争。这里面甚至包括需要失败的数据和结果。
礼来积累十年的药物研发记录,某个药企做失败的靶点,一个没有通过临床的分子,这些过去只能躺在内部数据库里的信息,都可能变成模型下一轮训练需要的反例。
互联网公司靠公开数据训练出了第一代大模型,生命科学不会这么便宜。实验要做,样本要拿,细胞要养。当然,失败也会一遍遍发生。
所以马斯克建Terafab和扎克伯格投Biohub,看上去隔着两个行业,底层动作却出奇地一致。马斯克担心算力受制于人,于是往芯片制造走。扎克伯格担心模型最后只能吃别人已经做出来的数据,于是往实验端走。
一个要掌握算力的生产能力,一个要掌握数据的生产能力。本质上,都要把安全感掌控在自己手里。
过去两年的AI竞赛,比的是谁手里的GPU更多。接下来,它开始同时争夺两种以前分属不同产业的生产资料。
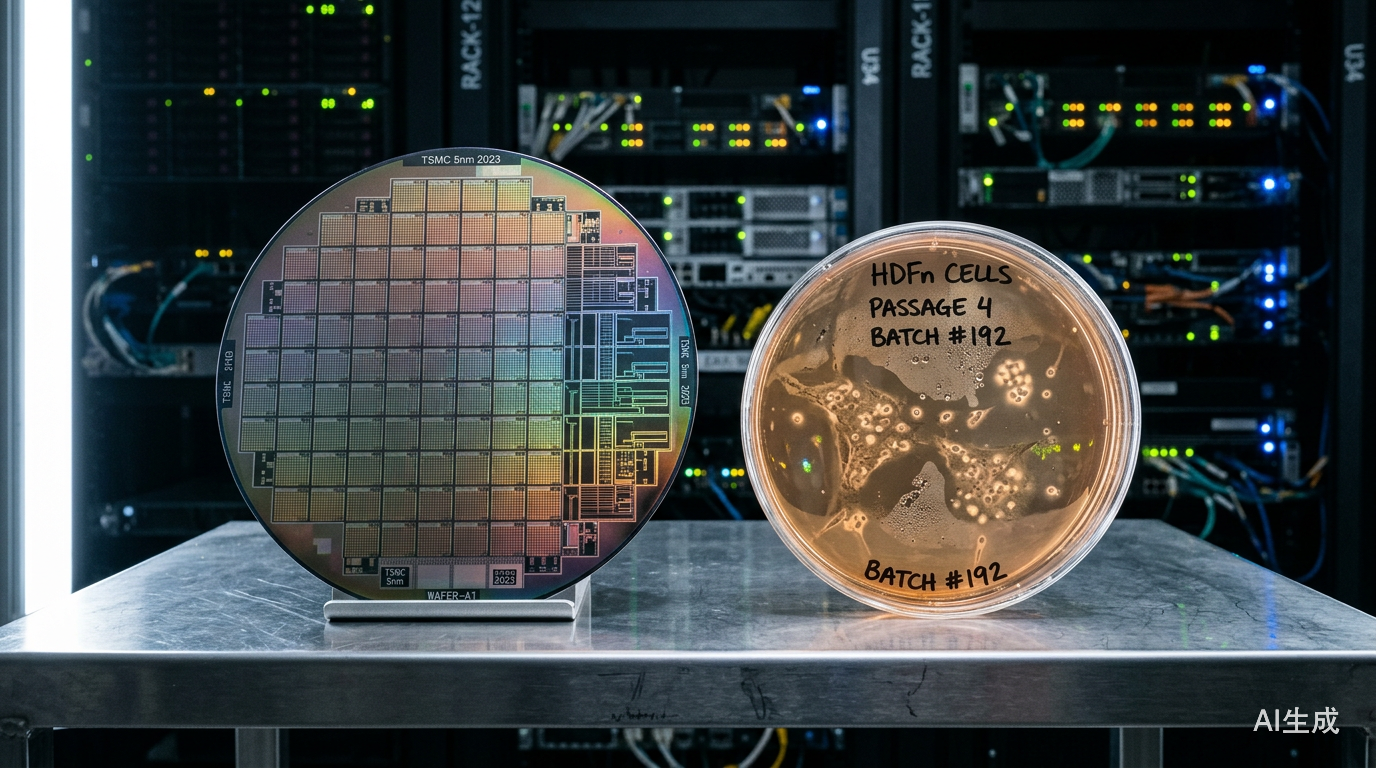
一个是晶圆,一个是细胞。
只不过AI走得越远,越是要回到现实世界寻找下一块生产资料。