本文来自微信公众号: 智核pro ,作者:伯克
9月17日,Rhodium把中美AI放到了一张表里。最扎眼的并非谁的模型更强,是两边模型的价格正好反着走。用户这边,中国模型便宜得多。即使今年已经经历一轮涨价,主流前沿模型完成一次标准化任务,大多仍只需要0.04—0.5美元;Claude最强一档大约需要2—4美元。
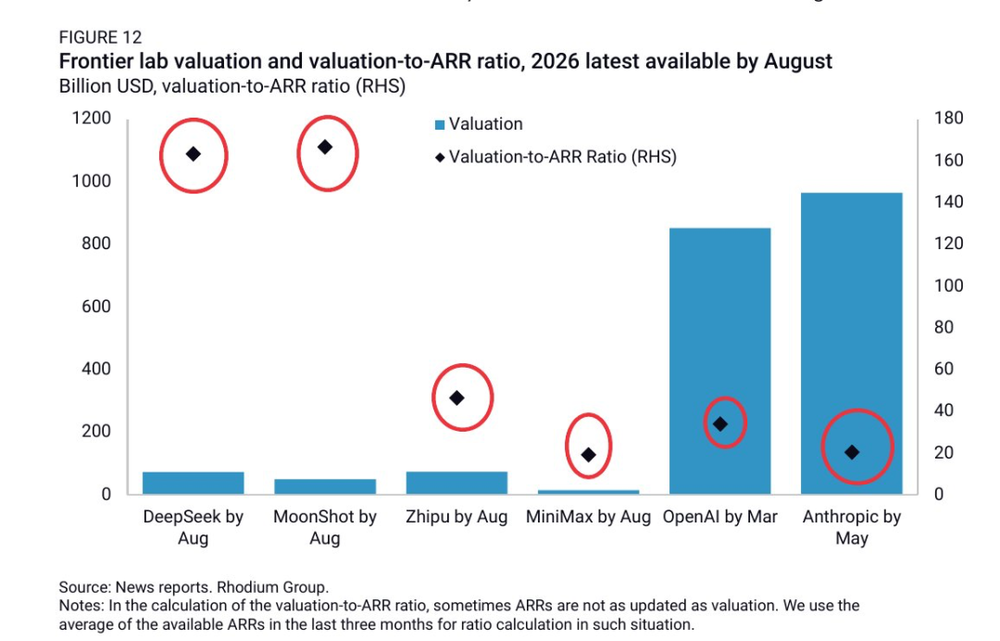
但到了投资人这里,价格关系反了过来。DeepSeek每一美元ARR背后对应约163美元估值,Moonshot约50美元;OpenAI约34美元,Anthropic约21美元。中国模型卖给用户更便宜,一美元收入反而卖得更贵。
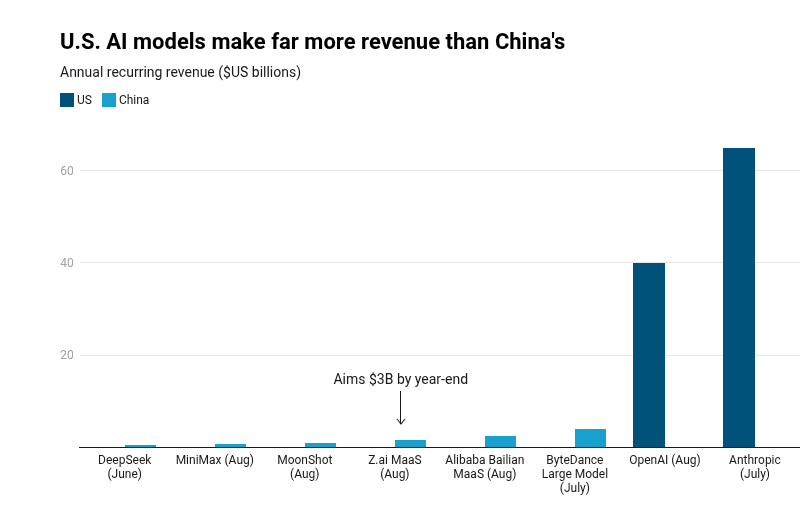
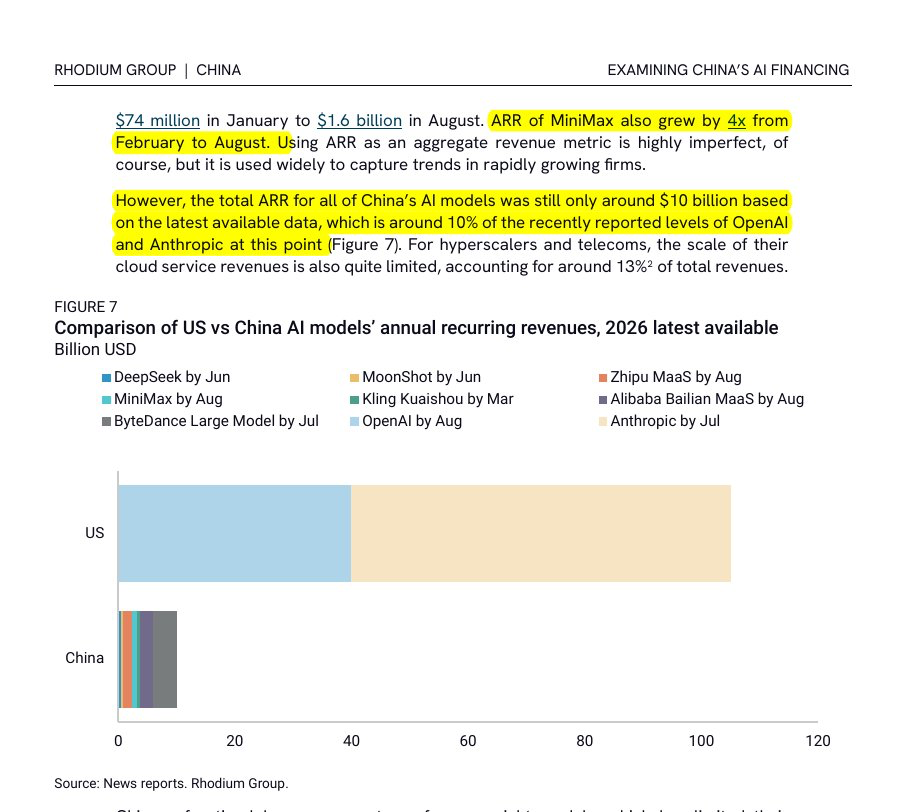
真正拉开距离的,还是收入。按最新月收入年化估算,中国主要模型业务ARR合计约107亿美元;OpenAI约400亿美元,Anthropic约650亿美元。后两家公司加起来,接近整个中国模型阵营的十倍。
用户买中国模型更便宜,投资人买中国模型的一美元收入却更贵。资本市场到底在为哪一段尚未出现的收入付钱?
智能先走出去,钱没有一起回来
8月,五源资本合伙人孟醒从旧金山机场出来,沿101高速往南开。这条路过去几年像一张硅谷创业公司的实时榜单,两年前是SaaS,后来是数据库、AI Coding。今年,他看到Kimi也买下了一块广告牌。附近还有越来越多Codex和Claude Code的广告,几家公司在争同一批湾区工程师。
一家北京公司花钱让硅谷工程师记住自己;这些工程师最后在哪里运行Kimi、把钱付给谁,却没有唯一答案。这和过去中国软件出海的逻辑不一样。传统SaaS企业进入美国,需要自己获客、签合同、收订阅费。收入和产品通常长在一起。
问题在于,开放模型一旦离开实验室,模型和收入之间的关系就开始变松。企业可以把权重下载到自己的服务器,云厂商也可以部署一份,再把API卖给自己的客户。模型可能每天都在被调用,原来的实验室却不一定能从每一次调用里收到钱。
Rhodium在9月17日的报告里专门指出,中国开放权重模型目前被第三方云平台托管以后,平台通常不需要向原始实验室支付许可费用。中国模型因此获得了很强的分发能力,也让“使用规模”和“公司收入”成为两件更容易分离的事情。
7月K3发布以后,美国科技媒体很快开始讨论中国模型与Claude、GPT之间的差距。中国模型由此获得了一个很少见的位置:使用和影响力已经走出去,收入还没有完全跟上。
美国头部实验室的商业分发同样会经过云平台,但闭源模型通常保留了一条更明确的收费关系。Claude被企业调用,钱大多仍然回到Anthropic;GPT进入企业,OpenAI也更容易把客户和账单一起留在自己手里。Rhodium做这组比较时,采用的Anthropic年化收入约为650亿美元,OpenAI约为400亿美元。一天后,《纽约时报》又披露,预计到2026年底,Anthropic年化收入将超过1000亿美元。
不过,月之暗面、阿里也开始补这条链路,8月26日,路透社披露,月之暗面正与微软、Amazon和Google讨论Kimi K3的收入分成。谈判还在早期阶段,Moonshot希望从这些云平台销售K3产生的收入中拿到最高30%;双方还要解决Token使用量审计、数据访问和分成方式。
中国模型过去很擅长解决“怎么出去”,低价解决使用门槛,开放权重解决部署门槛,工程效率把推理成本继续往下压。门槛打下来以后,剩下的反而是一道很老的商业题:这些使用量,最后由谁收钱。
这也是为什么只比较中美模型ARR,很容易漏掉一部分东西。OpenAI和Anthropic把更多价值留在公司收入里,国内模型则把一部分价值留在了开发者、云平台和下游应用手上。前一种更早出现收入,后一种获得更快的扩散。
这些高倍数隐含的一个核心假设是:今天散在云平台、开发者和下游应用里的价值,未来会有更多回到模型公司的报表里。
Token可以赚钱,公司还是很亏
低价模型还有一个很容易被误解的地方:便宜,不一定意味着这一枚Token亏钱。
DeepSeek给了一个很直接的反例。Rhodium援引的数据称,截至今年7月,DeepSeek API业务毛利率达到约83%,已经接近Anthropic API业务80%以上的水平。它卖得便宜,但模型结构、推理效率和基础设施优化足够好,一次调用本身仍然可以留下很高的毛利。
所以,低价本身并不是中国模型最难解决的问题。一个API请求只需要承担这一次推理的成本,一家前沿实验室还要承担下一代模型。这中间隔着训练集群、RL、数据、environment、失败实验和一批今天没有收入、但可能决定半年后竞争位置的研究项目。
MiniMax上半年的财报,刚好把这两笔钱摆在了一起。上半年,公司收入1.166亿美元,同比增长283.1%;毛利2081万美元,毛利率17.9%。但同期研发费用达到2.969亿美元,是收入的2.5倍以上,经调整净亏损2.93亿美元。公司解释,研发支出增长很大一部分来自模型迭代增加后带来的训练云服务费用。也就是说,一批已经付费的企业客户可以让当前API产生毛利,研发团队却已经在花下一代产品的钱。
模型公司真正难的地方就在这里,传统SaaS的一套产品架构可以在多年迭代中持续摊薄研发成本,前沿模型的能力领先窗口却短得多:这一代刚开始收费,下一轮训练往往已经启动。今年7月,MiniMax的Token消费量已经是1月的20倍。需求增长本身是好消息,但需求越多,推理机器也要跟着工作;模型能力继续往前,研发账单还要另算。
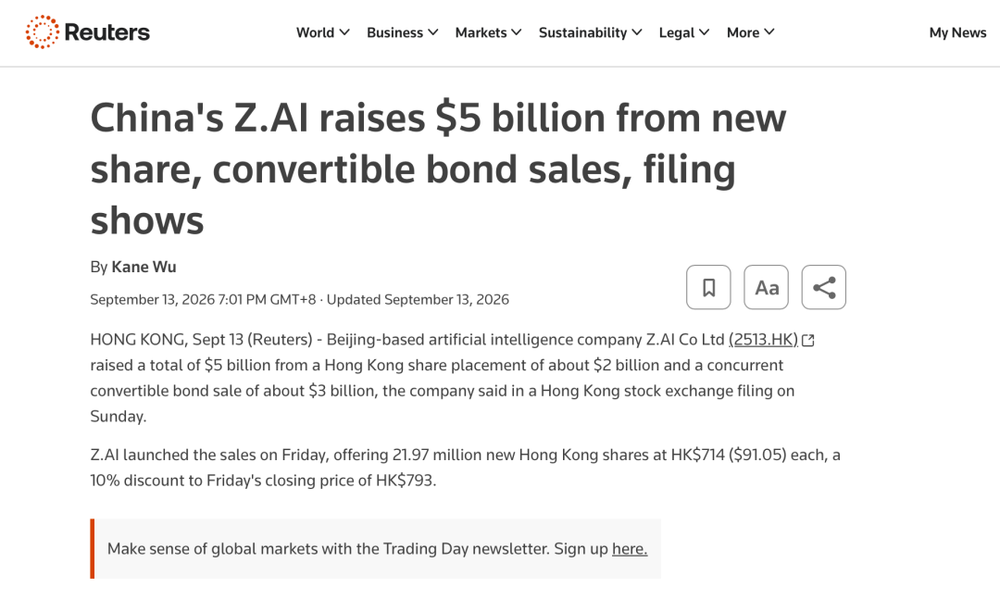
智谱的资金需求更直接。今年1月IPO募资约40亿元,7月又完成约270亿元H股配售;9月13日,再通过新股和零息可转债一次拿到50亿美元。与此同时,其8月MaaS ARR约16亿美元。模型调用已经成为生意,但资本仍然在以前所未有的速度进入资产负债表。
中国AI下一阶段真正需要跑通的,是三条曲线:价格继续下降,调用量继续增加,单位成本下降得更快。只要后两条能够跑过研发、算力和获客投入,便宜完全可以是一种健康的商业模式。
MiniMax和智谱的财报提醒了另一件事:一笔调用能赚钱,距离一家实验室能够自己养活自己,中间还隔着下一代模型。这里甚至存在一个反直觉的阶段:模型越成功,公司短期越可能缺钱。用户增加,需要更多推理算力;开发者增加,需要更大的服务容量;模型排名上升以后,公司又更难停下下一轮训练。
增长会先带来收入,也会把下一张算力账单提前送到。一个互联网产品用户暴涨,服务器费用当然会上升;一个前沿实验室用户暴涨,还可能同时触发下一轮几十亿美元级别的模型竞赛。所以中国AI真正要证明的,从来不只是“能不能涨价”。它需要证明:越卖越多以后,能不能越赚越多。
客户还没付够的钱,资本市场先付了
9月初,路透社报道,月之暗面已经以保密方式提交香港IPO申请,计划募资约30亿美元,公司当时估值约500亿美元。十一天后,DeepSeek准备请高瓴创投合伙人严文涛担任公司首任CFO,为可能的科创板上市做准备。
模型公司开始越来越频繁进入资本市场,原因并不复杂:维持前沿竞争,需要持续购买越来越多的算力、人才和基础设施。Rhodium统计,智谱、MiniMax、DeepSeek和Moonshot四家公司在2025年获得的PE、VC投资合计约90亿元。进入2026年前八个月,把PE/VC、IPO和定增算在一起,股权资金规模已经升到1790亿元。
模型公司的融资只是其中一部分。真正的大头,还在数据中心和算力。Rhodium统计的13家中国主要AI基础设施参与者今年AI基础设施投资将达到9320亿元,同比增长103%;2027年可能超过1.2万亿元。
放在这样的资金需求里,那些看起来夸张的ARR倍数,至少多了一层解释。这些倍数当然不能直接证明中国AI就应该值这么多。ARR来自不同时间点的月收入年化,各家公司业务结构也并不一样;Moonshot自己的估值从2025年底约40亿美元升到今年8月500亿美元,估值增长甚至明显快于收入。
但它们确实指向一种很清楚的资金关系:客户今天还没有支付的钱,资本市场先替模型公司付了一部分。
一个企业今天用Kimi开放模型,可能把费用付给AWS,一个开发者自己部署DeepSeek,原模型公司甚至没有收入。但投资人相信,这批使用量以后会变成企业合同、云分成、订阅、Agent收入或者其他尚未成熟的商业模式。于是未来的收入,被提前放进了今天的估值。
这在科技行业并不陌生。Amazon曾用多年亏损换规模,Uber靠补贴同时扩大司机和乘客网络,不少SaaS公司也依靠融资提前建设销售体系。但前沿模型和上一代互联网公司还有一个区别,上一代产品还没有收回全部投入,下一代产品已经开始花钱。
资本可以替用户垫一段时间的钱,却不能永远替用户付款。美国实验室也烧钱。差别在于,它们今天有一个更大的收入底座。OpenAI约400亿美元ARR,Anthropic约650亿美元。这意味着即便基础设施投入继续增长,它们已经有更多当期收入进入下一轮训练。
中国模型目前的循环更长,先把模型做便宜、开放出去,把使用量做起来;再依靠融资继续训练下一代,同时寻找云分成、企业合同、订阅和Agent等方式,把已经形成的使用量重新变成收入。这条路能不能成立,最终取决于最后一步能回来多少钱。
便宜和开放当然也换回了东西。中国模型更容易进入开发者的电脑、企业自己的服务器,以及海外云平台。价格被压得足够低以后,一些过去舍不得交给大模型做的任务,也开始变得划算。
类似的价格竞争,也开始更明显地出现在美国市场。7月30日,OpenAI把GPT-5.6 Luna的API价格一次降了80%,Terra降了20%;一周后,又把免费版ChatGPT的默认模型换成Luna,并开放不限量文本对话。8月,Sol的API和Credits价格也阶段性下调超过20%。
OpenAI没有放弃最贵的模型,但它也开始用更便宜的一档去抢更大的使用量。美国头部实验室在降价的同时,仍尽量守住收费关系;中国开放模型则要解决,已经出去的使用量怎样补上回款链路。
写在最后
两年前,一个中国AI公司最容易被问的问题,是模型距离GPT还有多远。今天Kimi已经把广告牌买到了旧金山,中国开放模型也开始进入美国工程师的日常工作。问题正在从“模型能不能出去”,变成“出去以后,价值能不能回来”。用户购买中国智能越来越便宜,投资人购买中国AI的一美元收入却越来越贵。
智谱MaaS ARR从今年1月7400万美元升到8月16亿美元,MiniMax的ARR在2月至8月增长约4倍,国内模型的商业化速度已经明显加快。但前沿模型最终仍然绕不开一个最普通的商业问题:融资可以购买GPU,估值可以延长跑道,真正能够长期支付下一轮训练的,仍然只能是客户。
过去三年,中美AI的比较表里塞满了参数、Benchmark、GPU数量和Token价格。接下来可能还要多加一列:上一代模型赚的钱,够不够付下一次训练。这是一个很普通的财务问题,却可能比很多模型指标更难回答。只要每一次模型升级仍然需要重新向资本市场要一大笔钱,公司就还没有完全走出融资驱动的阶段。
融资可以买GPU,估值可以换来时间。最后能让一家实验室一直留在牌桌上的,还是客户付进来的钱。上一代赚的钱,能不能把下一代做出来。