
本文来自微信公众号: 蓝字计划 ,作者:Chester
Meta的AI翻身仗,不仅打了一半就翻车,还被马斯克捎带手嘲讽了。
10月12日,Meta发布了最新AI模型Muse Wonder和Muse Wonder Full。为了在下一轮AI竞争中重新拿回主动权,Meta过去一年疯狂砸钱建设算力基础设施,四处高薪挖角顶尖研究员,这两款模型正是其押注数百亿美元后的核心交卷之作。
光看纸面成绩,Muse Wonder确实挺争气。
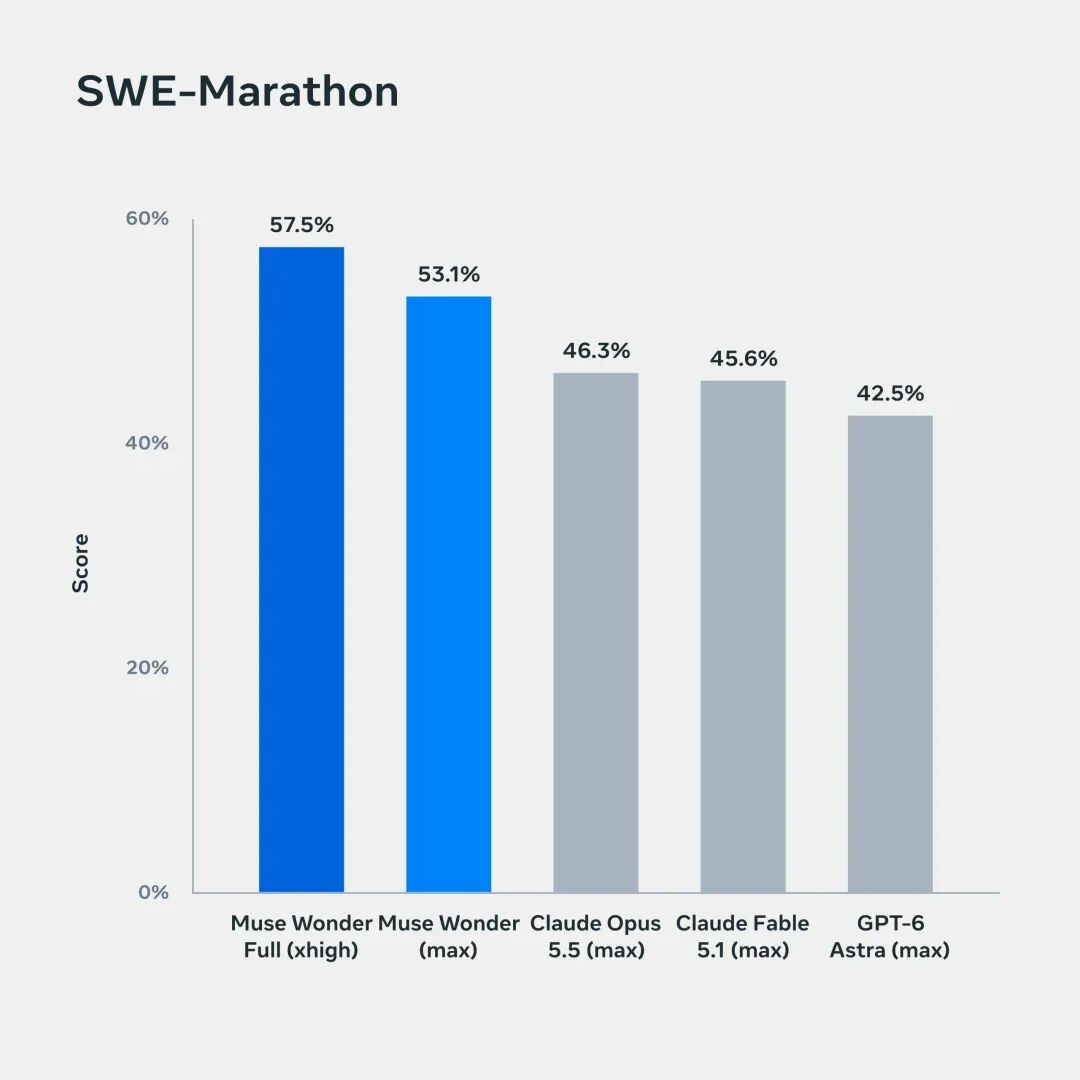
按照官方公布的数据,新模型在多项主流AI基准测试(benchmark)里直接杀入第一梯队。尤其在考验软件工程能力的SWE-Marathon测试中,Muse Wonder Full甚至压过了部分OpenAI和Anthropic的看家模型。
谁知帅不过三秒,在测评机构BridgeMind随后组织的一场实测里,Muse Wonder翻车了。
测试要求很简单:让AI制作一盏带有透明玻璃外壳、动态熔岩效果和真实光影变化的熔岩灯。
结果Muse Wonder交上来的作品既没有玻璃的通透感,里面的熔岩也动不起来,看着就像个随手糊弄的普通台灯。
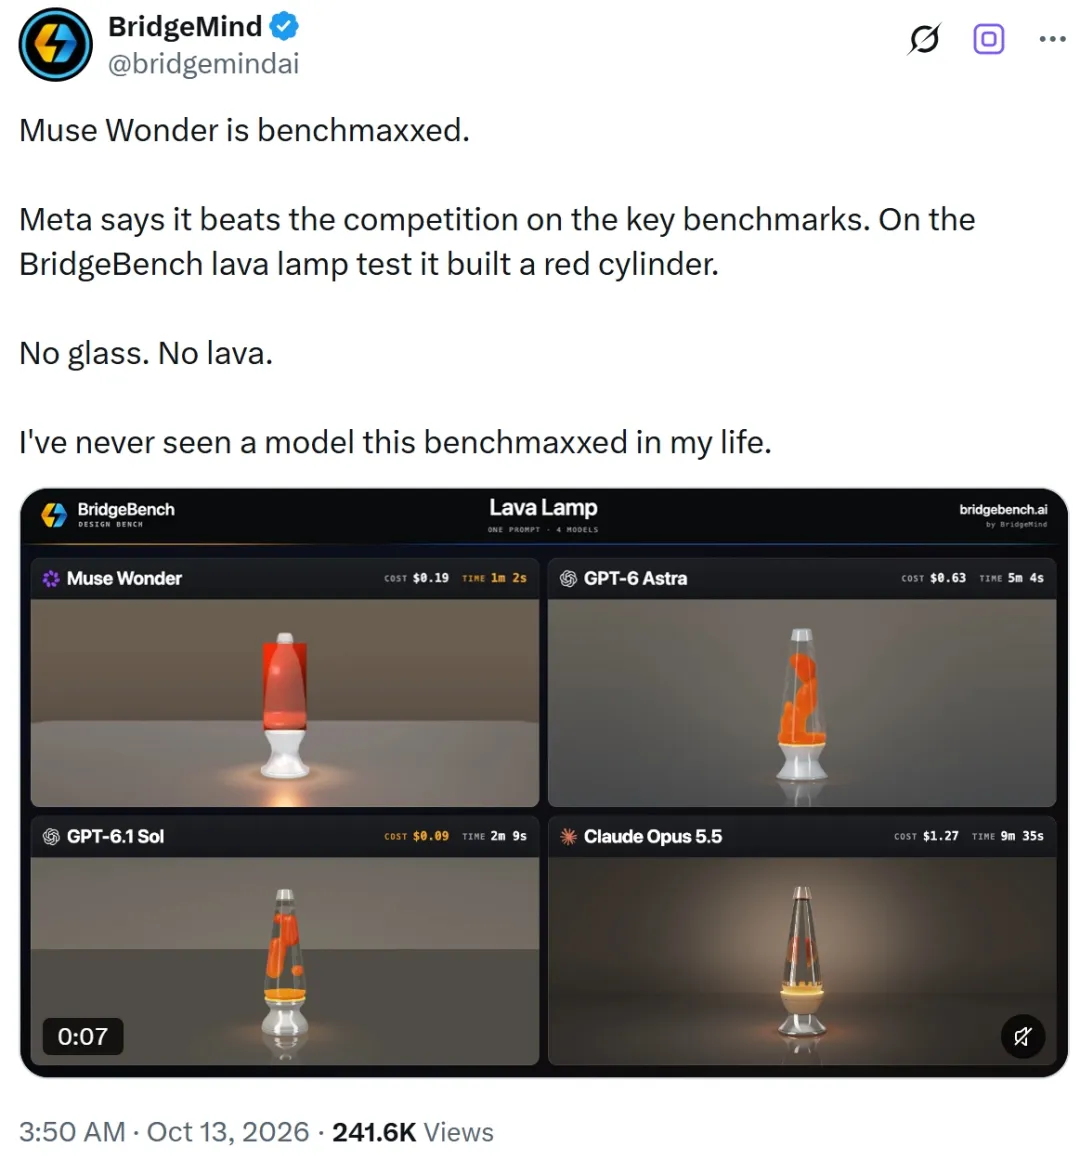
这么低级的失误直接引来了马斯克围观,他在X上留了一句意味深长的“Hmm”。
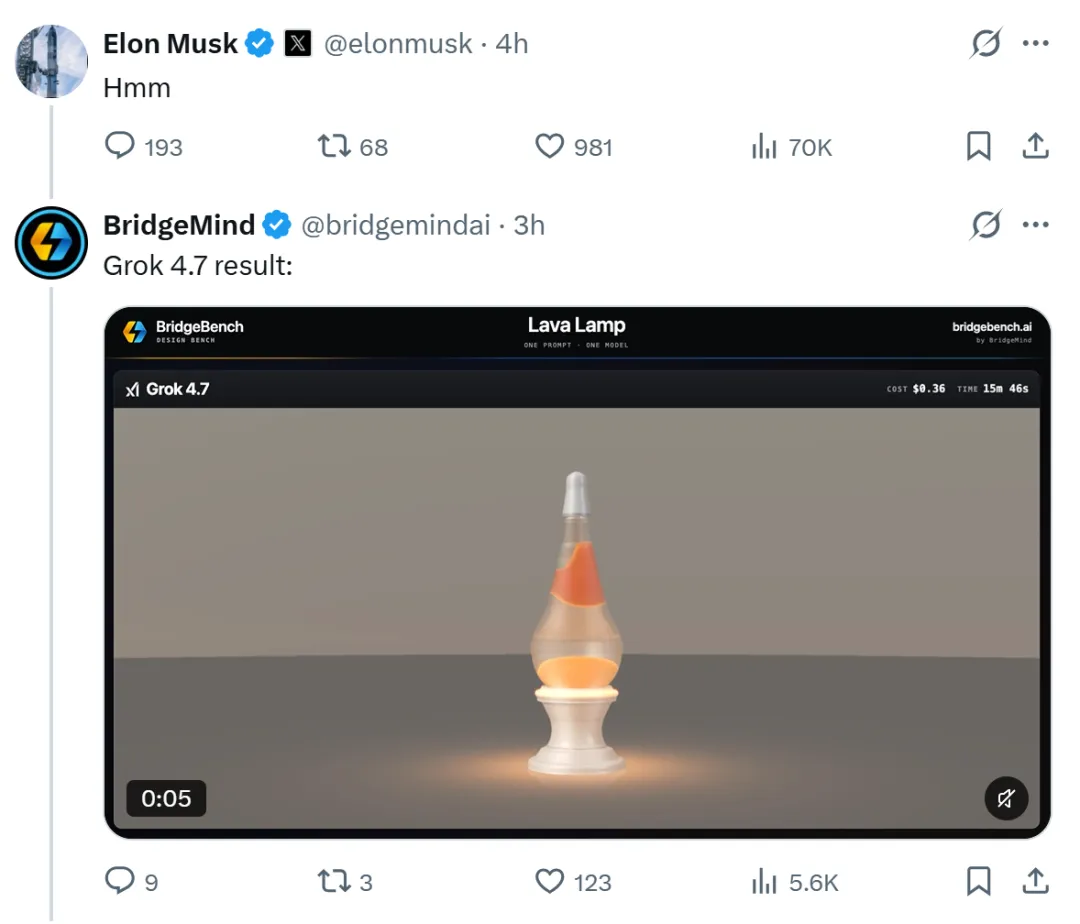
花了数百亿美元,Meta难道只练出了一个擅长应试的“做题家”?
Meta AI需要一场翻身仗
过去几年,夹在OpenAI、Anthropic和Google DeepMind中间的Meta,处境一直挺尴尬。
手里握着全球最大的社交平台矩阵,也有Llama开源模型攒下的开发者生态,偏偏在最核心的闭源顶尖大模型牌桌上,Meta始终慢人一步。眼看GPT和Claude轮番刷新能力上限,扎克伯格只能憋屈地扮演追赶者。
小扎心里苦呀。
扎克伯格明显坐不住了。为了改变这一局面,在过去一年里他除了砸重金囤积算力,Meta还专门拉起了一支超级智能团队,把Scale AI创始人Alexandr Wang招致麾下,又从OpenAI和Google DeepMind挖来大批核心骨干。
Muse Wonder就是这场豪赌砸出来的阶段性成果。平心而论,这次新模型倒也真有两把刷子,在不少高难度任务里摸到了顶级模型的门槛。
比如在Artificial Analysis Intelligence Index综合测试中,Muse Wonder Full拿到56分,普通版也有52分,夹在Claude Opus 5.5(58分)和GPT-6 Astra(53分)之间。
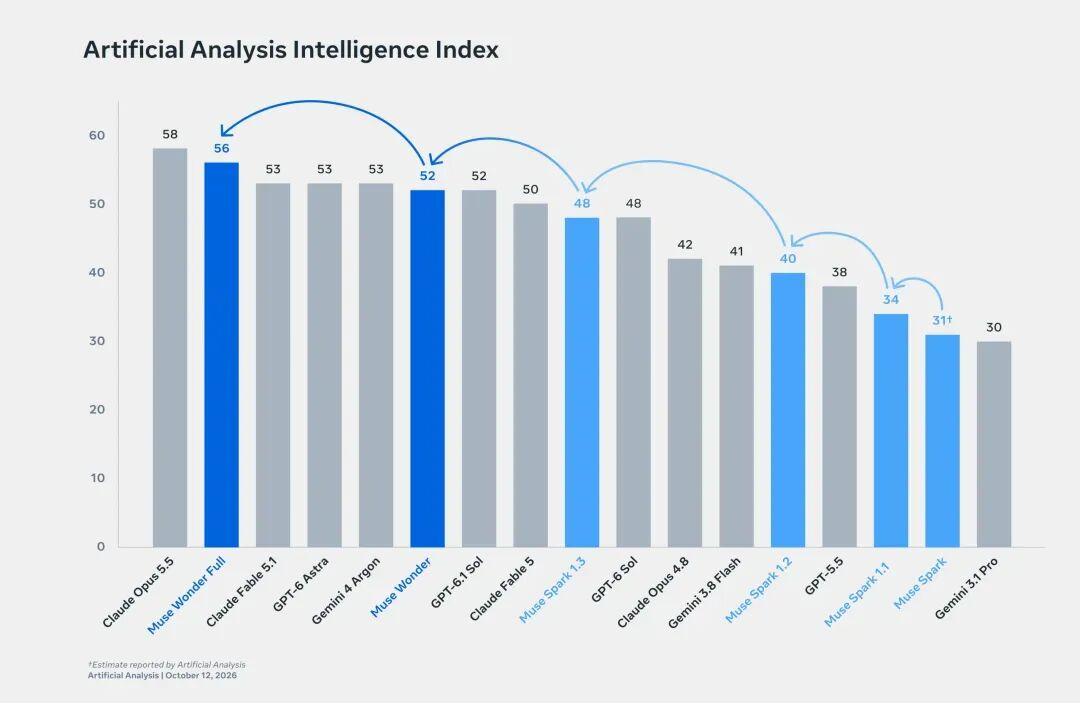
虽然还没能把对手杀穿,但确确实实挤进了当前最强模型的第一梯队。
不过真正让它打出名堂的是写代码和专业垂直任务。
在考察代码库理解、问题定位和长期开发能力的DeepSWE 1.1测试里,Muse Wonder两款模型分别拿下79.0分和78.8分,双双把74分出头的Claude Opus 5.5和GPT-6 Astra甩在身后。
到了耗时数小时的SWE-Marathon长期软件工程测试,差距拉得更大:Muse Wonder Full跑出57.5分,直接断层领先Claude Opus 5.5的46.3分和GPT-6 Astra的42.5分。
代码之外,它在Harvey LAB-AA法律任务测试(13.1分)和AutomationBench-AA企业工作流测试(45.4分)里,也全面压过了GPT-6 Astra(8.6分、41.6分)和Claude Opus 5.5(4.2分、41.2分)。
也就是说至少在这些特定专业场景里,Meta总算有了跟OpenAI、Anthropic正面掰手腕的底气。
另一方面,比起跑分,更值得留意的还有Meta战略风向的转变。
以前Meta靠Llama系列打天下,核心逻辑是用开源生态去影响行业;这次推出Muse Wonder,重心明显转向了离普通人更近的个人AI助手。
新模型主打的“长期记忆”和“持续执行任务”,瞄准的正是下半场的竞争核心:哪家能真正地让AI走进用户每天的工作和生活里。
而这也是Meta最大的优势所在:它拥有Facebook、Instagram、WhatsApp等覆盖数十亿用户的平台。如果模型能力和产品生态能够结合,Meta完全有机会在AI时代翻盘。
偏偏在这个节骨眼上,那盏拉胯的熔岩灯,给这场翻身仗泼了一盆冷水。
AI“做题家”?
事情的起因,是测评机构BridgeMind在官方跑分出炉后,拉着几个主流大模型做了一轮开放式的真实世界任务测试。前面提到的“制作透明动态熔岩灯”,就是其中的一道考题。
看到Muse Wonder生成的那坨完全不搭边的玩意儿后,BridgeMind毫不客气地抛出了一项指控:这模型八成是在搞“Benchmaxxing”(刷榜应试)。
这个词最近在AI圈被提得越来越多,说白了就是专门针对测试题库做定向优化,好在发榜时刷出漂亮分数,跟学生在考前疯狂押题、刷必考卷是一个路数。
基准测试当然有用,研究人员得靠它来衡量模型在推理、代码、数学和知识理解上的底子。可一旦顺着题库死磕,很容易就养出一个高分低能的“做题家”。
毕竟现实世界里的任务哪有什么标准答案。真实用户打开对话框,肯定不会像题库那样发出指令:“请作答第1354题。”
大家甩过来的全是“帮我设计个产品”、“盘一下这个商业方案”或者“跟进这个复杂项目”。模型要自己去揣摩模糊的意图,结合现实背景,再边干边根据反馈调方向。
正因如此,BridgeMind觉得Muse Wonder的病根就在这儿:只要题目边界清晰、结构明确,它就能拿高分;一旦丢进开放式的真实场景,表现立马跳水。
就拿这盏熔岩灯来说,虽说市面上不少AI工具都能轻松搞定,但真要做对,挺考验底层硬功夫的。
首先AI得同时吃透好几个现实世界的物理概念,比如透明玻璃决定了材质反射和光线折射,动态熔岩牵扯到流体运动规律,真实光照又得算准空间位置关系。
这时AI背下再多题库知识也没用,核心还是得看模型能不能把几句文字描述,真正转化为对物理世界的空间理解。
当然,抛开拉胯的熔岩灯不谈,哪怕回到官方引以为傲的跑分榜单上,Muse Wonder的高分同样经不起细抠,争议最大的就是那项断层领先的SWE-Marathon。
很多人没注意到一个关键细节:SWE-Marathon测的根本不是单打独斗的裸模型,这个测试实际上更加接近于对一整套AI编程Agent系统的综合考试。
翻开Meta自己公布的模型说明卡就能发现,这一测试并不是在完全统一的条件下进行的。测试过程中,各家模型手里拿的武器各不相同:GPT-6 Astra挂的是Codex,Claude Fable 5.1用的是Claude Code。
而这些工具本身,也会影响最终结果。换句话说,SWE-Marathon比较的不只是模型本身,还包括模型背后的Agent框架、工具调用能力和任务执行流程。
甚至说不定,有好的Harness,比模型的智商本身更加重要。
我们都误会Meta了
事实上,可能我们误会Meta了。
我们觉得Muse Wonder该是一个豆包式的通用智能体,但人家可从来都没有这样讲过。
所以在发布新模型时,Meta压根没怎么提参数规模,反倒花大篇幅讲了两个落点:主动记忆、主动专注。
所谓主动记忆,就是让AI跨对话留存用户的关键信息。之前聊过的项目进度、个人习惯和任务背景,模型全记在脑子里,下次开口不用再重头交代一遍上下文。
主动专注则是为了治一治现在AI Agent的通病:干活干到一半突然跑偏忘词,或者碰上点报错就直接原地罢工。
Meta希望Muse Wonder能够在复杂任务中持续推进,并根据情况调整方案。
这两个卖点,其实已经足以说明Meta的野心。
过去这几年,OpenAI靠着ChatGPT死死卡住了最强的流量入口,Anthropic则凭着Claude Code等利器在企业和开发者圈子里攻城略地。
至于Meta,手头最硬的牌还是那套别人抄不走的用户生态。从Facebook、Instagram、WhatsApp,到正在起量的AI智能眼镜,全都是现成的分发渠道。
实际上Meta已经在紧锣密鼓地把Muse往各种硬件终端里塞了。
前阵子的Meta Connect大会上,官方就宣布Muse即将接入智能眼镜,用户动动嘴就能喊AI帮自己监测运动训练、随手记备忘、订餐厅,甚至看到中意的商品直接语音下单。
与此同时,Meta也在拓展Muse的电脑操作能力。按照官方规划,未来Muse能直接跑在用户的Mac电脑上,接管打开软件、整理文件夹这类日常琐事,把零散的操作串成连续的工作流。
正因如此,说不准扎克伯格根本不在乎自家模型在单次聊天窗口里能不能写出最漂亮的回答。要抢先变成用户每天离不开的贴身助理,才是Meta现在的战略主线。
或许正是看懂了这层布局,Muse Wonder发布后,华尔街迅速调高了对Meta AI战略的预期。
但事情真的有那么顺利吗?
在测试题库里大杀四方的模型,放到千奇百怪的真实场景说不定只是个小废物。已经有越来越多的AI用户在社交媒体上质疑:
怎么你们这些AI博主随手一测都是精美、细致、美观的演示,但我怎么手搓出来的,却只是一个根本不可用的废品?
哪怕出一次像“熔岩灯”那样的低级岔子,用户的信任感都会瞬间清零。
更何况在Meta的社交基本盘里,AI助手每天都有可能大量接触用户的个人隐私。要知道,Meta这家公司在对待用户的个人隐私方面,一直就没有太好的口碑。
Muse Wonder这几个英文字母,背后是几百亿美元真金白银的投入。这场盛大的赌局,断不可能那么轻易地得到答案。