本文来自微信公众号: 斯凯碎碎侃 ,作者:斯凯,原文标题:《焦点|DeepSeek突发宕机:AI时代,我们该如何守住自身的技术利益》
今天早8点,DeepSeek网页端、App、V4.1 Flash API、V4.1 Pro API同步出现大面积中断。截至发稿,部分服务仍未完全恢复。对普通用户来说,可能只是少聊了几句天;但对那些把业务链路全部绑在大模型上的中小企业、开发者来说,这持续数小时的服务中断,可能就是直接的订单损失和服务违约。一次技术故障,撕开了很多人刻意忽略的隐患:我们以为自己在用AI,实际上,可能是把业务命脉托管在了别人的服务器上。
DeepSeek这次宕机,不是什么新鲜事。往近了说,这已经是2026年以来DeepSeek至少第18次大面积服务异常,3月底甚至出现过超12小时的长时宕机。往远了说,海外OpenAI、Anthropic过去两年也都发生过大范围服务中断、API突然涨价、旧版接口强制下线;再往远了看,任何一家公有云服务商,都不敢承诺全年零故障——头部云厂商的SLA通常承诺99.9%或99.95%可用性,但大模型服务商的SLA标准尚未统一,很多中小厂商的合同里甚至不承诺可用性。技术系统永远有概率出问题,这本身不可怕。
真正值得讨论的是:当一家企业的核心业务,全部寄生在某一个外部大模型的接口上,这种架构本身,就埋着一颗定时炸弹。
一、企业层面:你以为在用AI,其实是在给平台打工
先看最直观的场景。
这两年大量创业团队、中小公司做AI应用,路径高度一致:产品壳子自己写,核心智能全部调用公有大模型API。省成本、上线快、不用养算法团队,看起来是聪明的轻资产模式。
但代价是什么?
第一,业务命脉不在自己手里。模型服务商今天宕机,你的产品就瘫痪;明天调价,你的成本结构就全乱;后天接口规则改了,你几个月积累的提示词工程、业务流程全部要推倒重来。你没有任何议价权,因为你的产品本身就长在别人的地基上。
第二,数据裸奔。你的客户资料、内部文档、业务逻辑,全部通过API传到对方服务器上。数据到底会不会被用于训练、留存多久、谁能访问,普通中小企业根本没有能力和平台逐条博弈。很多团队嘴上说做AI应用,实际上是在帮大模型厂商喂数据。
第三,最核心的资产没有沉淀。很多AI产品翻来覆去就是套壳聊天,真正的壁垒——行业知识库、业务流程、客户关系——一个都没建立。模型一换,产品直接归零。你以为自己在做产品,其实只是在做一层随时可以被绕过的包装。
这不是某个企业的问题,是整个行业在AI爆发期的集体shortcut。大家都想快速上车,却很少有人停下来问一句:上车之后,方向盘到底在谁手里?
二、产业层面:技术自主,不等于从零造一个大模型
把视角拉高一层,这就是AI时代的"技术依附"问题。
过去我们谈芯片谈操作系统,担心的是底层技术被卡脖子。现在大模型成了新的基础设施,如果千千万万的政企应用、垂直行业系统、中小企业产品,全部绑定在少数几家模型服务商身上,本质上是在制造新的单点依赖。目前国内大模型API市场,头部集中度极高,大量下游应用都压在少数几个基座模型上。
但这里有一个必须澄清的误区:守住技术利益,不是要求每家企业都自己训练一个大模型。
训练一个基础大模型,算力、数据、人才门槛极高,几千万上亿的投入,绝大多数企业根本承担不起,也没有必要。技术自主不是闭门造车,更不是拒绝使用成熟的外部工具。
真正的自主,是你拥有选择权。
什么意思?就是当一家模型服务商宕机、涨价、改规则的时候,你的业务能够在几小时甚至几分钟内,平滑切换到另一家模型,而不是直接停摆。你的业务逻辑、数据资产、用户体验,不应该和某一个模型深度耦合。
这就像你做生意,不会把全部货款存在一家银行里;你用云服务,也会做多可用区备份。为什么到了大模型这里,大家反而觉得"接一家就够了"?
三、五条可落地的底线:普通企业该怎么做
说回实操。对于大多数没有能力自研基座模型的企业和开发者,守住技术利益,其实有几条非常朴素的原则:
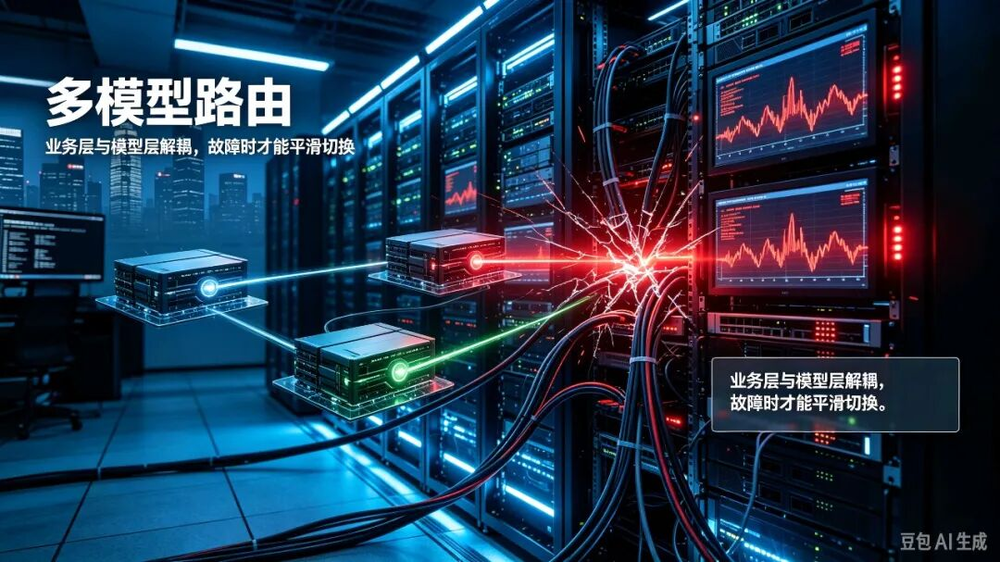
第一,架构解耦,多模型路由——这是今天就能做的事。业务层和模型层之间加一层抽象,同时接入两到三家模型API。哪家挂了,自动切到备选。这不是什么高深技术,就是工程层面的基本冗余设计。很多团队图省事,直接把某家模型的SDK焊死在业务里,一出事就抓瞎。
第二,敏感数据不上公有模型。核心业务数据、用户隐私、商业机密,能本地处理就本地处理。通用推理任务走公有API,涉及敏感信息的环节,用私有化小模型或者开源模型部署。数据边界划清楚,才是守住最核心的资产。
第三,你的护城河,永远在业务层。大模型是工具,不是产品本身。行业知识库、垂直场景的工作流、客户资源、品牌信任,这些才是真正属于你的东西。如果你的产品离开某家大模型就什么都不是,那你做的不是产品,是套壳。
第四,合同里把丑话说在前面。企业采购API服务,一定要看SLA——可用性承诺是多少?宕机怎么赔付?接口变更提前多久通知?数据使用边界怎么约定?很多小团队签约时连SLA条款都不看,真出了问题才发现,对方合同里写着"服务不保证可用性"。
第五,关注开源模型生态——这是需要中期布局的事。这两年开源模型进步极快,很多场景下,开源模型的能力已经足够支撑业务。基于开源模型做二次微调,权重掌握在自己手里,想部署在哪就部署在哪,这才是真正的自主可控。开源不是免费白嫖,是在构建自己的技术底牌。
四、更深一层:AI时代的"基础设施",需要多层次供给
放到国家产业层面看,今天DeepSeek宕机这件事,其实是一个提醒:
一个健康的AI生态,不能让所有下游应用都压在少数几个基座模型上。
理想的格局应该是:有头部闭源模型提供最强能力,有开源模型生态提供自主可控选项,有垂直行业的小模型做细分场景适配。企业可以根据自己的安全要求、成本预算、场景需求,自由组合,而不是被锁死在某一家。
这和能源领域的逻辑一模一样——不能把所有鸡蛋放在一个能源通道里,否则一有风吹草动,整个体系都会震荡。
AI基础设施的韧性,恰恰来自于它的多样性。
写在最后
DeepSeek今天的宕机,大概率几个小时后就恢复了,甚至不会上热搜。但它留下的问题,值得所有在用AI的人认真想一想。
大模型可以租用,API可以调用,但你的业务命脉,不能托管。
技术自主,也不是说要关起门来自己造一个最强模型。真正的自主,是当外部工具出问题的时候,你有备选、有切换能力、有自己不可替代的核心资产。
AI时代最大的风险,从来不是技术不够强,而是你把所有身家,都押在了别人的服务器上。
公有大模型好用、便宜、上手快,但依赖,就是中小企业最大的隐形负债。AI时代真正的核心竞争力,从来不是谁会套壳、谁会调用API,而是:谁能掌控自己的数据、自己的业务链路、自己的技术选择权。潮水退去,所有把命脉托管给平台的团队,都会被一次宕机、一次调价、一次接口更新彻底洗牌。