
本文来自微信公众号: 思策智库 ,作者:张自炯
最近刷到一条消息,截至2026年,Google DeepMind作为全球顶尖人工智能研究实验室,其开发的材料探索图网络GNoME,已有超过700种预测的新材料在全球实验室中被成功合成。
其中,包含528种潜在固态电解质候选、5.2万种类石墨烯层状化合物。直接为下一代锂电池、钙钛矿太阳能电池等领域提供了海量研发方向。
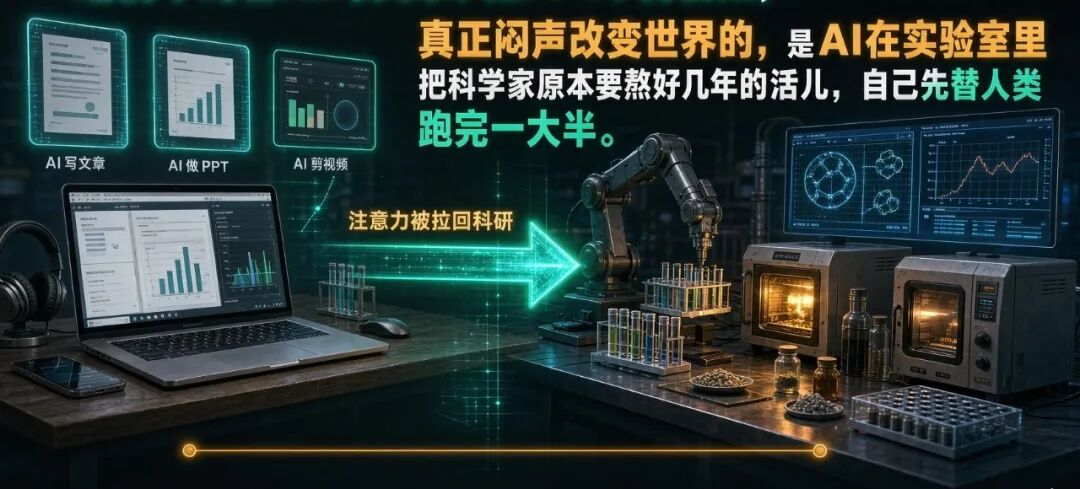
我第一反应是:我们平时聊AI写文章、做PPT、剪视频,其实都聊浅了。真正闷声改变世界的,是AI在实验室里把科学家原本要熬好几年的活儿,自己先替人类跑完一大半。
可问题来了——资本听这个故事听了三年,AI在物理、在生物、在材料里,究竟是个什么角色?
研究员?打字员?还是某种不领工资、不交社保、还比你更能熬的合伙人?
AI把科研从手工活,变成流水线
传统科研的苦,外行不知道。一个博士生前两年基本在养细胞、跑胶、调参数、等同步辐射机时。物理那边,算一个100原子体系的DFT,机器嗡嗡转几天,人就在旁边怀疑人生了。
AI进来之后,人在搜索成本的投入大幅降低。
DeepMind曾在Nature发表了AI材料科学的里程碑论文,核心成果是推出了名为GNoME的AI工具,革新了无机晶体材料的发现效率。原来人类靠直觉配元素、靠经验烧结、靠运气出论文,现在模型先把整个元素周期表里的奇怪组合在虚拟空间里翻一遍。GNoME仅用AI模型就预测出220万种全新潜在晶体结构,其中超过38万种被判定为热力学稳定的全新无机材料,相当于把人类过去数百年积累的已知稳定无机材料总量直接翻了一倍,业内称其“凝聚了过去800年的材料科研成果”。
AI读文献、出配方、机械臂配料、炉子烧结、XRD表征,不到一个月能做出41种新材料。你让五个博士后干这个,一年未必干完。原来人把80%精力花在试错上,现在试错这活儿,机器干得又臭又香——臭在它生成一堆垃圾,香在它真能捞出金子。
不过别误会,AI不是发现了新物理定律,它干的是另一件更值钱的事:在物理允许的范围内,把人类懒得想、想不出、试不起的组合先跑一遍。
生物制药里的AI链,已经不是辅助了
再说生物。这行水最深,钱最厚,监管最严。
以前药企逻辑是:手里几百万分子,高通量筛,谁结合靶点谁进下一轮,后面再慢慢死。现在倒过来了。模型先读几千万篇文献和组学数据,猜哪个靶点真和病有关;生成模型在结构、毒性、代谢、专利空间里反复改分子;先让代理模型把垃圾候选毙掉,再把最像样的几十个送进湿实验;机器人做细胞、做动物、出曲线,曲线再喂回去。
AI定靶点,AI出分子,临床IIa期看到肺活量改善,2026年往III期走。它不一定笑到最后,药这东西临床后期翻车不算新闻。可意义就在这儿:人类第一次有端到端由AI参与推进、走到临床后期的分子。AI从头到尾在管这条管子里的逻辑。
我前阵和一位做CRO(医药研发外包服务商)的老哥吃饭,他半开玩笑:以前博士配液我们按小时收费,以后机器人配液我们按token收费。未来药企看估值,别光看pipeline(研发管线)里几个分子,先看它实验室晚上关灯没有。关灯就停的,还是作坊。关灯还跑的,才像工厂。
然而药这行模型说有效,不等于肝不毒;打分高,不等于不耐药;动物活蹦乱跳,不等于人能扛住。FDA不管你是不是AI设计的,只管你敢不敢在知情同意书上签字。所以生物里的AI,突破是真的,边界也是真的。它把发现阶段的速度拉起来了,开发和监管那段,还是人背着锅往前走。
AI终非诺贝尔奖得主
写到这得泼点冷水。这两年AI for Science被写成了神话,好像明天教授都下岗、实验室全换机械臂。真不是。
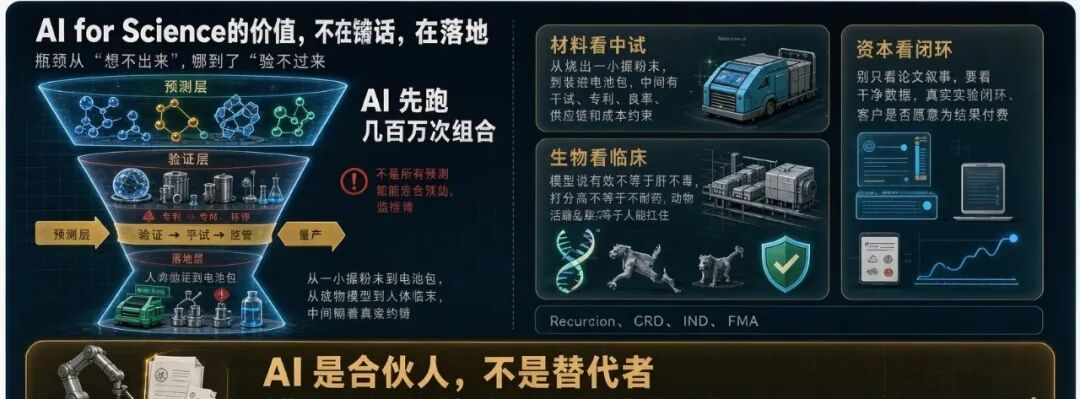
GNoME出来第二天,就有材料学家写评论:你那220万结构里,不少是已知相的变体,真正能合成、能放大、能卖钱的没那么多。A-Lab(全自主材料发现实验室系统)合成成功,也不等于工业界明天就用。从烧出一小撮粉末,到新能源车里装进电池包,中间隔着中试、专利、良率、供应链、环评,还有厂长的一句这玩意儿太贵了。
换句话说,AI把瓶颈从想不出来,搬到了验不过来。原来人卡在前面,现在人卡在后面。以前缺想法,现在缺验证资源。谁有同步辐射机时、有电镜、有GMP车间、有临床床位,谁才接得住AI抛出来的球。
这也是为啥我不太爱用颠覆这个词。颠覆是记者写的,科学家只说收敛更快、搜索更宽、试错更便宜。Hassabis在诺奖后访谈里讲得很克制:这些工具是扩展人类直觉,不是取消人类判断。Baker那也一样,蛋白设计再花哨,最后还得实验拍板。
名人都没说自己取代了谁,咱们别急着替他们宣布胜利。我甚至觉得,以后最值钱的不是会训模型的人,是会瞪着模型结果说你这玩意儿我信不过的那批人。
模型越来越能编,人类越来越得会验。科学史从来如此,望远镜出来了,天文学家没失业,只是看远了;显微镜出来了,生物学家没失业,只是看细了;现在模型出来了,科学家不会失业,只是得习惯和一个不睡觉、不抱怨、还总提怪点子的同事共用一张桌子。
资本该看什么,别看热闹
聊到这,说点读大家可能更关心的:钱往哪去。
AI for Science不是纯软件故事。它两头吃:一头吃算力、吃数据、吃基础模型;一头吃硬件、吃机器人、吃中试线、吃临床。中间那层最性感,也最容易被吹爆——模型层。可利润不一定留在模型层。英伟达赚走了算力钱,机器人厂商赚走了硬件钱,CRO改造完收服务费,药企扛着监管风险分利润,模型公司反而常在融资轮里烧得最凶。
所以看公司别只看它会不会发学术论文r。会发Nature的未必会赚钱。要看它有没有自己的干净数据、有没有接真实实验的闭环、有没有客户愿意为结果付钱而不是为demo鼓掌。Recursion这种走管线+平台双轨的,市场给过溢价也砸过脸,说明资本自己也在学:AI科研不是故事会,最后还是得拿分子、拿材料、拿能源效率说话。
国内这边,智谱、百川、阿里通义都在碰科学模型,但坦白讲,最扎实的突破还是分散在高校、中科院、药明系、宁德时代和几家不愿露面的材料创业公司里。媒体爱写大模型跑分,产业里人盯的是谁先把锂硫电池循环寿命做上去、谁先把蛋白降解靶向分子送进IND、谁先让扩散模型生成出来的晶体真能在炉子里长出来。跑分是给投资人看的,良率是给采购看的。
不过也别太悲观。中国这边数据乱、临床贵、材料中试弱,但工程化能力和制造链是真本事。AI生成东西再花哨,最后要到产线上见真章,这方面我们不是没牌。问题在于,别又把科研AI搞成又一个百模大战:大家比参数、比发布、比谁请的KOL多,三年后留下一地微调过的开源权重的壳公司。
最后,再说个我前阵去深圳一家做自动化湿实验公司见过的画面:晚上十点,实验室灯全亮着。不是人加班,而是机械臂在跑。屏幕上一边是模型给的候选分子,一边是液相色谱出的峰。工程师在隔壁吃外卖,手机弹消息:第312号候选,溶解度不行,已归档。他说了句很淡的话:以前一个硕士两个月试20个,现在一晚上死300个,活的留3个。
那一刻我有点恍惚。科学发现这件事,几千年来都带着点人味:好奇、执拗、灵光、也带点运气。现在灵光还在人脑子里,可试错的苦活被机器吞走了。它不是来抢奖杯的,它是来替你把几百万次无聊失败先替你活一遍。
所以说,AI在科研里到底替谁打工?替博士生打工,替教授打工,替药企的现金流打工,也替人类文明里最贵的东西打工——时间。
时间省下来,拿去干什么,那是另一个话题了。