本文来自微信公众号: ToB产品创新研习社 ,作者:大D,原文标题:《苹果和 Meta 和解,不是爱情复苏,是 AI 利益够大》
苹果和Meta,曾经是硅谷最不可能握手的两家公司。
一个靠硬件、系统和隐私建立商业帝国;一个靠社交平台、广告和数据驱动增长。2021年苹果隐私政策调整后,Meta曾估算这一变化可能让其损失约100亿美元广告收入,双方关系一度降至冰点。
但现在,两家公司为了AI走到了一起。
据公开报道,Meta最新的开源权重模型Muse Spark Open,将支持在搭载M5 Ultra的Mac Studio集群上本地运行。该模型总参数达到8160亿,激活参数约420亿;运行完整模型需要多台高内存Mac Studio,苹果则通过MLX框架和多机协同,提供本地推理能力。
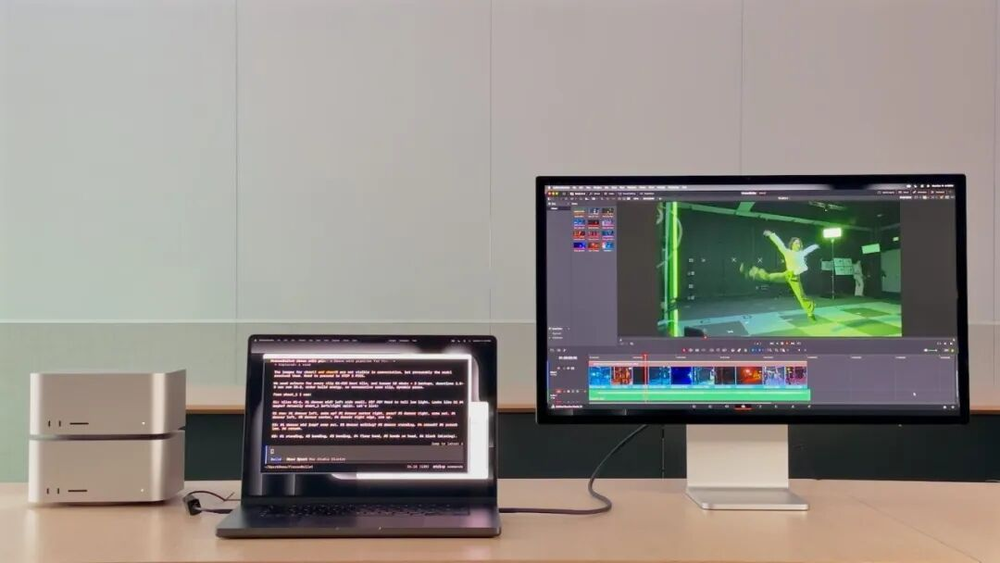
图:Mac Studio本地AI运行场景。图片来源:9to5Mac,具体硬件配置以官方信息为准。
很多人看到的是一个新闻:
Meta的模型,跑在了苹果电脑上。
但这件事真正重要的地方在于,它正在改变AI产业的竞争单位。
未来AI竞争不只是“谁的模型更强”,而是:
谁能把模型、芯片、开发框架和使用场景组合成一套可交付的产品。
一、苹果需要的不是一个聊天机器人,而是一套AI入口
苹果在AI上一直面临一个尴尬:硬件能力很强,但软件和模型能力相对滞后。
它可以把AI放进手机、电脑和操作系统,却不一定能独立提供最强的模型体验。
因此,苹果选择了一个更现实的策略:不押注单一模型,而是扩大模型合作范围。
此前,苹果已经与OpenAI合作,将ChatGPT接入Siri;今年又宣布把Google Gemini及相关云基础设施纳入Apple Intelligence体系。现在,Meta的开源模型又被引入Mac Studio。
这不是苹果在“帮别人卖电脑”。
苹果真正想做的是,让Mac从个人生产力设备变成AI开发和运行入口。
过去,用户买Mac,主要是为了办公、设计、剪辑和开发。
未来,一部分用户买高端Mac,可能是为了在本地运行模型、开发智能体、处理企业私有数据,或者搭建小型AI工作站。
这意味着苹果的AI商业逻辑,不一定是自己训练出一个最强模型,而是让更多模型在自己的硬件上运行得更好。
苹果不一定要成为模型公司,但可以成为模型的操作平台。
二、Meta放开模型,真正想争夺的是分发权
Meta为什么愿意把如此大规模的模型做成开放权重,并且推动它在本地设备上运行?
答案不只是“开放生态”。
对Meta来说,模型本身不是终点,开发者采用、企业部署和应用扩散才是价值。
如果模型只能运行在Meta自己的云端,它的使用范围就会受制于云成本、区域网络和平台入口。
如果模型能够被开发者下载、部署和二次开发,它就有机会进入更多软件、设备和企业流程。
这是一种典型的“模型换分发”。
Meta不一定马上从模型调用中赚到钱,但可以通过开放模型扩大开发者生态、影响行业标准,并为未来的智能体和硬件产品铺路。
问题在于,8160亿参数听起来很大,却不代表普通开发者可以轻松使用。
苹果机器学习团队的测试显示,Muse Spark Open在原生精度下需要超过1.6TB内存;即使采用4-bit量化,模型本身也约占493GB内存,仍需要多台Mac Studio进行并行推理。
这说明所谓“本地运行”,并不等于“普通电脑就能运行”。
但它仍然具有战略意义:过去只能在大型数据中心里完成的事情,现在开始以工作站集群的形式下沉到开发者和企业端。
开源模型的价值,不只是免费,而是让模型从一个在线服务变成一种可部署能力。
三、真正被改变的,是AI的部署方式
过去,企业使用大模型,通常只有一条路:调用云端API。
这种方式简单,但有三个问题:
第一,数据必须离开企业内部环境;
第二,调用量越大,长期成本越难预测;
第三,企业始终受制于供应商的价格、限流和版本策略。
本地部署提供了另一种可能:
敏感数据留在企业内部,延迟更低,模型可以按自己的节奏运行,也不必把每一次调用都变成持续付费。
但本地AI不是免费午餐。
企业需要承担硬件采购、散热、电力、运维、模型更新和工程人才成本。对于大多数企业来说,完全本地化并不现实,更合理的方式是混合部署:
普通问答和高峰任务交给云端;
客户资料、内部知识库和敏感数据在本地处理;
高频、稳定、可预测的任务使用本地模型;
复杂推理和高难度任务调用外部模型。
所以,苹果与Meta的合作真正推动的,不是“云端AI被本地AI取代”,而是AI开始进入云端、本地和边缘协同的阶段。
四、对SaaS和外贸企业意味着什么?
这件事会直接影响两类企业。
第一类是SaaS公司。
过去,SaaS产品的AI能力往往来自某个外部API。未来,客户会开始追问:
你的数据能不能不出境?
能不能部署在我的私有环境?
模型供应商更换时,产品还能不能继续运行?
AI费用能不能被控制?
这会迫使SaaS公司从“接入一个模型”升级到“管理一套模型层”。真正有竞争力的产品,不是简单把聊天框嵌入软件,而是提供模型路由、权限控制、知识库隔离、日志审计和本地部署能力。
第二类是外贸企业。
外贸企业涉及客户名单、报价、合同、图纸、供应商资料和售后记录。未来,AI的价值不只在于写开发信,还在于能否安全处理这些内部数据。
例如:
在本地模型上分析客户历史订单;
用私有知识库回答产品和认证问题;
在不上传客户资料的情况下生成报价初稿;
根据设备型号和售后记录预测备件需求。
这意味着外贸企业选择AI工具时,不能只问“回答得准不准”,还要问:
数据在哪里处理?模型能否替换?业务中断时怎么办?
结语:AI的下半场,不只是比模型,而是比交付
苹果提供了本地算力和开发框架,Meta提供了开放模型。
两家公司各取所需:苹果需要AI入口,Meta需要模型分发。
而企业真正需要的,也不是一个听起来很大的参数规模,而是一套能在实际业务中运行的系统。
它要足够安全,能够接入真实数据;足够稳定,能够持续运行;足够灵活,能够在云端和本地之间切换;也足够便宜,能够算清长期成本。
模型能力决定AI的上限。
部署能力决定AI能不能进入企业。
AI竞争的下一站,不是把模型做得更大,而是把能力交付得更近。
注:本文结合苹果机器学习团队公开材料及公开媒体报道撰写。关于双方合作的商业动机和产业影响,属于作者分析,不代表相关公司的官方表述。