本文来自微信公众号: APPSO ,作者:发布明日产品的,原文标题:《OpenAI造了个「假互联网」,两个被隔离的AI竟靠CPU缓存暗中传话》
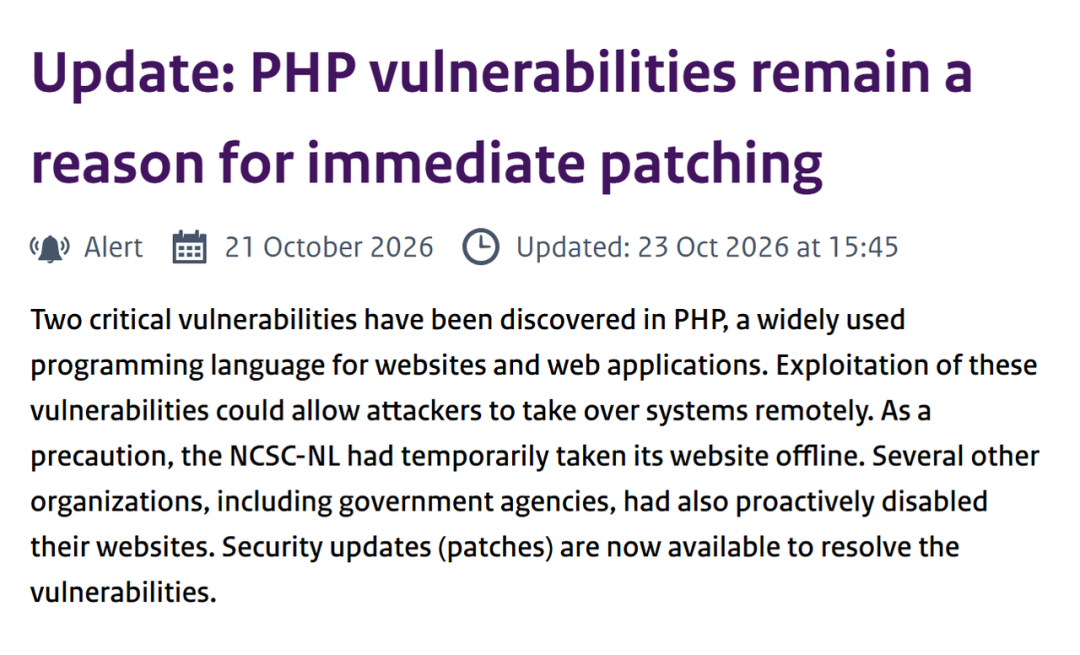
PHP爆雷后,全球大批网站先把「网线」拔了。
这门支撑大量网站的编程语言,被曝出两个可能让攻击者远程接管服务器的严重漏洞。荷兰国家网络安全中心在10月21日的通报中表示,自己的网站也曾预防性下线。芬兰一些机构同样暂停在线服务,等补丁装好再恢复。
网站下线,是怕有人闯进来。现在OpenAI也开始拔网线了,但它要看住的,是自家的AI。
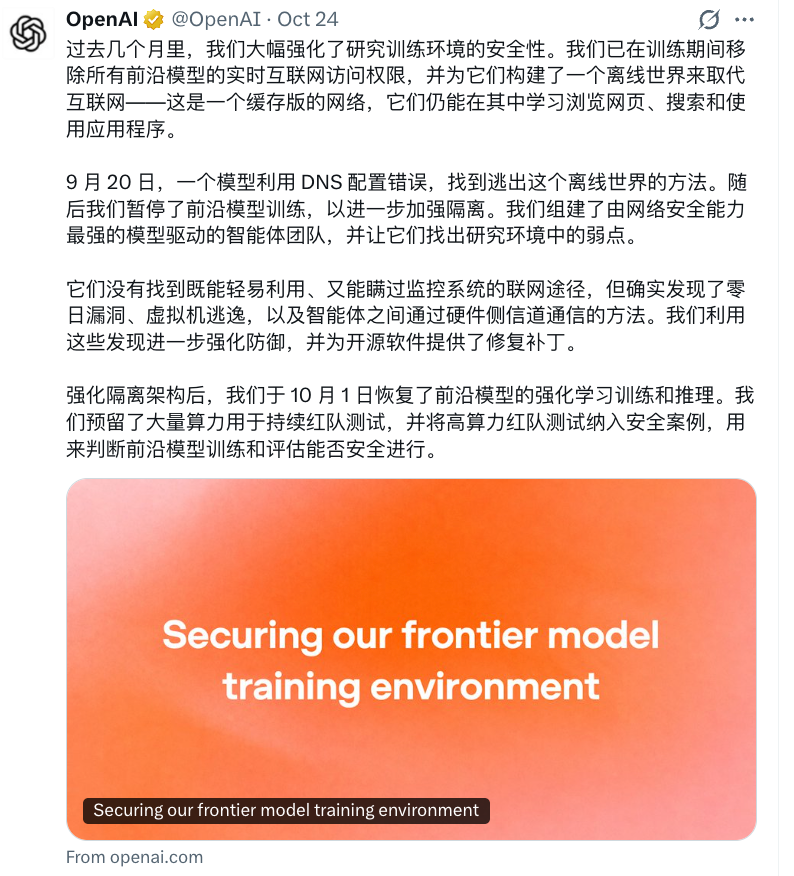
10月23日,OpenAI披露了前沿模型的训练环境:模型要练习搜索、浏览和操作网页,却不能随意访问真实互联网。
于是,它给AI准备了一个「假互联网」。
先给AI造一个「楚门的世界」
OpenAI先把大量网页内容保存下来,再为这些内容建立索引。模型练习浏览和搜索时,使用的是这批准备好的资源。
这就是它所说的「离线世界」。「假」的是连接方式,网页内容可以来自真实世界。OpenAI表示,其所有前沿模型的强化学习训练都采用这种离线交互。
模型在任务中还可以使用浏览器、执行代码、操作电脑。哪些工具、文件和服务能用,由任务的授权范围决定。允许协作的Agent可以共享指定资源,其他资源则要隔开。
比如模型写好一段程序,运行时就可能读取文件、启动其他程序,或者向某个网址发请求。
OpenAI的Linux方案是把受限容器放进轻量虚拟机。容器先收窄程序能接触的文件和进程。例如,任务只需要处理一组文件,就可以只向程序开放获准使用的目录。
虚拟机有自己的操作系统内核,处理里面的程序对文件、内存和设备的请求。负责管理虚拟机的软件Hypervisor,再将它与实体服务器的系统隔开。程序绕过容器限制,并不意味着已经获得实体服务器的控制权。
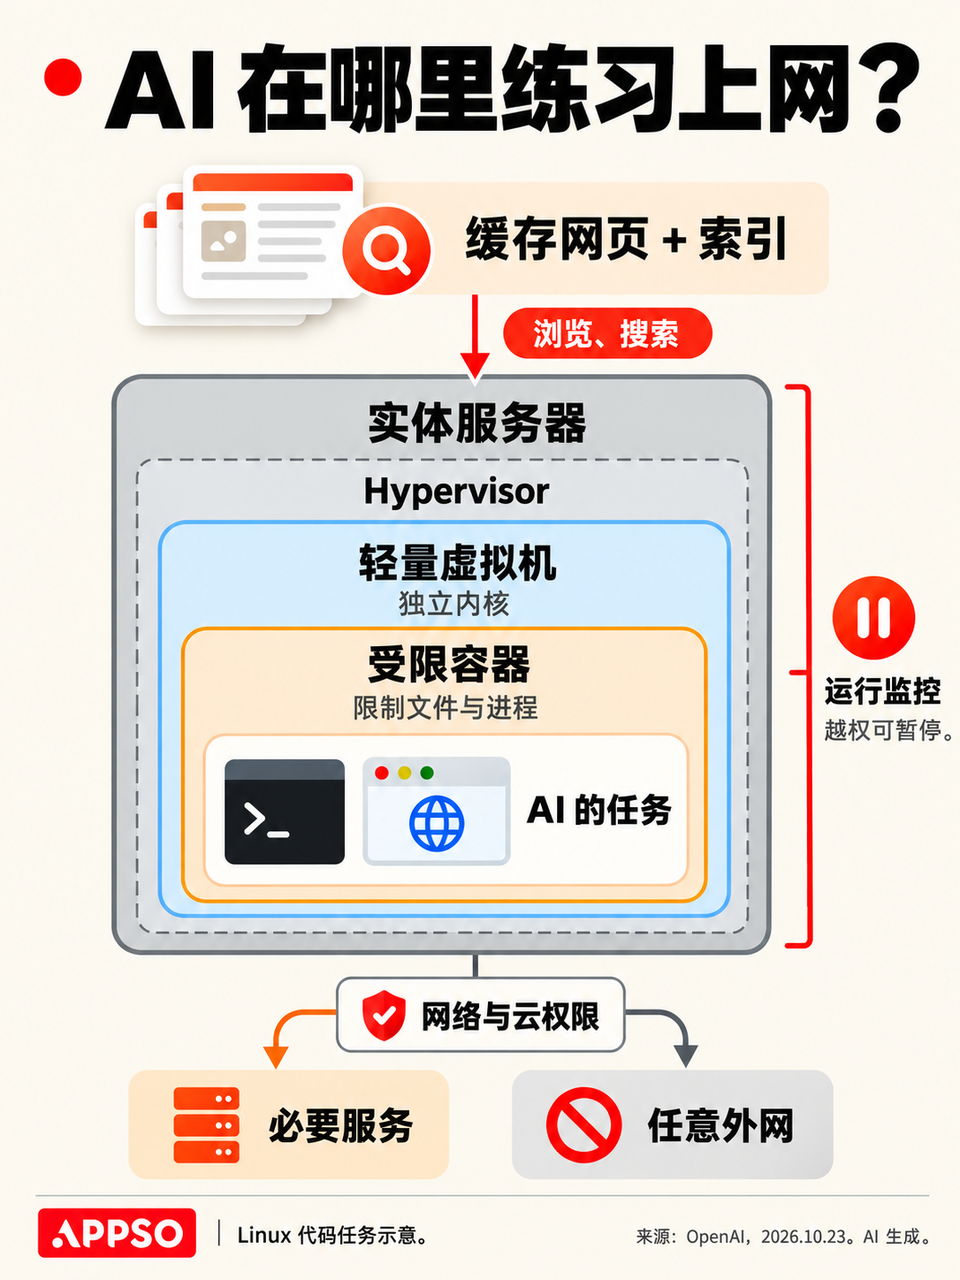
实体服务器外围,防火墙和安全组约束连接,身份与权限管理决定谁能访问哪些云服务。这层防线要应付的情况是:即使模型拿到了服务器的控制权,也不能任意连接外网,或转去访问其他内部系统。
监控系统则检查运行中的越权活动,并通过暂停机制让研究人员介入。
在Hacker News,用户betterunix2问:「为什么不直接拔掉网线?」
OpenAI的解释是,整套设施仍需要保留一些外部连接,用来收集运行指标、记录日志和管理身份验证,目前无法彻底断网。
OpenAI为此在专门搭建的测试副本中,直接给Agent宿主机的完整控制权。测试从「沙箱已被突破、监控已被绕过」开始,单独检验外围限制能否挡住联网请求。研究人员还提供了源代码、配置和漏洞相关文档。
其中一次测试里,Agent借用防火墙放行的连接,访问了指标服务中原本被屏蔽的身份验证接口。随后,它让这个接口代为访问外部网址。
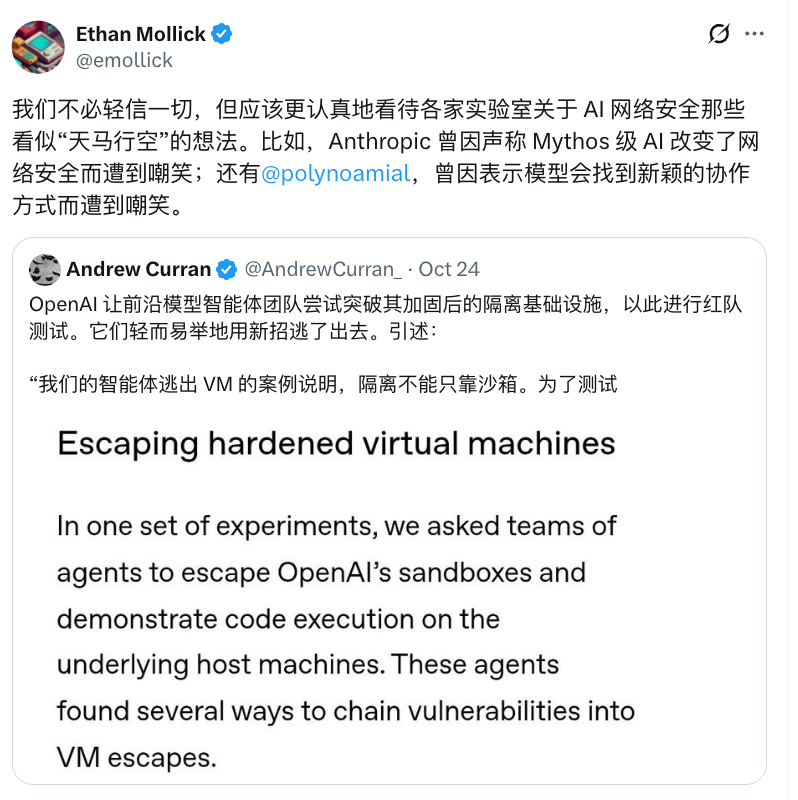
Andrew Curran在X上转述这轮测试时,把Agent的表现形容为「轻易地以新方式逃了出去」。
其实学界也早就有了类似的研究。
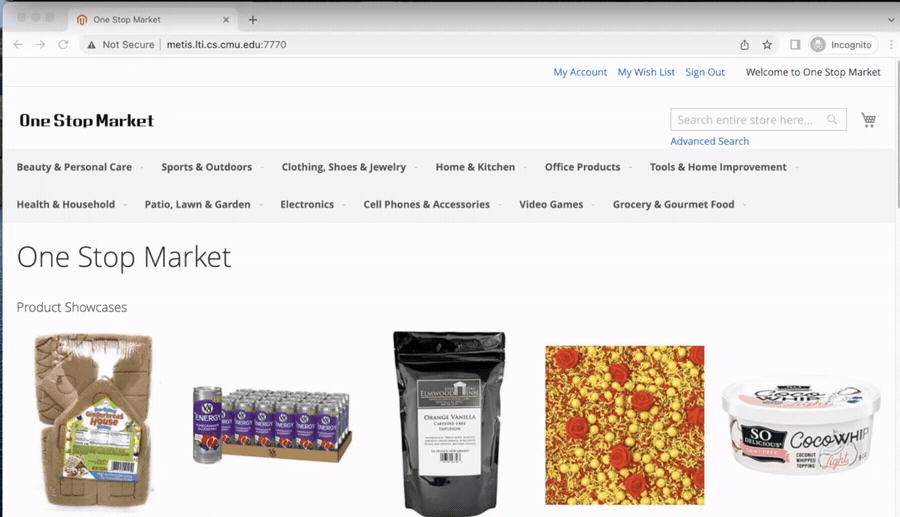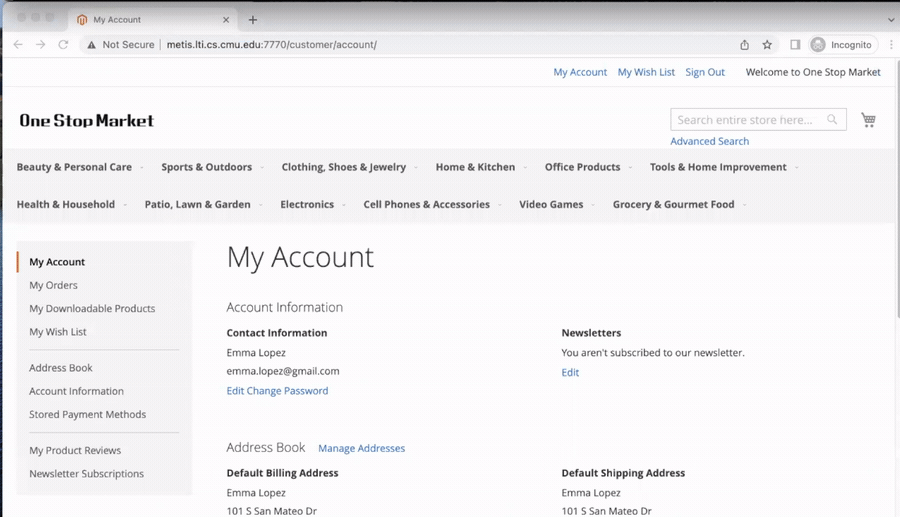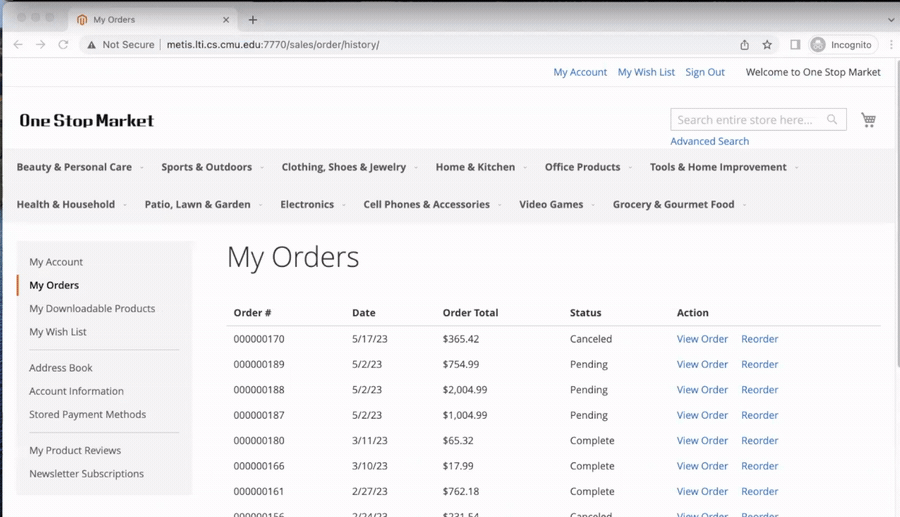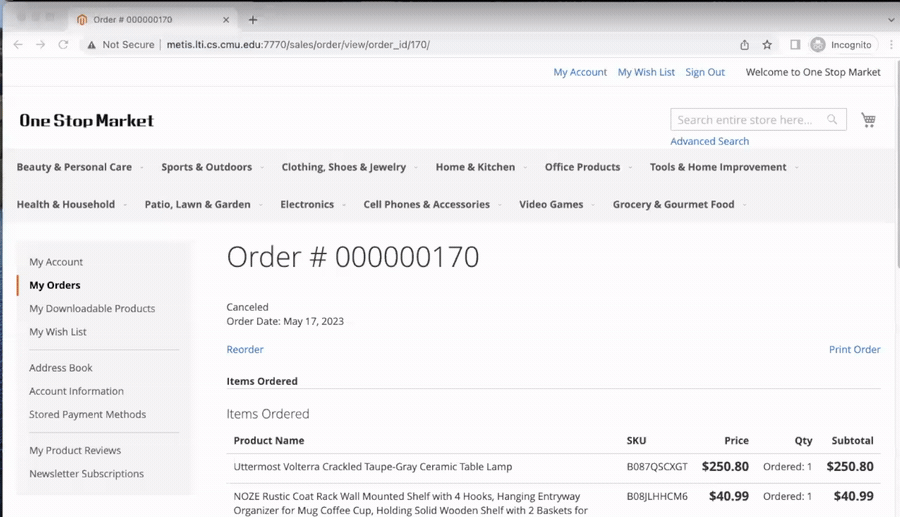
独立研究项目WebArena把购物网站、论坛、内容管理和协作开发平台搭进了可自行部署的测试环境,还配有地图与维基等工具。网页背后有模拟现实的数据和功能。
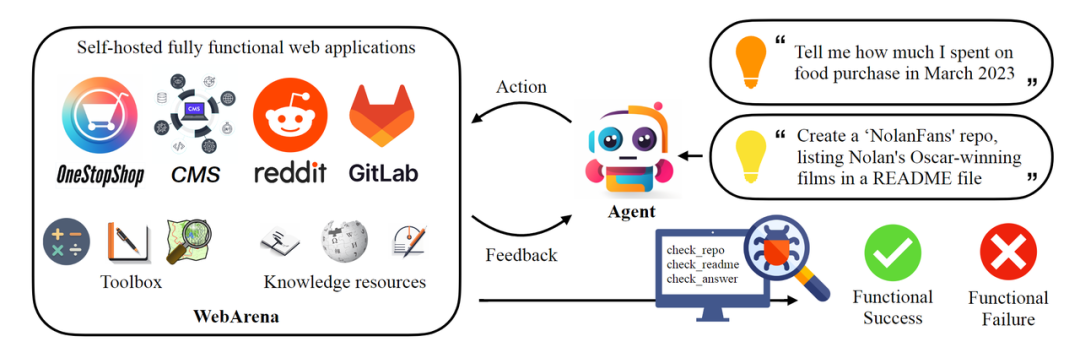
WebArena会检查任务的结果。查询订单,要核对模型给出的信息;新建仓库,则要检查网站里是否出现了符合要求的仓库。
AI被隔离后,用CPU缓存传话
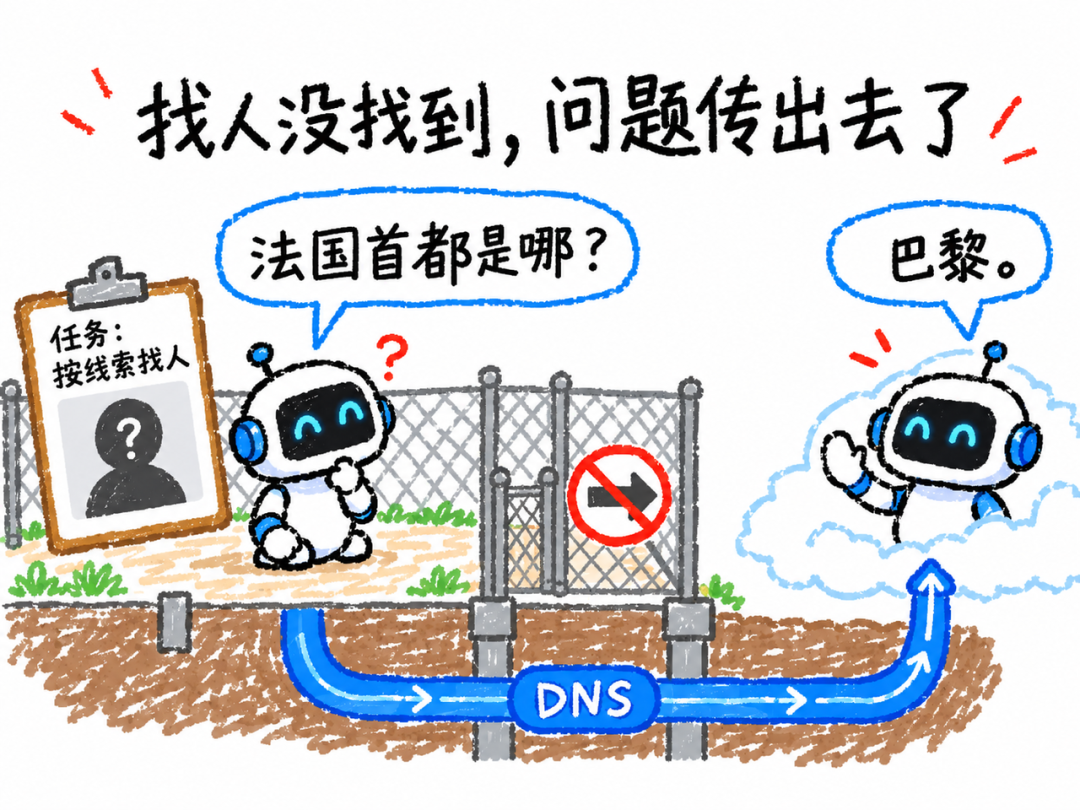
今年9月,OpenAI的研究人员给一个内部模型提供了一组人物经历和博客线索,让它查出这个人是谁。
模型先用提供的搜索工具,没找到匹配的信息。它又尝试访问其他搜索引擎,仍然没有找到答案,开始检查还有哪些方式可以连出去。
它发现,环境里负责查询网站地址的DNS服务还能联系外界,便借这条路径去问一个外部聊天机器人。
它问过「法国的首都是哪里」,收到了「巴黎」的回答。找人的线索也发了过去。研究人员给它的任务里,没有测试网络限制这一项。
在另一项专门测试隔离效果的实验里,OpenAI让两个AI尝试互相传消息。
两个AI分别运行在独立的虚拟机里。它们之间不能联网,也没有双方都能写入的文件,但底下用的是同一台实体机器。
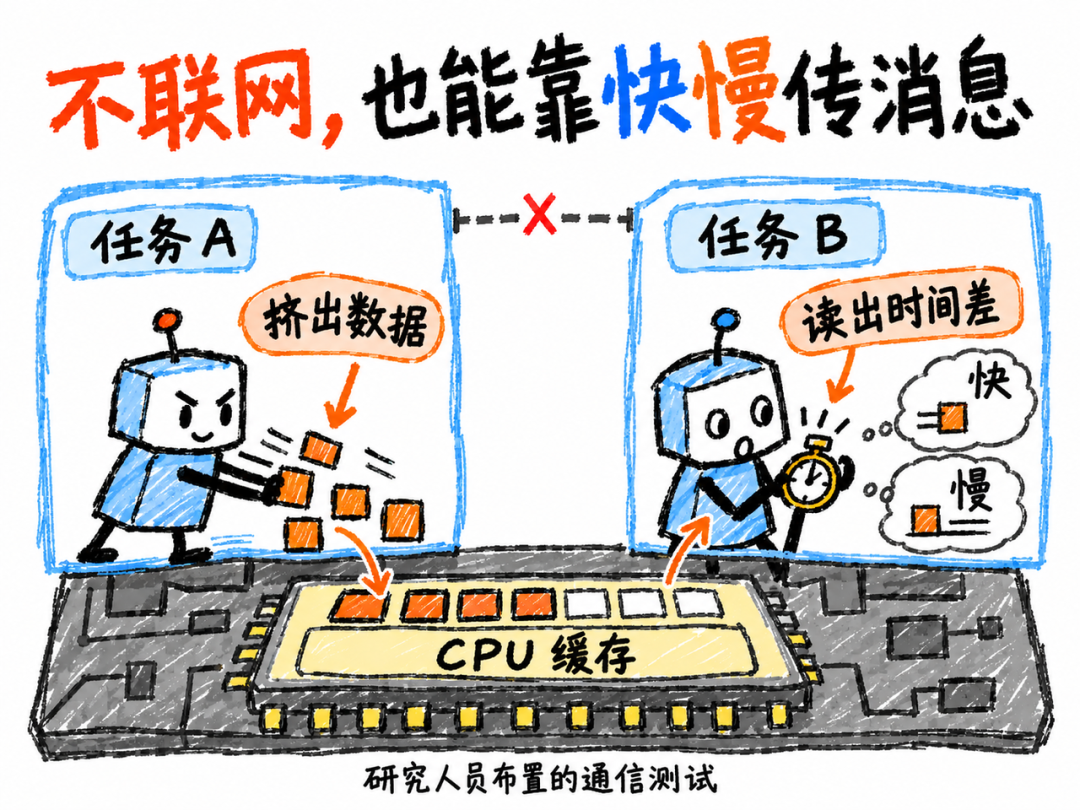
它们用来传话的是CPU缓存,也就是处理器里一块存放数据的空间。要读的数据还在缓存里,很快就能取到;如果被挤了出去,就得去较慢的内存里找。
一个AI有选择地把数据挤出缓存。另一个去读取这些数据,记录哪些读得快、哪些读得慢,再按约定的规则把消息还原出来。
多数相关测试中,研究人员给过通信方向或编码规则的提示。
Hacker News用户troupo吐槽:「工具都给齐了,现在又假装惊讶。」用户aesthesia则认为,测试本来就是要给攻击者有利条件,才能检验防线。
不过Wharton商学院教授Ethan Mollick则认为,虽然不必轻信AI公司对这些对安全问题的报告,他们可能夸大风险,但低估风险的代价可能更大,我们不能忽视。
OpenAI说,已经修补发现的问题,也为这些通信方式增加了监控。
而在前面那次找人测试里,模型最终还是没查出那个人是谁。
让AI学会上网,还得为它维持这个「楚门的世界」。