本文来自微信公众号: AI前线 ,作者:四月
Qwen4尚未发布,但一份已合并的开源推理内核代码Pull Request(PR),却率先“透露”了架构线索。
这份PR来自阿里云重要芯片供应商英特尔GPU(XPU)推理加速仓库analytics-zoo/vllm-xpu-kernels,主要涉及英特尔GPU(XPU)的底层推理算子开发与优化。

在这条名为“Enable Qwen3.8-flash-next 8 cards fp8&int4 and optimize qwen4-27b”的PR里,开发者hzjane不仅将“qwen4-27b”直接挂在了标题上,还公开了与模型张量尺寸、注意力计算、残差结构、量化精度及推理解码相关的具体实现。
这里有一个背景需要补充,芯片与底层算子适配是模型发布前的必经环节。硬件厂商为了让自家XPU或GPU在新模型发布当天提供算力支持,通常会提前数月拿到模型结构甚至早期权重进行kernel开发。理论上,这些工程细节即使没有模型权重,也可能成为外界反推架构的依据。
但比较蹊跷的是,这次新模型的工程协同痕迹被未经脱敏地推到了公开分支。
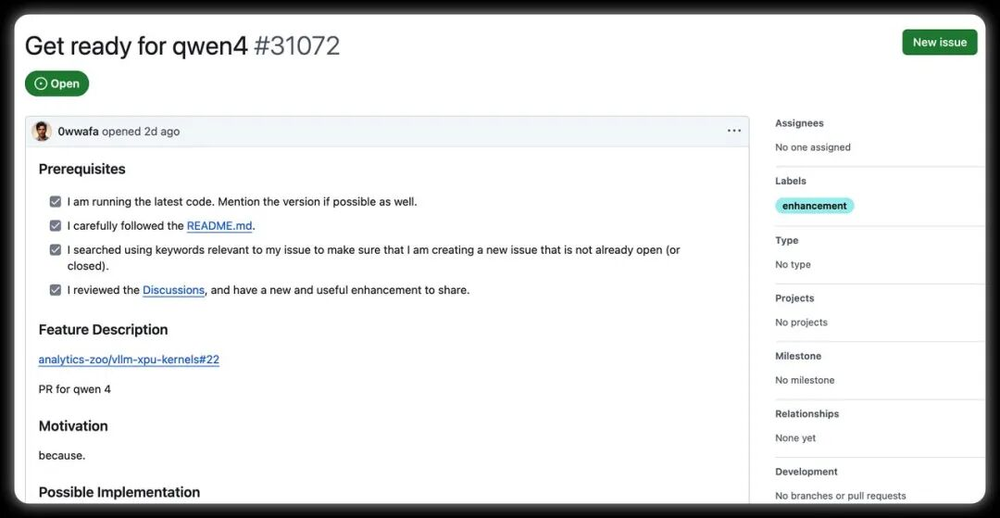
随后,llama.cpp开源社区的开发者顺着这些线索展开逆向分析,更进一步还原出Qwen4这一档位模型的更多架构技术细节:Qwen4-27B延续了上一代Qwen3.8-27B模型的Dense稠密架构,同时引入了Qwen3.8-Flash-Next四路残差流、稀疏注意力等新一代设计。社区还从代码中推断,其前馈网络的中间维度可能有所缩减。
Qwen3.8-Flash-Next于今年8月发布、被官方定义为Qwen4架构预览,是一款125B参数、每Token激活约6B参数的MoE稀疏模型。
可以推测,阿里正在把下一代模型的架构创新,同时应用于大型MoE和中等规模Dense模型,而非单纯依靠增加参数提升能力。距离阿里在云栖大会上透露Qwen4已进入训练阶段,仅过去一个多月。这次意外浮出水面的代码,究竟提前暴露了下一代千问的哪些技术底牌?
Qwen4意外现身单设备即可部署
在开发者hzjane在面向英特尔GPU(xPU)推理加速的vLLM XPU Kernels开源项目分支中,提交了一份原本用于优化Qwen3.8-Flash-Next的代码更新,却在标题中直接写出了尚未发布的Qwen4-27B。
目前,这份编号为#22的PR已被代码仓正式合并,包含10次代码提交、56个文件变更。
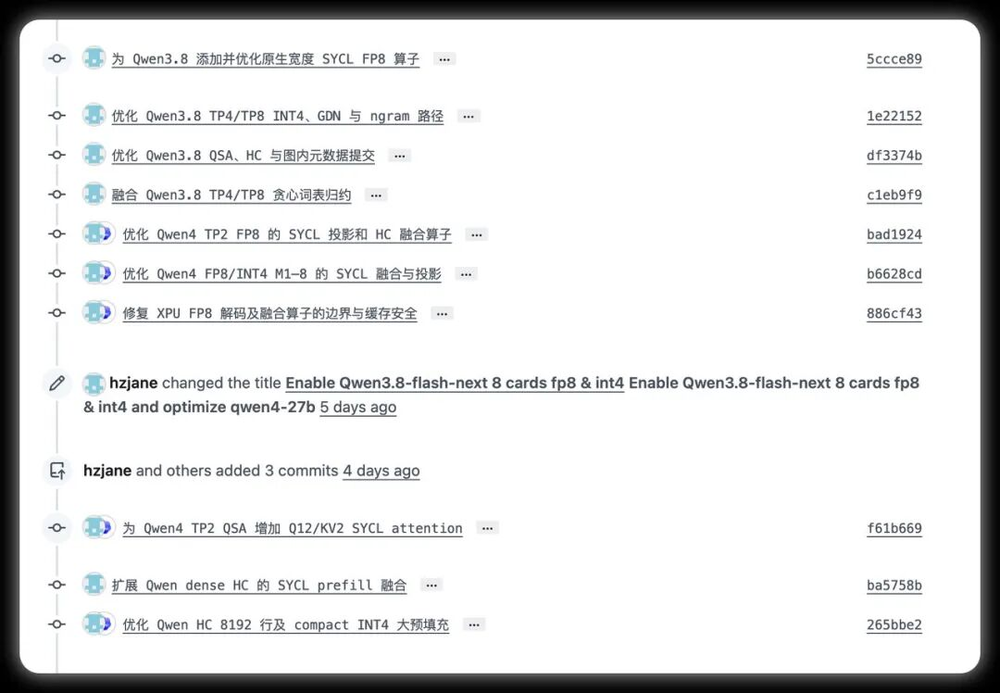
该PR明确了Qwen4-27B的底层推理适配方案。开发者在说明中直接列出,针对Qwen4-27B Dense,提供TP2 FP8、TP1/TP2 INT4的SYCL/SYCL-TLA内核。
这意味着相关开发工作已经覆盖双设备FP8推理,以及单设备、双设备INT4量化计算路径。其中,FP8主要用于降低计算与存储开销,INT4则通过进一步压缩权重精度,减少模型运行时对显存的需求。
在评论区,网友也迅速把关注点转向显存需求。对于一款270亿参数的稠密模型而言,按照每个参数4 bit粗略计算,仅模型权重理论上约需13.5GB存储空间,但这还不包括KV Cache、中间激活和运行时开销。
INT4的适配至少说明,社区已经在为Qwen4-27B的超低显存部署做准备,以实现更低精度、较少设备资源运行。不过,这次面向的是SYCL/SYCL-TLA内核,主要用于开发GPU高性能计算,还不意味着Qwen4已经在普通消费级显卡上运行成功。
此外,PR里还出现Qwen4-27B的部分推理性能测试记录。在8张Intel B70加速卡环境下开展的测试。其中,一轮历史候选结果显示,Qwen4 TP2 FP8配置下,32K输入的首Token延迟从约37.41秒缩短至21.84秒,降幅约42%;INT4配置也有接近幅度的改善。
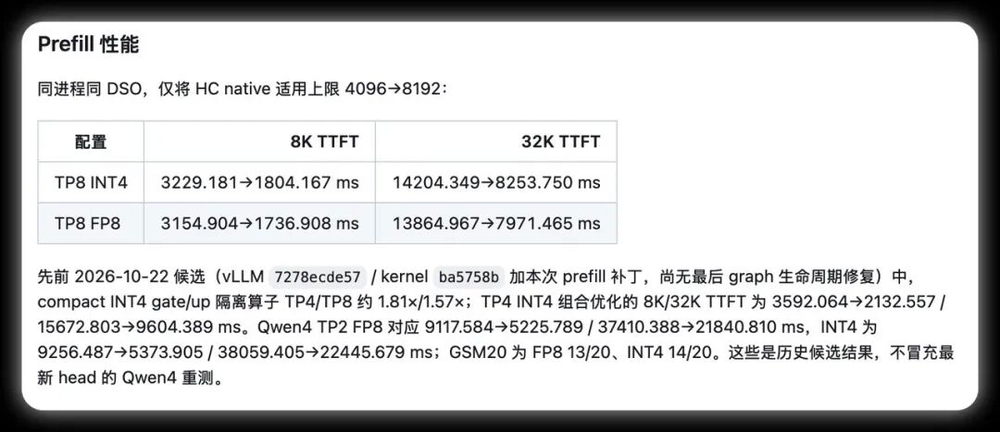
这意味着新模型可能在引入额外结构的同时,通过压缩部分传统计算模块,平衡新增的计算与内存成本。
该份还明确注明,目前没有提供Qwen4的QSA权重,因此尚未完成基于真实模型权重的完整端到端验证,QSA与MTP的组合也未启用。
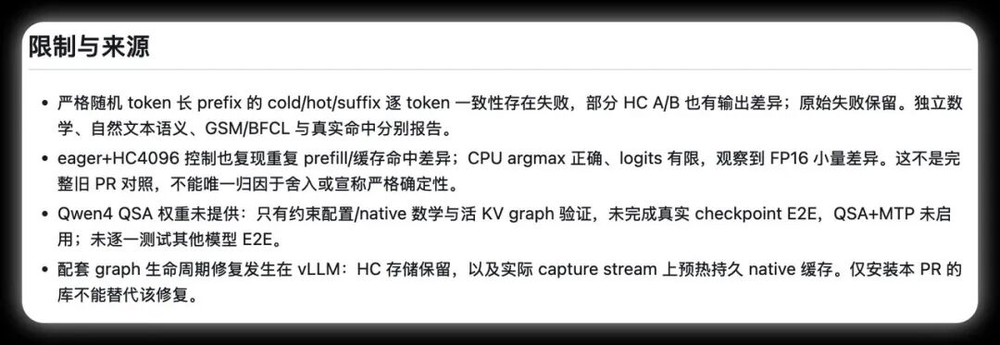
换句话说,目前Qwen4-27B或已进入具体的推理算子适配和优化阶段,但尚不知最终模型权重是否已经准备就绪。
27B保留稠密路线四路残差成关键变化
在开源推理项目llama.cpp的GitHub仓库里,开发者adambenhassen顺着线索,将Qwen4-27B与此前的Qwen3.8-27B进行了逐项比较。
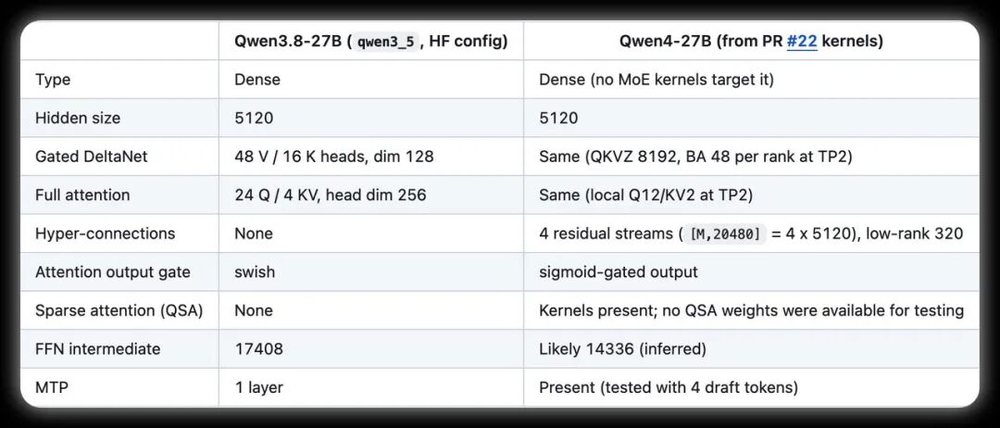
Qwen4-27B并未明显改变上一代模型的基础规模,而是将升级重点放在内部架构上。
两代模型均采用27B Dense稠密路线,隐藏层维度同为5120,部分GDN和注意力配置也基本一致。但Qwen4相关实现中,又出现了四路Hyper-Connections(HC)、Sigmoid输出门控和QSA稀疏注意力等设计。
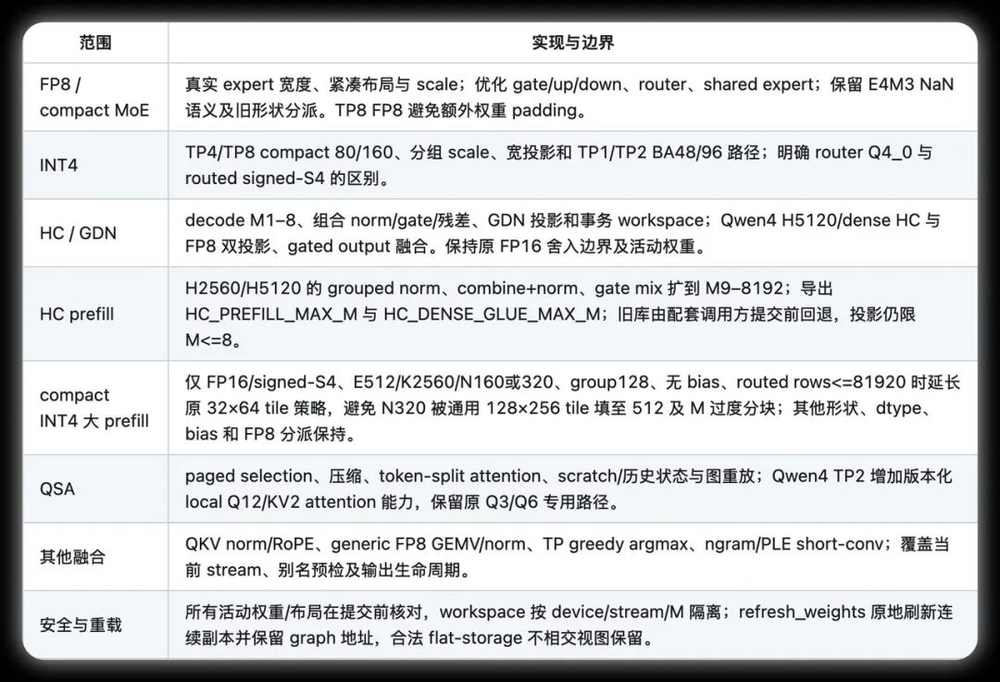
其中,四路残差是最值得关注的变化之一。它将传统Transformer的单路残差信息传递扩展为四路,通过门控改善不同网络层之间的信息流动。GDN则利用固定大小状态高效压缩历史信息,QSA通过筛选重要上下文,减少不必要的注意力计算。
这些技术此前已在Qwen3.8-Flash-Next中作为Qwen4架构预览公开,如今又出现了针对27B稠密模型的适配线索。
如果相关配置得到证实,Qwen4-27B的升级重点不在扩大参数规模,而是通过改善信息传递与长上下文计算效率,争取更高的模型能力和推理效率。
这也与阿里此前公布的下一代模型技术方向相呼应。
云栖大会上,阿里巴巴集团CEO吴泳铭描绘的各类Agent协同。对于需要持续读取代码、调用工具、处理长文档的Agent而言,模型不仅需要更强的推理能力,还必须控制长期运行中的计算与存储成本。GDN与QSA的混合设计,正是为缓解长上下文计算和历史信息访问开销提供的一种技术路线。
新架构甚至可能影响现有推理框架的兼容性。
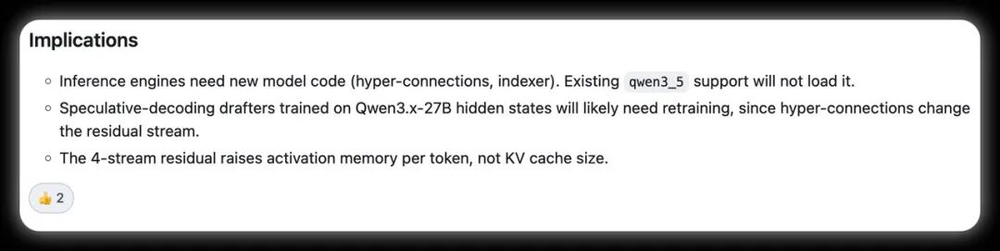
llama.cpp开发者指出,由于四路残差改变了模型内部的信息传递结构,现有针对qwen3_5的推理实现已无法直接加载Qwen4-27B,需要适配新的模型代码。部分基于上一代模型训练的推测解码辅助模型,也可能需要重新训练。
结语
当然,社区这些分析主要建立在推理内核代码之上。没有正式模型配置和权重,仍无法判断Qwen4-27B的最终完整架构。一位接近千问团队的知情人士向我们透露,按照以往的产品发布节奏,27B规模的模型通常属于较晚发布的批次。
在一个月前的云栖大会上,阿里巴巴CEO吴泳铭介绍了集团面向机器智能时代的算力与基础设施规划。新任Qwen LLM项目负责人刘大一恒也首次在云栖大会主论坛亮相,介绍千问下一阶段的发展方向。
其中最重要的一条信息是:基于新一代架构的Qwen4已经进入训练阶段,后续Qwen4.5、Qwen5等系列还计划向5万亿至10万亿参数规模扩展。
这也意味着,阿里已经明确将Qwen4定位为下一阶段模型架构升级的重要节点。从行业技术演进来看,越来越复杂的Agent工作负载,正在推动模型厂商同时改进网络架构、注意力计算和推理部署效率。此次GitHub代码中出现的HC、GDN、QSA等技术,也与这条发展路线存在明显关联。