
本文来自微信公众号: 第四波 ,编辑:王晓,作者:冯皓钦
前两天,闫俊杰刚刚说,自己最近全部精力都投注在M3 Pro上。结果11日凌晨,MiniMax就先扔出一道前菜——H3 Image,并同步开放了模型权重,坚定地践行着自己的多模态路线。
在正式评测之前,我们先了解一下H3 Image几个核心功能点。
它衍生自此前的H3多模态模型,除了文生图、图片编辑,还支持最多16张参考图输入。官方重点强调的几个优势:生成速度、画面真实感,复杂指令遵循能力以及便宜的价格。一张约1600万像素的4K图片,最快只需要10秒,价格不到3毛钱。
但在前几天,11月4日,OpenAI端出了GPT Image 2.6,也重点升级了生成速度、图像编辑和视觉一致性。两款模型前后脚发布,难免让人好奇:MiniMax这次到底追上GPT了吗?
为此,第四波拿两款模型做了几轮实际测试。从生活纪实、科技封面,到中文海报、工业爆炸图、多参考图融合,再到3A游戏场景,全部使用2K画质,看看它们究竟相差几何。
01
画面真实感,
MiniMax确实有点东西
第一轮,我们让两款模型生成一张上海老居民区的雨后街景。画面中要有修自行车的老人、提着塑料袋经过的年轻女性,以及远处交谈的行人。没有电影滤镜,也没有刻意营造的戏剧性光效。
GPT Image 2.6的表现相当稳。老人、年轻女性、远处行人基本都出现在指定位置,建筑、便利店、电动车等环境元素也比较完整。
但整张图片过于工整,街道、人物和光线都恰到好处,反而少了几分真实生活中的随意感。
相比之下,MiniMax H3 Image的画面则多了几分真实生活的粗粝感。
老人脸上的皱纹、粗糙的双手、自行车上的锈迹,以及斑驳的墙面,都很有质感。整体画面更粗粝,也更有街头人文纪实摄影的味道。
但它也出现了明显偏差。原本要求的是年轻女性,结果生成人物看起来明显偏成熟,指定的便利店也没有得到清晰呈现。
H3 Image的确已经能生成相当有生活气息的纪实照片,但在追求真实质感的同时,难免可能会牺牲对具体指令的准确执行。这或许也是不少开发者使用后评价它“几乎没有AI味”的原因之一吧。
所以这一轮,H3 Image的真实质感值得肯定,但作为评测,GPT Image 2.6对指令的执行更准确,综合来看小幅领先。
第二轮,我们测试视觉审美,让两款模型为以“AI算力与能源”为主题,设计一张纯净的高端科技杂志封面,不添加任何文字和Logo。
GPT Image 2.6把数据中心、输电铁塔和变电设施放在同一场景中,结构完整、主题清晰,但整体更像一张精致的商业效果图,设计语言不算新颖。
H3 Image反而更有自己的风格。
它选择了大面积天空留白,建筑与输电线路集中在画面下方,灰褐色调克制、自然,整体更接近纪实摄影,也更有杂志封面的视觉氛围。
但问题是,它把数据中心画得太像普通工业厂房,右侧还出现了容易让人联想到传统发电厂的冷却塔,个人感觉,有点弱化了AI算力这一主题。
这一轮,如果强调信息表达,GPT Image更准确,但如果看审美和摄影氛围,我更偏向H3 Image。
从前面这两轮,可以看出MiniMaxH3 Image的确具备了与头部生图模型掰手腕的能力,模型也不再只是靠低价吸引用户,画面质感和审美确实有竞争力。
02
真拿来干活,差距就出来了
接下来,我们开始提高难度。
第三轮我们开始使用两个模型设计中文商业海报。要求包含完整的会议名称、时间、地点,以及六项会议议程,不能有任何错字或信息遗漏。
结果有些出乎意料,两款模型的中文表现都不错,指定文字和时间均准确呈现。
但设计上的差距......一言难尽。
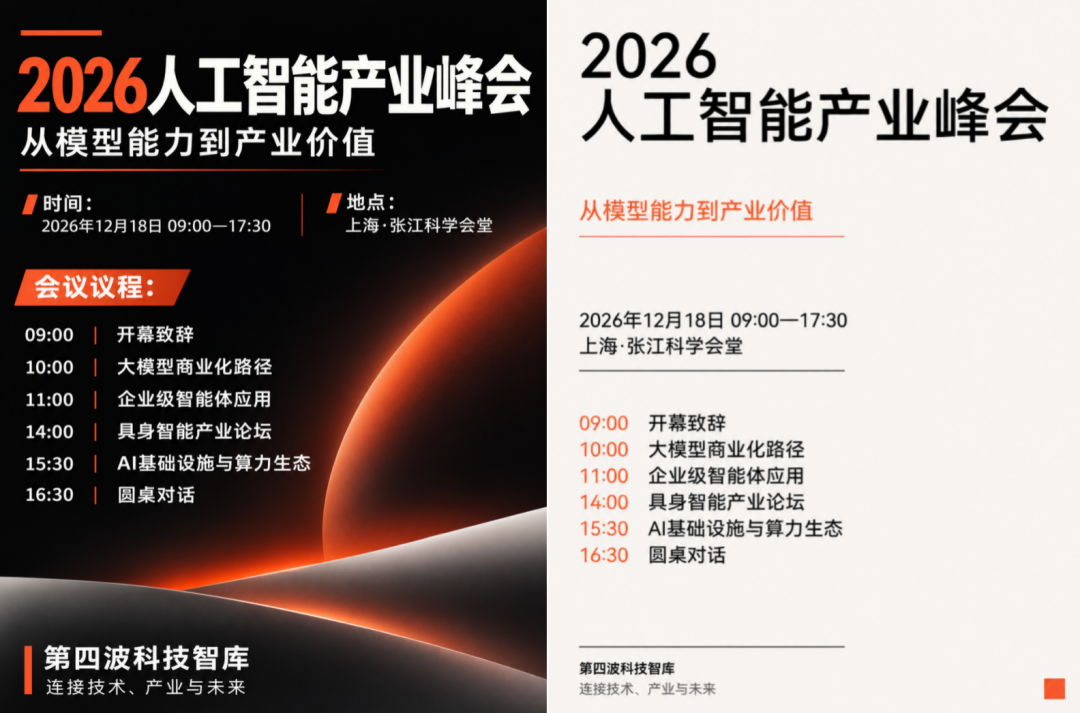
(左/GPT Image 2.6右/MiniMax H3 Image)
GPT Image 2.6采用黑橙配色,标题、议程和主办方信息都有明确的视觉层级,整体已经具备商业海报的基本可用性。虽然顶部标题稍显拥挤,右侧的大面积橙色图形也有些用力过猛,但至少看得出完整的设计思路。
H3 Image则是完全走向了另一个极端。
它把所有信息规规矩矩地排在米白色背景上,文字没什么问题,留白也足够,但视觉表达过于简单。就像一份会议通知,或者说没设计完的PPT。
它理解了文字要求,却没有真正完成设计任务。这一轮,胜负想必非常直观了。
第四轮,我们测试更复杂的工业产品爆炸图。
这次要求非常明确:一款手持探照灯,严格按照顺序拆分成7个主要部件,准确标注中文名称,再额外展示3枚固定螺丝和完整组装效果。
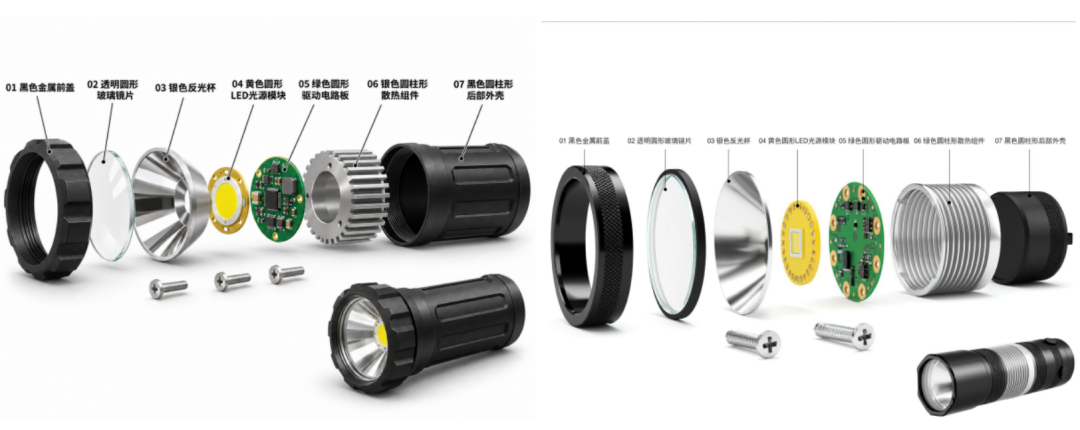
(左/GPT Image 2.6右/MiniMax H3 Image)
GPT Image 2.6几乎把这些要求全部完成了。7个部件顺序正确,3枚螺丝没有遗漏,金属、玻璃、电路板的材质区分也很清晰。虽然不能直接作为工程图纸,但已经具备不错的专业展示效果。
H3 Image的表现则没这么理想了。
它同样画对了7个主要部件,中文标注也没有明显错误,但要求3枚螺丝,最后只给了2枚。
更明显的是,右下角的成品还出现了大面积外露的银色散热结构,与拆解图中的黑色后壳并不完全对应。
这类问题在普通插画中或许无伤大雅,但如果用于产品介绍、结构说明,就不能忽视了。
第五轮,我们又提供了4张不同的参考图,分别对应耳机产品、人物主体、动作姿势和建筑环境,要求模型将它们融合成一张高端商业广告。
这次两款模型的表现都不错。
GPT Image 2.6的整体构图更加完整,人物、耳机与建筑环境结合得比较自然,有成熟商业广告的质感。
H3 Image在人物皮肤、服装纹理和光影方面同样表现不错,尤其是侧脸和暖色光线,颇有时尚摄影的味道。
但它没有完整保留原本的椅子,而是让人物直接倚坐在建筑边缘,场景安排出现偏差。至于人物身份和耳机外观的还原精度,还需要结合原始参考素材进一步判断。
综合来看,这一轮两款模型各有千秋。
此外,最后一轮,我们还补充了一组3A游戏场景测试,要求生成废弃工业城市中的第三人称游戏实机截图。
两款模型生成的图片画面中,机器人、破损建筑、雨后积水和游戏UI都相当精致,但整体都还是更接近精心摆拍的游戏宣传CG,缺少真正游戏过程中自然形成的镜头语言。
相比之下,用ClaudeFable 5.2生成的可交互HTML游戏,在武器视角、任务信息与场景布局的结合上,反而更有真实游戏的代入感。
那既然说到这儿了,顺便也提一下后续我们会用不同的Agent模型去vibe这样的可交互3A游戏作品,让大家从游戏视频里更直观的看到不同模型的特色。感兴趣的朋友可以关注我们后续的视频。
这样一比,至少说明了一点:在没有Agent加持场景构建的情况下,单张AI生图即使材质、光影足够精致,也不一定能真正还原游戏的实机质感。
所以整体测下来,结果也比较清楚了。
H3 Image在真实感和视觉审美上具备竞争力,但面对复杂指令、精确数量控制和商业设计时,GPT Image 2.6仍然稳如老狗。
03
便宜又快的MiniMax,还差什么?
不过,如果只看画面效果定输赢,未免有些片面。
因为H3 Image有两个非常突出的优势,是价格和速度。
先说价格。
按照MiniMax公布的国内API参考价格,1K文生图约0.143元,2K约0.1531元。4K、16MP规格的标准版常规参考价约0.4522元,而发布首周还提供五折优惠,单张约0.2261元。
也就是说,在活动期间,两毛多钱就能生成一张1600多万像素的高清图片。
这个价格确实很有竞争力了。特别是对于需要大量生成电商素材、广告方案、游戏概念图的创作者来说,成本优势会随着生成次数增加而放大。
而且,在这次实际体验中,我也明显感觉到,H3 Image的生成速度比GPT Image 2.6更快一些。
当然,这只是本次测试入口和设置下的体验,并不是严格控制分辨率、模型参数和服务器负载后的速度基准测试。但就日常创作而言,少等一会儿,就能多尝试几次方案,这种效率提升是实实在在的。
再加上H3 Image开放了模型权重,开发者可以在许可范围内自行部署、定制和集成。这对需要自主控制模型和工作流的企业来说,也是非常看重的。
但体验过程中,我还发现了一个容易被忽略的用户体验问题,产品入口。
现在使用GPT,不管是在ChatGPT中直接对话生图,还是通过ChatGPT Work、Codex和相关图像插件进行创作,图像能力已经与更多任务流程联系在一起上下文也能更好的共享。
我们在创作时完全可以先讨论创意、整理素材,再生成图片,之后继续修改。整个过程不只是调用一次生图模型,而是在同一套产品生态中持续完成任务。
MiniMax虽然一直坚持多模态路线,文本、视频、图像、语音等模型领域都有布局,但普通用户实际接触这些能力时,仍然需要在海螺、MiniMax Code等不同产品场景之间切换,非常麻烦。
它也有统一的开放平台,可以通过API整合模型能力,但对于不懂开发的普通创作者来说,前台体验的连贯性仍有提升空间,也希望未来官方能对此有所优化。
但无可厚非,从这次实测来看,H3 Image已经是一款有竞争力的生图模型了,尤其是画面真实感、生成速度和成本表现,确实值得肯定。
但如果要直接承担复杂商业设计、结构说明和精确执行任务,GPT Image 2.6目前仍然更让人省心。
毕竟,对真正拿AI干活的人来说,决定成本的不只是生成一张图片要花多少钱,还包括为了得到一张能用的图片,究竟需要修改多少次。
便宜和速度决定了我们愿不愿意多尝试,准确性和工作流体验,才决定了它能不能成为日常生产力工具。