本文来自微信公众号: 四生围 ,作者:四生围
十月底这几天,A股但凡跟“数据采集”沾边的票,集体起飞。福莱新材六天四个板,汉威科技、奥比中光、奥普特涨幅都过了30%。盘面一片红,“数采”两个字被标了个高价。但把这轮行情拆开看,结论跟直觉是拧着的:数采确实是门大生意,只是站在赚钱位置上的,未必是服务商。
这轮行情起来得快,逻辑倒算不上新鲜:只要有“缺口”两个字,资金就愿意先给个估值。数采的缺口是真的,可缺口的位置,和股价上涨的位置,未必对得上。
01·THE BRAIN
大脑的饥荒
人形机器人的硬件方案,这两年基本收敛了。电机、减速器、丝杠,各家参数咬得很紧,差距在肉眼可见地缩小。真正拉开身位的地方挪到了“大脑”——泛化能力。A场景学会的活儿,换到B场景还干不干得了,这里才是分水岭。
硬件趋同之后,行业的叙事也跟着换了。谁的机器人会的活儿多、学新任务学得快,谁就有定价权。学得快不快,取决于喂了多少真数据。
泛化这件事,说起来抽象,落到车间里很具体。同一个抓取动作,换个材质、换个光照、换个摆放角度,模型可能就失手。要让它不失手,只能让它见过足够多“不一样”的真实场景。这不是调参能解决的,是喂出来的。
泛化的天花板,由数据定。量要够,质要真。麻烦就在这儿:大语言模型当年吃进去的是万亿级token,具身模型能拿到的真实交互数据,连它的万分之一都不到。
亿欧智库预计,要让具身AI真正可用,至少需要1000万小时级别的真实场景交互数据;全行业攥在手里的高质量真机数据,拢共约50万小时。缺口20倍。
20倍的缺口摆在这里,往后几年行业最紧的约束之一,恐怕不是产线爬坡,是数据供给。谁能让数据以更低的成本、更高的保真度长出来,谁就握住下一阶段的节奏。
02·GOOD DATA
好数据的门槛
数据不是越多越好,得看是哪一种。银河通用给过一个分层,按获取成本从高到低、可规模化程度从低到高排:真机自主作业回流数据、真机遥操作数据、合成仿真数据、人类行为数据、互联网数据。
塔尖两层是真机数据,价值最高,也最难拿。自主回流那一层,数据是机器人在真实场景里干活时自己攒下来的,前提是你得先有足够多的机器人在跑;遥操作那一层,靠人戴着手套一遍遍示范,慢、贵,产能还被人力卡着。
再往下几层,各有各的短板。合成仿真数据便宜、能批量生成,可物理引擎里的摩擦、形变、软物体,总跟现实差一口气,还得拿真机数据回头校准;人类行为数据贵在第一视角,动作有了,力感和本体感没有;互联网数据量最大,离“机器人怎么使劲”也最远。便宜的数据不顶用,顶用的数据不便宜。
塔底那三类,仿真、人类行为、互联网,拿来训练机器人,效果约等于递给你一本《汉语大字典》,让你写一部《四世同堂》。字都认得,小说写不出来。
把这五层排下来,其实是一条“含力率”的阶梯。越往下,数据越像“看过”;越往上,数据越像“干过”。机器人要学的是干活,不是看片。
说到底,具身智能的训练,是把“物理世界的常识”灌进模型。这种常识没法只靠读,还得靠碰。碰一次的成本,决定了这条路能走多快。
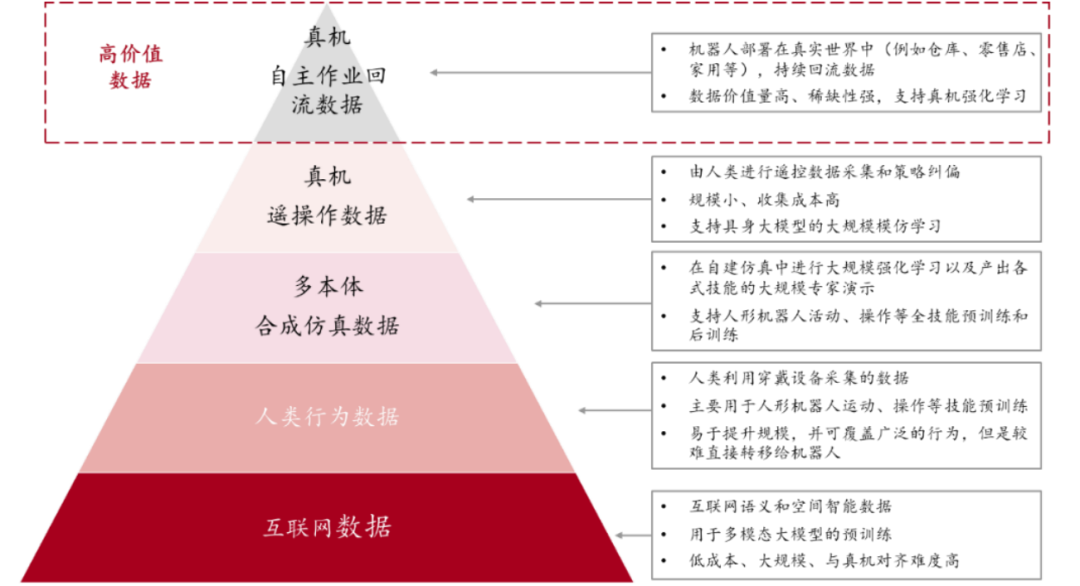
—具身智能数据分层:越靠塔尖,价值越高(据银河通用分类)
所以别被“数据量”三个字晃了眼。具身智能缺的从来不是数据条数,是带着力、带着触感、带着真实反馈的那一部分。它没法从网上爬,也很难靠合成补足。
03·THE HARDWARE
涨的是设备
有意思的地方,在这轮涨的标的身上。福莱新材、汉威科技、奥比中光、奥普特,做的都不是数据,是设备:触觉手套、3D视觉感知硬件、传感器。底层逻辑指向同一个趋势,人形机器人要靠视、力觉传感器构建立体感知。
视觉是机器人的眼。多目视觉、深度感知,帮它认出环境结构、目标位置,给路径规划和动作生成打底。可光有眼睛不够。抓一颗鸡蛋,认出来不难,难的是那一下用几分力。真实物理交互里的不确定性,视觉覆盖不到。
力觉和触觉传感器补的正是这块:接触状态、受力变化、物体属性,直接感知,撑起柔顺控制、精细操作、安全交互。看和走,是看懂世界;抓、用、协作,是另一回事。三种感觉凑齐,机器人才算真摸到了世界。
再往深一层,入口还不止传感器。灵巧手本身就是数据入口:指尖的触觉阵列记下压力分布,关节记下位姿和力矩,抓握一次,就是一帧带力感的高质量样本。手做得越灵巧,采回来的数据越细,能训出来的动作也越细。
过去一年,行业里也在建数采基地、遥操作工场,靠人一遍遍示范动作。这条路能解燃眉之急,可它卖的是人力,不是产品,规模越大,成本越沉。
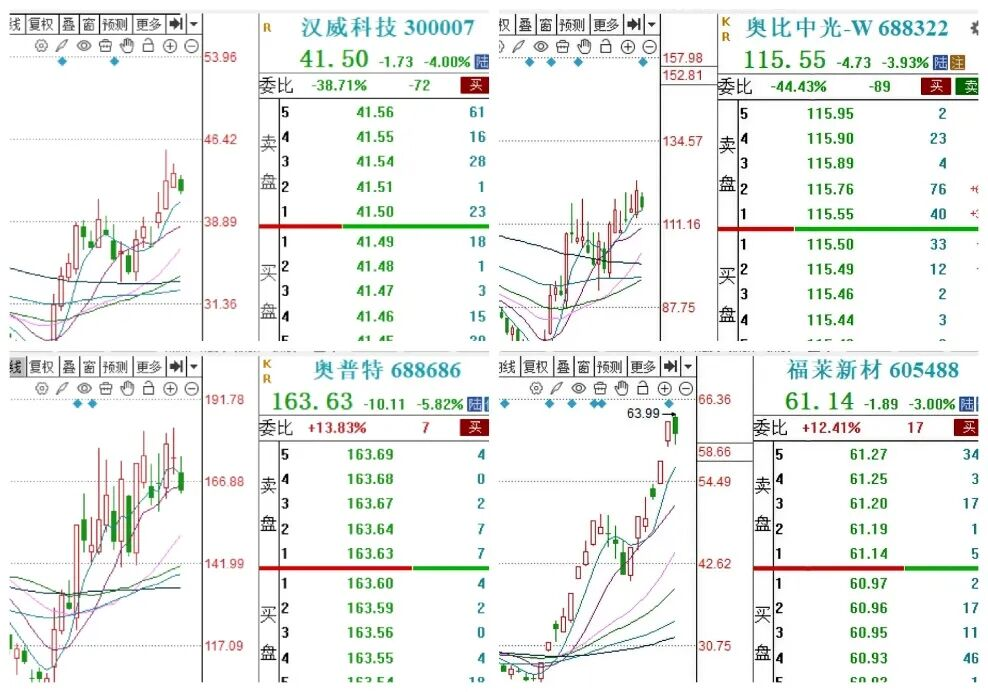
—数采概念股近期走势:福莱新材、汉威科技、奥比中光、奥普特
顺便说一句,行情归行情,产业归产业。设备公司这轮涨的是预期,预期能不能兑现,要看两件事:人形机器人出货量什么时候真正起量,单台机器人的传感器价值量又能不能稳住。这两件事,都不在数采服务商手里。
这也解释了钱为什么最终落在传感器、灵巧手、视觉模组身上:它们不采数据,它们造的是采数据的入口。
∞·POSTSCRIPT
别把环节当产业
回到开头那个反直觉的判断。
数采的必要性没什么争议。但真正有质量的数据,不是服务商组织人在场景里采出来的,是机器人本体在真实世界干活时自己回流出来的。这批数据从哪儿进?视觉系统,和灵巧手。
再往下推一步,是个乘法。人形机器人量产规模每上一个台阶,回流数据就跟着指数级涨。数据不是采出来的,是长出来的,长在每一台出厂的机器上。
卖硬件的站在数据入口上,量产越放量,他们越受益;数采服务商手里既不掌握数据的源头,也拦不住数据随本体自由流出。
换个说法,这不是一门“谁能采到数据”的生意,是一门“谁出货越多、数据越多”的生意。前者按项目结账,天花板在人力;后者随产能滚动,天花板在出货量。位置不同,命就不一样。环节就是环节,撑不起一个产业。一轮行情再猛,也别把环节当成了产业。