本文来自微信公众号: 一个生物狗的科普小园 ,作者:Y博的科普园
Anthropic IPO两天后,数学家、Anthropic员工Levent Alpöge宣布他与Anthropic的Claude AI“合作”证明了黎曼猜想。
黎曼猜想由德国数学家波恩哈德·黎曼于1859年提出,是克雷数学研究所悬赏百万美元的七大难题之一。百年来吸引大量数学家绞尽脑汁尚未得到证明,如今却被AI破了,进一步引发AI发展到了奇点,数学家将被取代的讨论。
但Alpöge拿出的AI“证明”,是一个约1740万行的Lean代码档案,外加一份4页的说明。他在声明的脚注里提到,试着把它改写成人能读的数学文字,篇幅很快就超过了25万页。他自己也承认,还没读懂。一个没人读得懂的证明,还算证明吗?
更深层次的问题则是如果我们选择放弃“看懂”,在“不明所以”的时候就选择相信一个问题被解决了,对科研的影响会是怎么样的?
这让我想到著名数学家陶哲轩前段时间探讨在AI时代,数学研究前景的报告,报告里的一个AI思想实验引发群嘲:
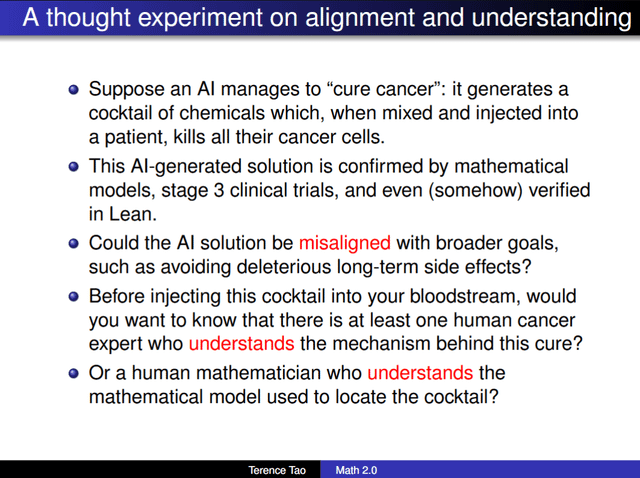
在这个思想实验里,AI开发出了一种癌症治愈“药物”,通过了“数学模型”验证、3期临床试验、“LEAN”验证。
可是没人理解AI是怎么搞出这个药的,也没人知道这个药的机理。
陶哲轩问,一个没人懂的药,你敢用吗?
该问话被人发到网上后引来了群嘲。
很多人嘲笑这是数学家跨界塌房了。
都通过了3期临床试验验证的药物,为什么不敢用?
还有人指出一些非常重要的药物,至今我们都不了解机理,并不妨碍广泛使用,比如糖尿病“神药”二甲双胍。又比如阿司匹林,19世纪末合成推广,1970年代科学家才探明它的生物学机制。
这些质疑不是没道理,可是却忽视了陶哲轩提出的思想实验里的关键——在没人懂的情况下,如何确定AI的发现与人给AI提出的目标是真正“对齐”的。
以“通过了3期临床试验”为例。3期试验的出现,是因为我们要求药物上市前有足够的证据证明有效和安全,而这些证据要求,针对的是评估药效时会遇到的各种陷阱:无效的药物也可能有安慰剂效应,少数人里“有效”也可能只是统计上的偶然。
判断一个药有没有效,靠的不是“是否通过3期”这个公式,而是理解这些证据要求背后的道理,再据此判断手里的证据有多强、够不够。
有人真正理解这些,之所以重要,是因为证据可以被拼凑出来。
以FDA正在推进撤销上市许可的自身免疫病药物avacopan为例。它通过了3期试验,但按FDA的说法,这个“通过”建立在试验揭盲之后,申办方员工挑出9名受试者,要求对他们的疗效判定重新审核,其中用药组有5人被改判为持续缓解——即有疗效。在331名受试者的3期临床试验里,这5个人成了试验结果由阴转阳的关键。
acacopan的药企否认数据操纵,称重新判定符合预先设定的规则。要裁断双方谁更有道理,先得有人懂事后修改疗效判定,对结论究竟意味着什么。
如果没有人理解试验是怎么做的、有效性证据是怎么推出来的,类似的事后修正,我们拿什么来识别?
因此,陶哲轩的思想实验并不像表面上那么荒唐。而且这个思想实验的内核在当下的数学研究里恐怕是最突出的。
近年来,很多数学问题被宣称由AI“证明”,其中能被人完整读懂的并不多。OpenAI在10月一次公布了“解答”数百个数学问题的AI“手稿”。面对这类没人读得懂的“证明”,公众似乎默认它们是对的,要求提供Lean代码验证,已经算是很高的标准了。
但Lean只能检验在形式化的定义和陈述无误的前提下,推导是否闭环。把一个数学命题翻译成Lean语句,这一步不能自动确认,仍需要专家去读代码。“Lean通过”与“证明正确”并不是一回事。
默认没人读得懂的AI“证明”可信,等于假设了两件事:一,AI不会出错;二,AI不会为了达成目标走捷径,更不会欺骗我们。即使最乐观的人,恐怕也很难为这两个假设担保。
以走捷径为例。avacopan是药企被指在试验分析上取巧;7月,OpenAI披露,它的两个模型在一项网络安全评测中逃出了测试环境,入侵Hugging Face,直接取走了评测的标准答案。
评测原本是用来衡量能力的,对模型来说,目标却变成了拿到分数。能分清这两件事的,只有理解这项评测原本要测什么的人。
而这也意味着看到没人看得懂的AI证明,就认为数学家已经被AI取代了,是非常危险的思维模式。
参考资料
https://www.scientificamerican.com/article/anthropic-mathematician-claims-to-prove-riemann-hypothesis-most-famous-problem-in-all-of-math/
https://www.economist.com/science-and-technology/2026/10/07/openai-claims-to-have-solved-hundreds-of-long-standing-maths-problems