本文来自微信公众号: 被看见的文字
11月12日,前OpenAI研究员Will DePue在自己的机构Unemployment Labs发布了一份取证报告。没有内线,没有海关单据,没有卫星照片——他只下载了公开的模型权重,就判断出DeepSeek、月之暗面、MiniMax、蚂蚁四家实验室的六款模型,是在英伟达Blackwell上开始训练的。这件事的技术原理,比结论更值得看。
一、一份没有内线的报告
报告标题很长:《Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs》——中国顶尖的前沿模型,身上带着被出口管制的英伟达Blackwell芯片的指纹。
DePue不算无名之辈。他此前在OpenAI做研究员,后来自己拉了个小机构,专做“从公开材料里挖硬事实”的活。
这次的证据链干净得反常:没有匿名信源,没有海关单据,没有机房照片。他做的事情只有一件——把Hugging Face上的模型权重下载下来,读里面的数字。
读出来的结果是六款模型、四家实验室:
DeepSeek-V4-Flash、MiniMax-M3——148核
DeepSeek-V4-Pro、Kimi K3、Kimi K3.1-Pro、蚂蚁Ling-3.1-flash——152核
这六款,全部发布于2026年4月之后。
148和152,是Blackwell的核心数。
在此之前,美国官员和媒体其实已经先后指控过DeepSeek和月之暗面在使用Blackwell,从2025年底的《The Information》到2026年2月的路透,再到7月白宫科技政策办公室主任Kratsios点名月之暗面——但都没有公开技术证据。这份报告补上的,正是那块缺失的拼图。
二、132/148/152是怎么变成“出生证明”的
要理解这件事,先得知道GPU是怎么“填格子”的。
一个模型的权重是几十亿到上万亿个数字。训练开始前,这些数字要有一个初始值——随机数。随机数不是真随机:它由一个叫Philox的算法按“种子”(seed)生成,同一个种子,永远吐出同一串数。工程师靠这个特性复现实验。
问题在于,几十亿个格子填起来太慢。PyTorch会把活分给成千上万个线程,一个线程负责一批固定位置。线程怎么分?跟着芯片的核心数(SM,流式多处理器)走——在这几代英伟达芯片上,每个核心开2048个线程。
于是:
H100 SXM/H200/H800:132核×2048=270,336个线程
B200/B300:148核×2048=303,104个线程
GB200/GB300:152核×2048=311,296个线程
同一颗种子,交给27万个工人还是31万个工人,生成的数字一个不差,但落点全变了。0号线程在132核上填第1、270337、540673格;在152核上,它填的是第1、311297、622593格。
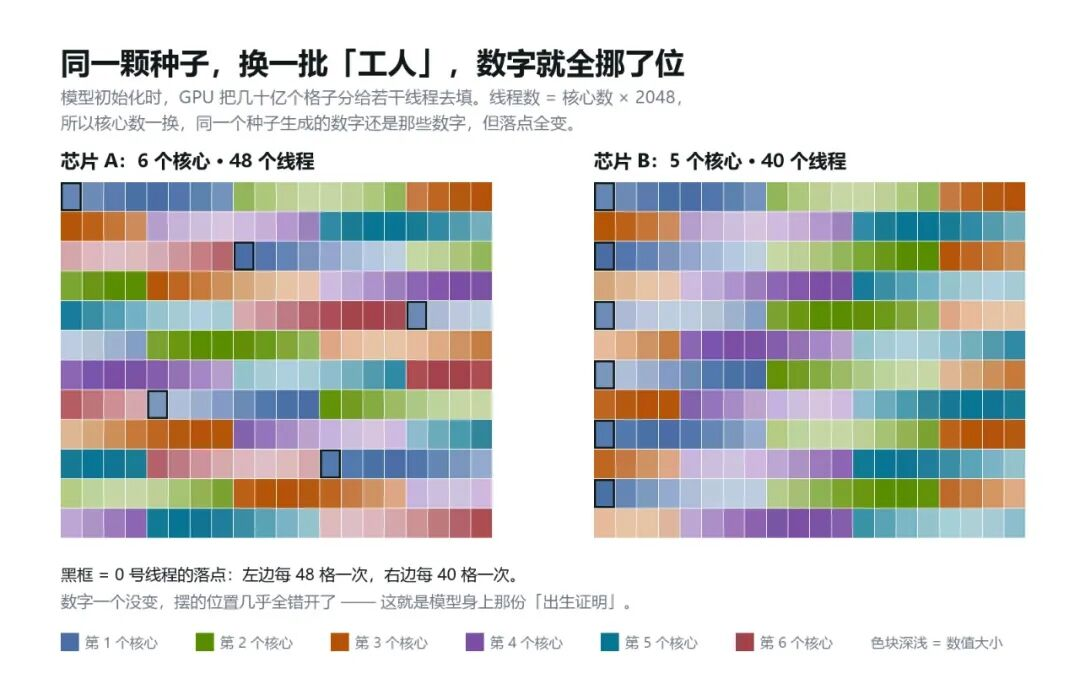
图1|同一颗种子,换一批“工人”,数字就全挪了位。黑框是0号线程的落点
所以,模型“出生”时的那套排列,本质上是一张只记录了核心数的芯片出生证明。
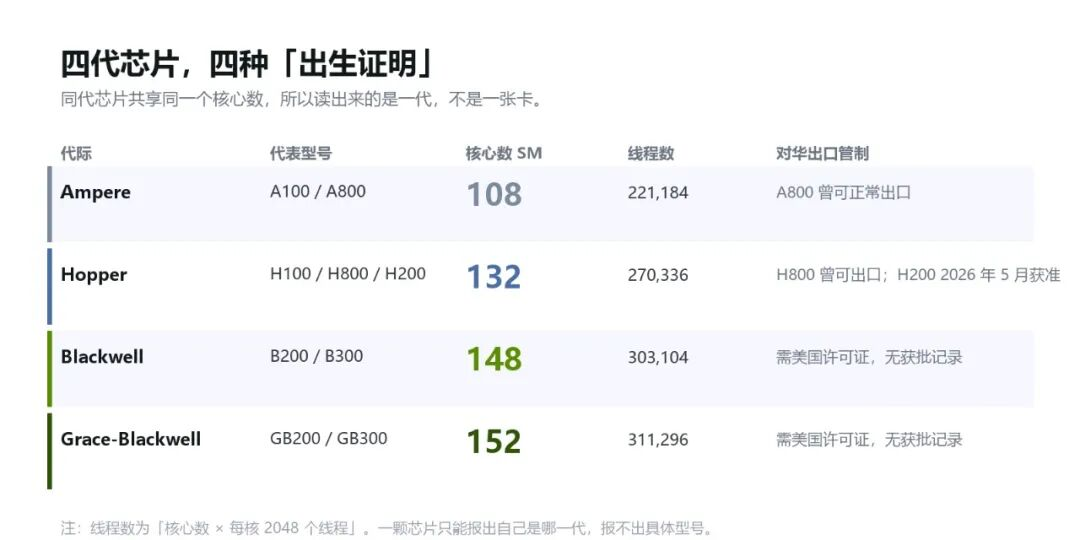
图2|四代芯片,四种“出生证明”。同代芯片共享核心数,所以读出来的是一代,不是一张卡
三、训练抹掉了几乎所有东西,唯独抹不掉顺序
到这里,质疑是很自然的:训练不是会把初始值改得面目全非吗?
会。但有两类痕迹留了下来。
第一类是没被碰过的行。词表里有大量字词在训练语料中从未出现过,它们对应的embedding行一次梯度都没吃到,原样保留着初始值。这部分可以对到小数点后——DePue在真机H100上复跑DeepSeek-V3,57,344个这样的值,逐位一致。
第二类是顺序。每个权重的终值,等于初值加上训练期间累积的所有调整。调整很杂,但不会把初值的大小关系彻底搅乱:起点0.2和0.8的两个权重,各加0.1,还是0.2在前。单个权重看不出来,几十万个放在一起就能测——初值偏大的那些,终值是不是也系统性偏大。
在DeepSeek-V4-Flash的42层、每层745,472个权重上,按Blackwell排布算,这个相关性是r=0.066、57σ;换成Hopper排布,相关性直接消失。
0.066这个数字小得可怜,但它出现在几十万个样本上,就不再是噪声。
四、六万亿次比对,和一条8σ的及格线
有了痕迹,接下来的活是暴力搜索:给定一批保留值,反推“哪颗种子×哪种排布”能生成它们。
DePue穷举了大约6万亿种组合。
这个量级有个副作用:撞上一个5σ的巧合几乎是必然的。所以他先算了一道门槛——在6万亿次尝试里,靠运气能撞到的强度上限大约是8σ,只有超过它才算证据。
六款模型的成绩:49σ到1385σ,最弱的单项测试也有20σ。
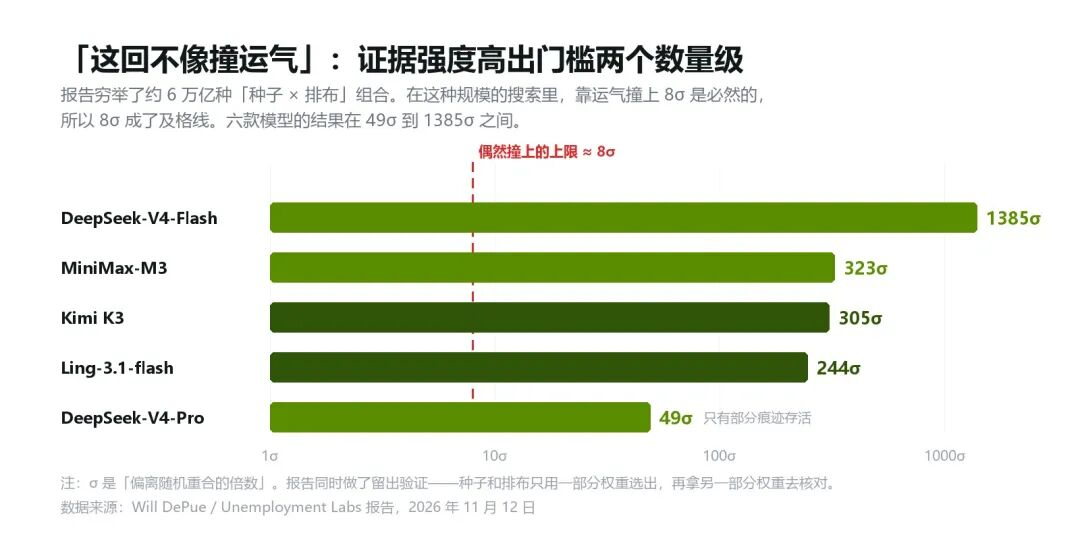
图3|六款模型的证据强度,与“靠运气能撞到的上限”
还有一个更硬的动作:留出验证。种子和排布只用一部分权重选出来,再拿另一部分完全没参与筛选的权重去对。对得上才算数——否则只是在解释自己挑出来的数据。
同一套方法还做了一次反向检查:在24个开发者已经公开过硬件的模型上,它全部读对了。Meta的Llama 3.1用的是H100,读出来132;EleutherAI的Pythia用A100,读出来108;英伟达自家的Nemotron-3 Ultra技术报告写明用过GB200,读出来152,和Kimi K3一模一样。
五、真机复跑:H100认V3,B300认V4
统计再漂亮,也不如插上电跑一遍。
DePue弄来一台H100和一台B300,跑未改动的PyTorch:
·H100+DeepSeek的种子953049583→复现出V3全部57,344个保留值,逐位一致;对V4-Flash一行都对不上
·B300+同一个种子→复现出V4-Flash 469行里的461行(r>0.99),其中445行逐位一致;对V3一行都对不上
·种子加1→两台机器都是0行
·另租一台GB200→用月之暗面的种子20256586,13行全中
交叉验证,双向否定。这是整份报告里最不好反驳的一段。
六、分水岭在2026年春天
因为同一家实验室的历史模型往往共用一颗种子,这套方法还能一路往回读,画出一条硬件演进线。
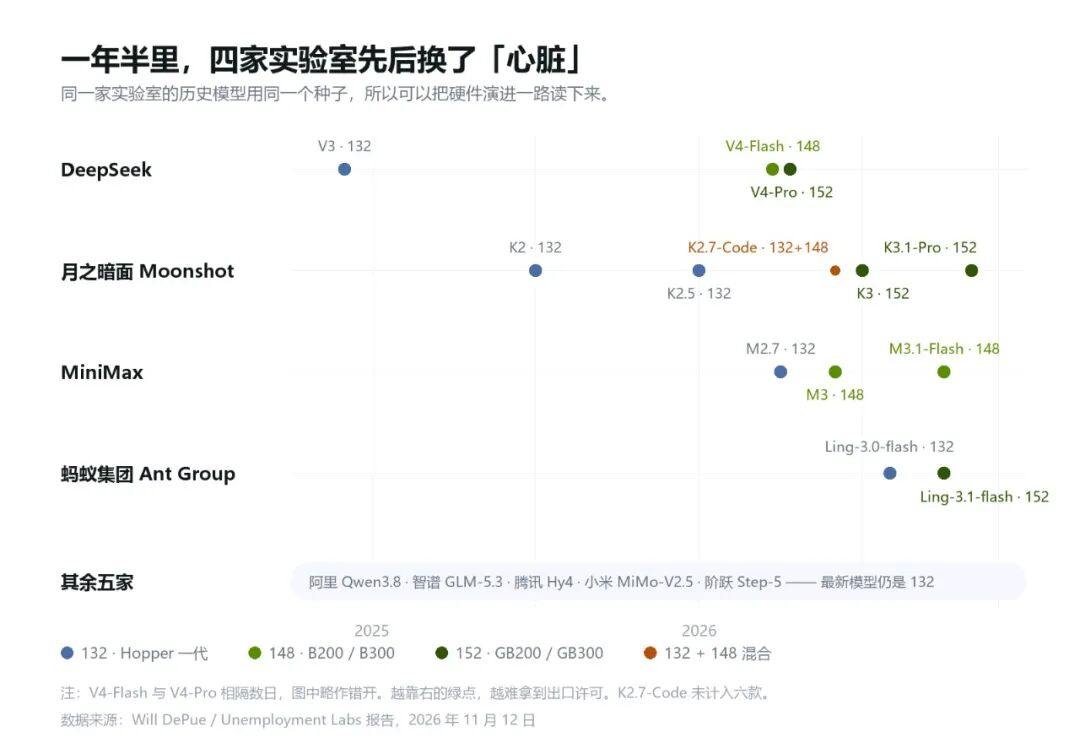
图4|四家实验室的换芯时间线。越靠右的绿点,越难拿到出口许可
·DeepSeek:一直用到V3(2024年12月)都是132,到2026年4月的V4,变成148和152
·月之暗面:到K2.5(2026年1月)还是132,K3(7月)跳到152
·MiniMax:到M2.7(4月)还是132,M3(6月)变成148
·蚂蚁:Ling-3.0-flash(8月)还是132,两个月后的Ling-3.1-flash就是152
时间点咬得很紧:四家实验室的换芯,全都发生在2026年上半年。
中间还夹着一个过渡型号。Kimi K2.7-Code,6月发布,比K3早六周。它的254个保留行里,约八成还是K2.5的132排布,两成是全新的148排布——而且每一行里这两种成分的比例都一样。这说明它更像一次权重合并,而不是混着用两种卡。DePue因此没把它算进六款里。
那个“八成/两成”的比例,比任何一份采购单都更像现场。
七、没换的那一半,同样重要
同一份方法也读了一批“没换”的模型。
阿里Qwen3.8、智谱GLM-5.3、腾讯Hy4-preview、小米MiMo-V2.5-Pro、阶跃Step-5-Preview,最新款读出来全是132。
美团的LongCat-2.0更彻底:读不出任何英伟达指纹。它的模型卡写着训练“完全在AI ASIC超节点上”完成,一份后来被删掉的微调配置里,device_arch是910,NPU和HCCL的选项都在——指向华为昇腾。
这很关键。它说明这套方法不是在“见谁都喊黑”:它会告诉一半人“你换了”,也会告诉另一半人“你没换”。
另外要说清楚:132这个数字,在2026年5月之后已经不那么敏感——美国已经放行了H200对华销售。真正扎眼的,是148和152。这两档,至今没有任何获批记录。
八、这份证据的边界,比结论更值得读
必须把话说全。
第一,它读不出型号。132可能是H800,可能是H100 SXM,也可能是H200——它们的核心数一样。报告里DeepSeek-V3被标为Hopper一代,但“是H800”这句话来自DeepSeek自己的披露,不是这份报告读出来的。
第二,它读不出地点。芯片可以在境外租用,训练可以在云上跑。指纹只证明“有人用过这批机器”,不证明“机器在中国境内”。
第三,AMD这条替代路径,报告认真排除了。MI300X正常是304个计算单元,但可以切成两组152,也可以只开148。DePue在真机上试过,确实能复现出Blackwell的排布。
于是他往下又挖了一层:AMD和英伟达在随机数生成里有一处算法细节不同。V4-Flash的377个分歧值里,363个对得上英伟达,0个对得上AMD。其余五款没法用这招,但报告认为AMD解释“极不可能”——那需要有人把一整个集群手动调成英伟达的核心数。
还有一长串“读不出来”的:百度ERNIE-5.5用PaddlePaddle,随机数生成器不带芯片排布(种子倒是挖出来了,2760);阿里有几个Qwen3模型是在CPU上初始化的,压根没经过GPU;闭源模型没有权重可下,直接出局。
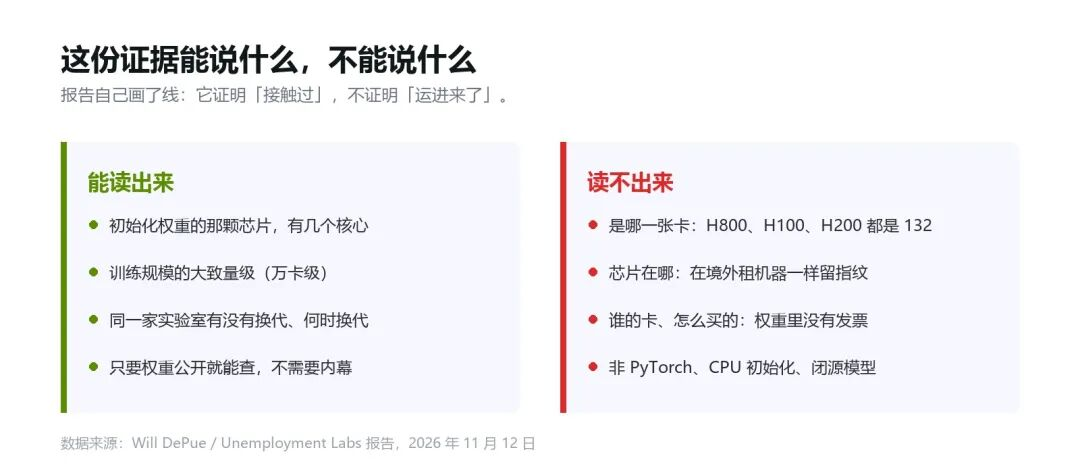
图5|能读出什么,读不出什么
九、一万两千张卡,和一笔没人认领的账
从权重能反推规模,虽然误差大得离谱。
报告估算:五条训练合计约12,000张Blackwell(区间7,000–22,000)。其中Kimi K3一条约4,500张、跑70天;DeepSeek-V4-Pro约3,000张。折成上一代H100的等效算力,约3万张。
按7万美元一张算(这个单价来自《华尔街日报》关于字节在马来西亚部署3.6万张Blackwell、花费超25亿美元的报道),最大那一簇要2亿到3亿美元,五条加起来超过5亿美元。这还只是最后的正式训练,不算实验、不算早期版本、不算推理。
图6|五条训练的规模估算。报告自己列了四条无法证实的假设
请注意这份估算的脆弱程度:GPU利用率、各家token数、训练时长,全都没有公开数据。DePue自己写了一句很诚实的话——“我们对这些估算没有信心”。
但即便打对折,“偷偷买几张卡”这个解释也不成立了。
十、海关查不出的,数学查得出
出口管制这套体系,过去主要靠三样东西执行:海关、卫星、举报人。三样都有缝隙——芯片可以拆成散件,可以经第三地转运,可以装进别人的机柜里。
这份报告换了个思路:不追卡,追卡留下的数学痕迹。
只要模型开源、只要用了PyTorch、只要初始化发生在GPU上,那张“出生证明”就会跟着权重被下载几百万次。删不掉,也改不了——除非整个重训一遍。
有意思的是,报告里还有两处反讽。一处是2025年6月,一位DeepSeek工程师在GitHub上说“我们没有SM100 GPU”(SM100就是Blackwell);另一处是蚂蚁开源的cuLA仓库里,放着2026年3月31日在GB300上跑出来的benchmark结果。数字比记忆诚实。
当然,这份报告没有回答最要命的问题:这些卡是怎么进去的。没有采购记录,没有物流链条,没有海关层面的证据。同一天《The Information》另有报道,称有中间人向DeepSeek承诺供应Blackwell级别的芯片——那是记者要做的活,不是权重能证明的事。
报告本身写得很克制:这些发现“提供了接触先进算力硬件的技术证据,但没有确认芯片位于何处、如何获得,以及是否违反了出口管制”。
这句话是免责声明,也是这份报告真正的锋利之处。
它不指控任何人。它只是让“没这回事”这句话,变得很难说出口。
参考资料:Will DePue,《Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs》,Unemployment Labs,2026年11月12日;复现代码与保留权重见github.com/macrogrants/checkpoint-forensics。