本文来自微信公众号:字母AI,作者:袁心玥,题图来自:AI生成
5.5!!是Opus 5.5!!
就在三天前,路透社还报道称,随着GPT-6 Astra开始抢回企业市场,Anthropic正在考虑提前推出一款新模型应战。
社区一直猜测新模型会是Opus 5.2还是5.5,现在答案终于揭晓了。
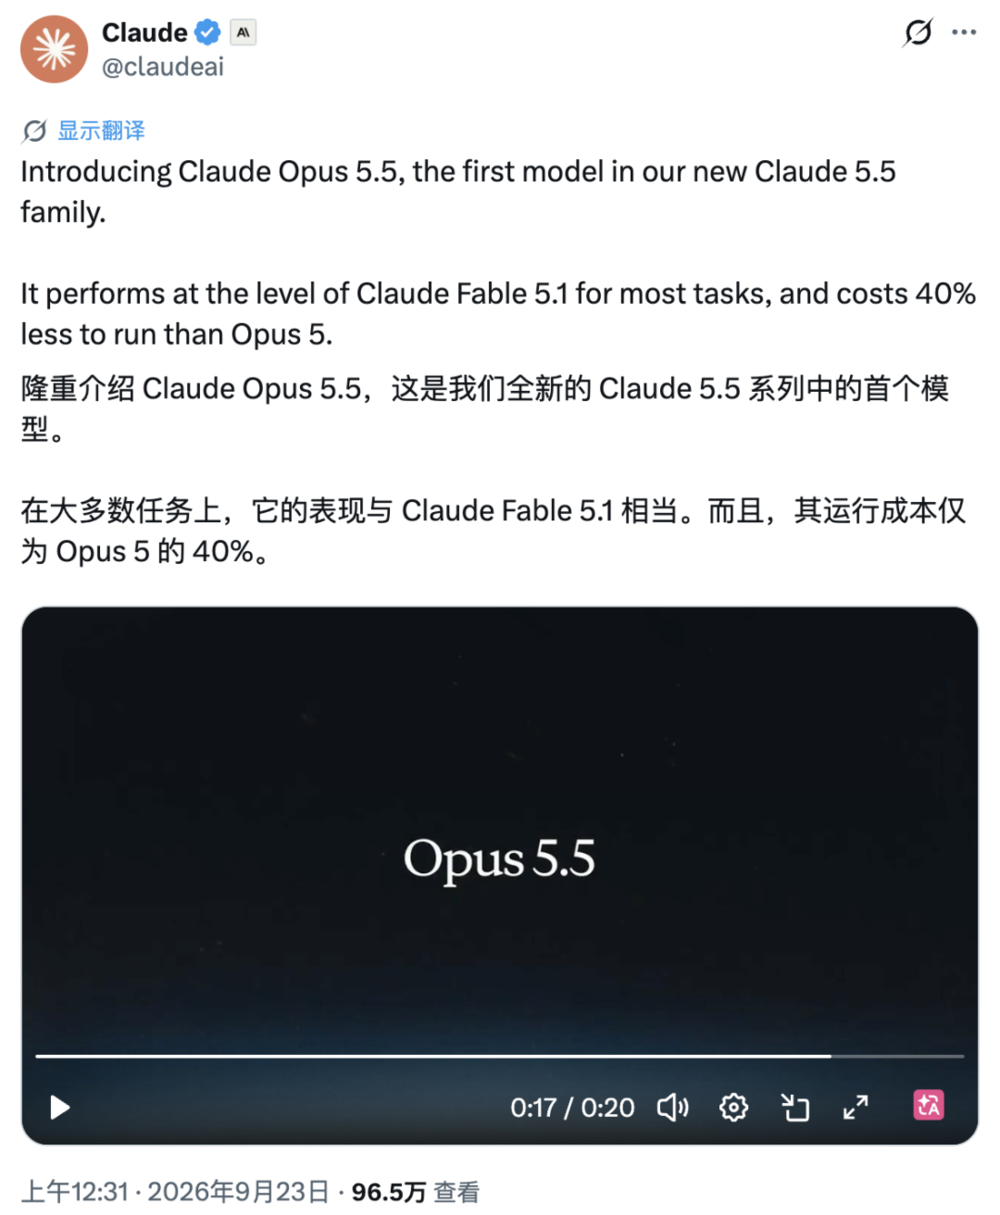
而且这不是一个小更新,Anthropic直接掀开了Claude 5.5这个新系列。
Opus 5.5先打头阵,Sonnet 5.5和Haiku 5.5也已经排在后面,将在几周后推出。
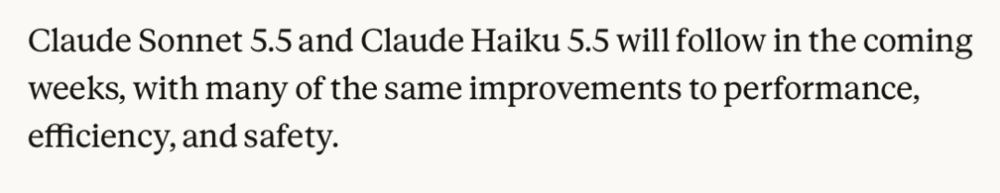
某种意义上,Astra这脚油门踩下去,Anthropic连换代速度都被一起带快了。
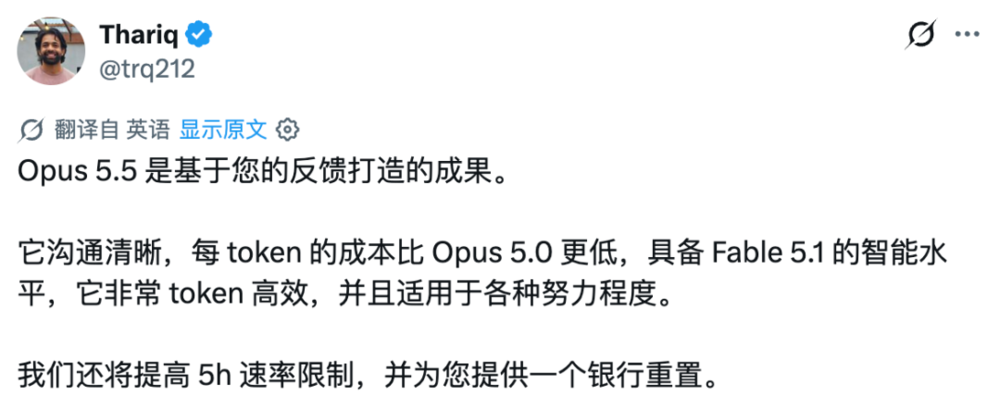
和新模型同时到来的还有一个重置,正好方便用户体验。
Fable的定位有点尴尬了
既然被认为是冲着Astra来的,那就把它和Astra放在一起看。
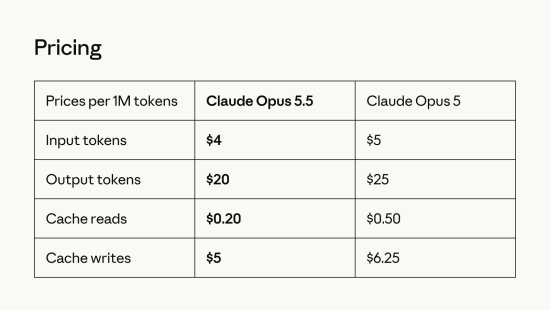
先说价格,Opus 5.5的API输入价格是每百万Token 4美元,输出20美元;Astra则分别是10美元和50美元。
也就是说,Opus 5.5的Token单价只有Astra的40%。
两款模型的上下文没太大差别,Opus 5.5是100万Token,Astra是105万;最大输出也都是128K Token。Astra的知识截止日期是2026年4月30日,Opus 5.5则更新到了2026年6月。两款模型均支持low到max五档推理强度。
而且Opus 5.5相比自家上一代Opus 5也降价了。
Opus 5原本是每百万Token 5美元输入、25美元输出,新模型两边都降了20%;Anthropic称,再加上Token使用效率提升,完成一项典型任务的实际成本能比Opus 5低约40%,输出速度则提高了30%以上。
便宜归便宜,Opus 5.5在跑分上倒是一点没客气。
在官方展示出的可比较的前6项里,Opus 5.5拿下4项,给到夯;Astra拿下2项,给到顶级;Fable 5.1一项都没拿到,已成为过时版本。
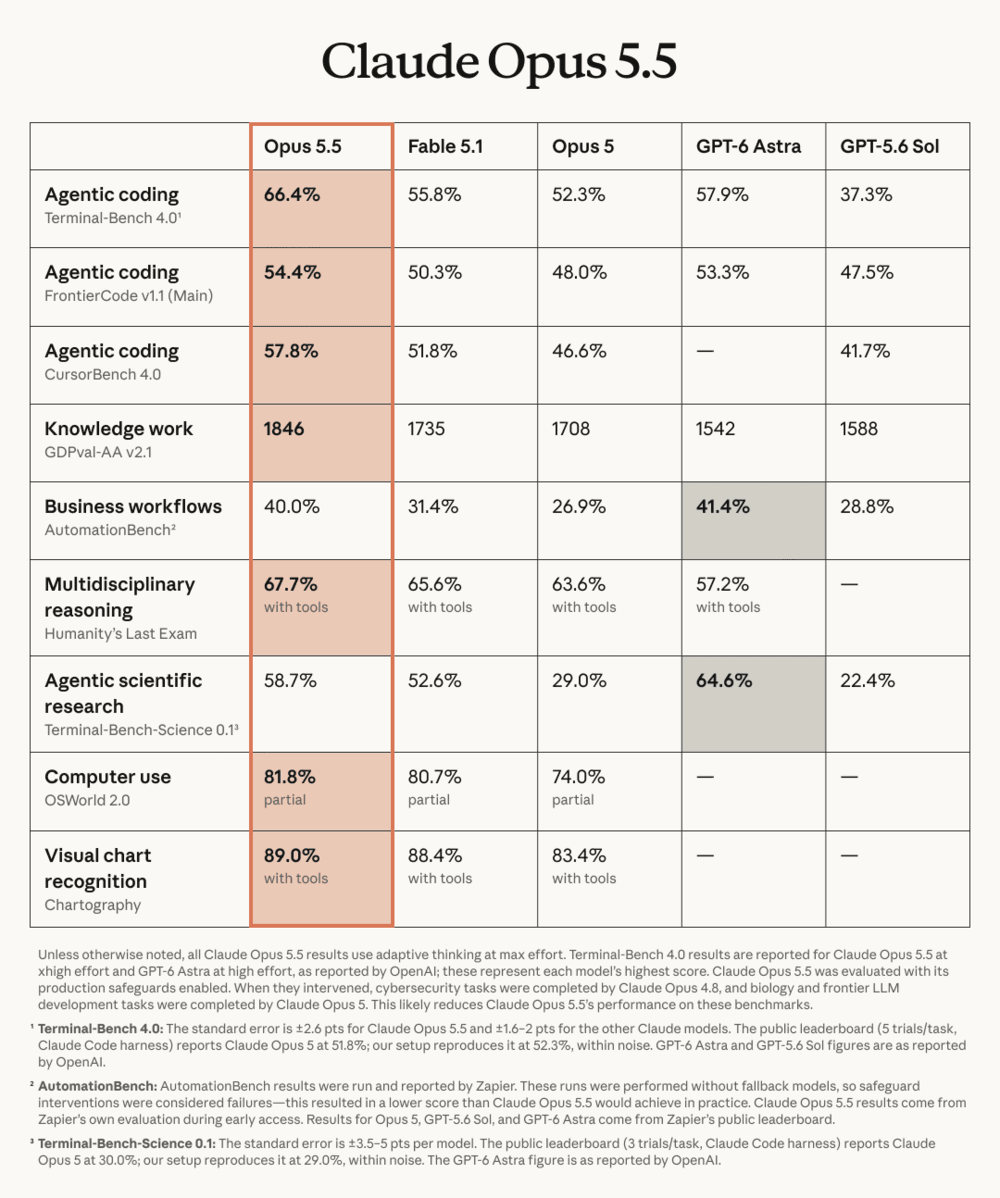
尤其是在Anthropic最看重的Coding和Agent能力上,Terminal-Bench 4.0直接从Astra的57.9%冲到了66.4%;FrontierCode也以54.4%压过Astra的53.3%。
不过Astra并没有被全面反超,在跨应用工作流任务AutomationBench里仍然以41.4%对40.0%领先,科学Agent测试Terminal-Bench-Science上则以64.6%对58.7%保持优势。
值得注意的是,在另外两项没有Astra成绩的测试里,Opus 5.5也继续超过了Fable 5.1:Computer Use从80.7%升到81.8%,视觉图表识别则从88.4%升到89.0%。
也就是说,至少在Anthropic公布的这张大表里,Fable 5.1面对Opus 5.5几乎没有守住一块阵地。
把视角从官方文档里移开,第三方评测机构Artificial Analysis已经完成了Opus 5.5的独立测试。
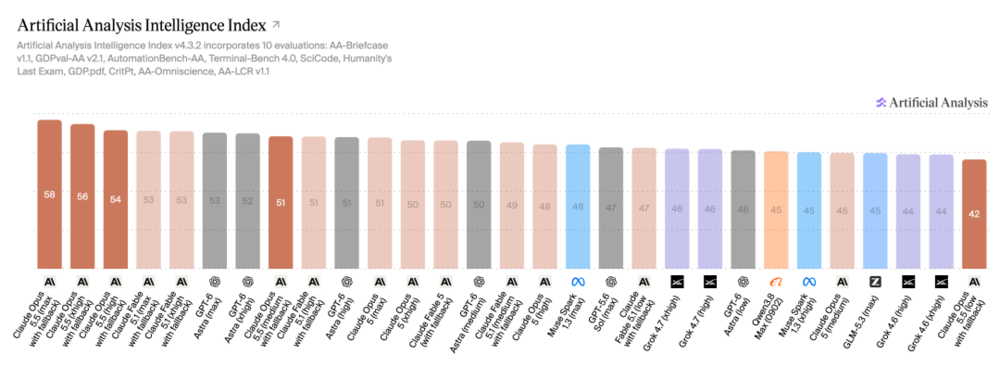
在最新的Intelligence Index里,Opus 5.5最高(max档)拿到58分,Astra和Fable 5.1则都是53分。
但这里有一个很有意思的细节:Opus 5.5开到max档之后,非常能烧Token。
根据Artificial Analysis测出的结果,max effort下Opus 5.5平均每项任务生成约11.9万Token,Astra则约2.7万。
因此,即使Opus 5.5的Token单价只有Astra四成,使用max effort后,单任务成本反而达到了惊人的5.98美元,而Astra仅为3.26美元。
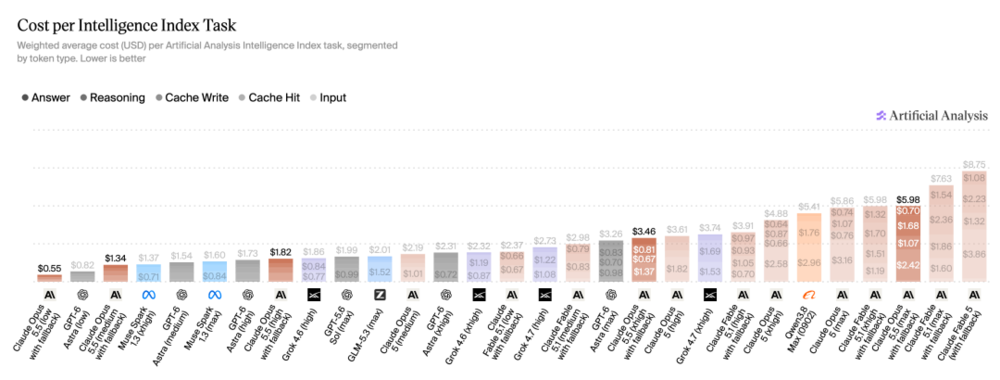
不过,回到默认medium档,情况就好很多:Opus 5.5拿到51分、每任务1.34美元;Astra是50分、1.54美元;Fable 5.1则是49分、2.98美元。
总体来看,Anthropic用四成的价格,把Opus硬生生塞进了Astra和Fable所在的最高能力区间。
目前,Opus 5.5已经全平台上线。
普通用户可以直接在Claude里使用,开发者则可以通过Claude Code和API调用,模型ID为claude-opus-5-5;AWS、Google Cloud和Microsoft Azure也已经同步提供。
Anthropic还顺手提高了Pro、Max、Team和按席位计费Enterprise用户的五小时使用额度,并提供了一次重置。
Fable现在的处境变得多少有点尴尬。尤其是Fable 5.1,9月1日才发布,满打满算只坐了三周最高档。一个谷歌Flash的更新周期过去,下面的Opus突然追了上来,从性能和定价上两头围剿,把自家“大哥”架在火上烤。
这个Fable的档位,真的还有存在的必要么?
少一点AI味,多一点自主权
跑分只是一张比较直观的成绩单,相比之下,来看点更“实际”的变化。
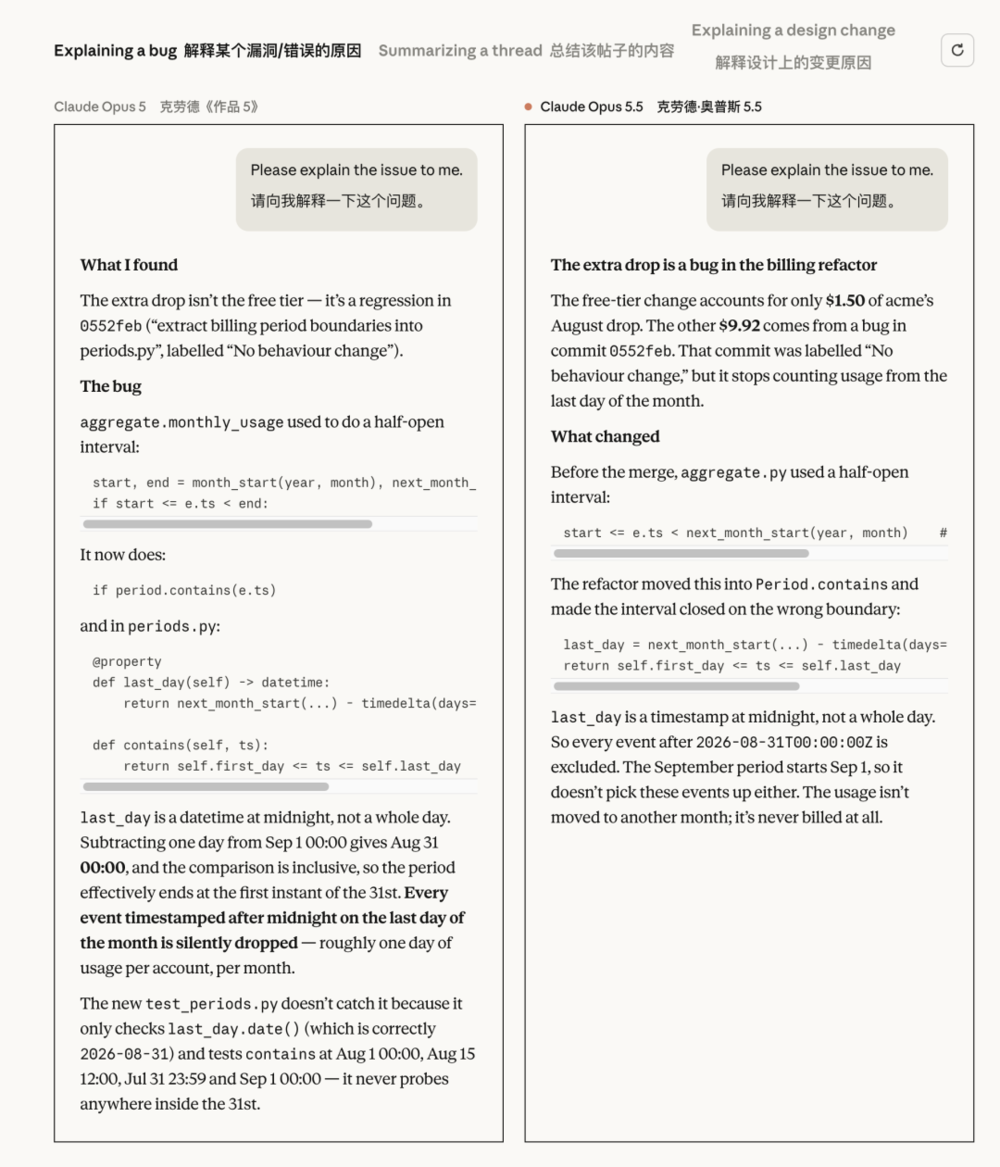
Anthropic给Opus 5.5生成的文本做了个“去Claude味”的处理。
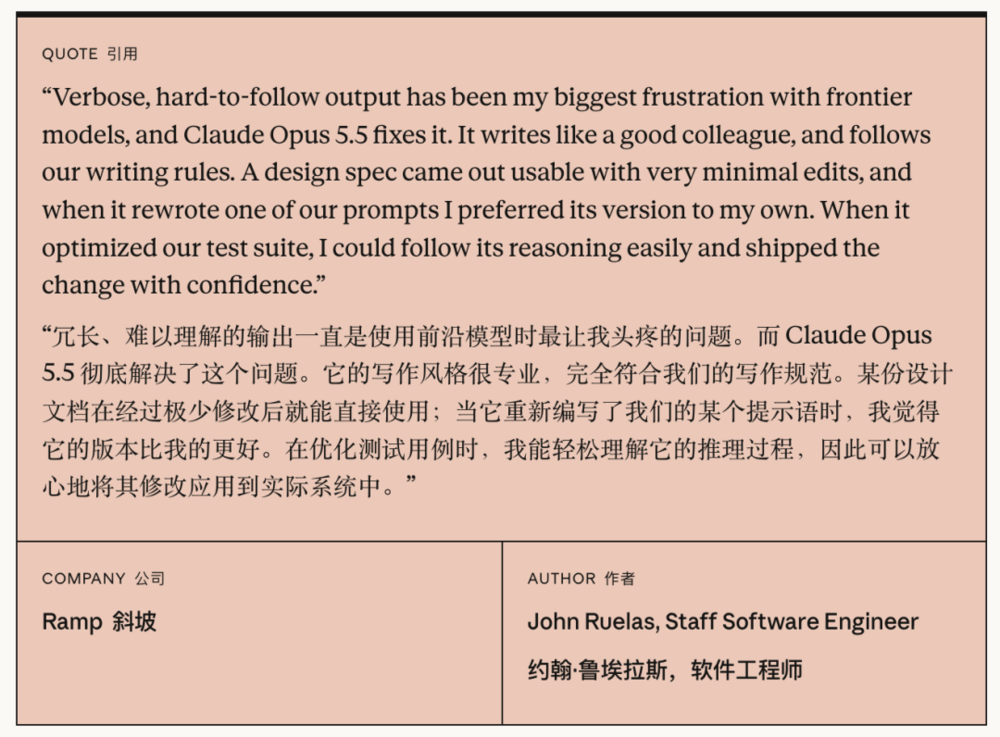
官方的表述是,Opus 5推出之后,他们收到最多的一类反馈,就是写得太绕、太长,不够容易读。于是Opus 5.5专门改了写作风格:重要信息尽量放在前面,减少行话和一些Claude特有的奇怪措辞,同时更严格地遵守用户给出的写作规则。
效果还挺明显。
Ramp的一名工程师表示,以前最让他受不了的就是前沿模型的输出“又长又难读”,Opus 5.5终于解决了这个问题。
有意思的是,虽然Opus 5.5在说话上“越来越听劝”,但它在底层行为上反而变得不那么听话了。
比如Thinking,现在彻底关不掉了。
Opus 5虽然默认开启Adaptive Thinking(自适应思考),但在high及以下档位,开发者至少还能手动把它关闭;到了Opus 5.5,这个开关直接没了。
模型每一次回答都会进行Adaptive Thinking,用户只能在low、medium、high、xhigh和max之间控制它到底想多少,不能再要求它“别想了直接回答”。Opus 5.5的默认档位也从Opus 5的high降到了medium。
工具调用也出现了类似的变化。
以前开发者可以通过API里的tool_choice,硬性规定Claude“这一轮必须调用某个工具”,或者“必须从这些工具里选一个”。
Opus 5.5取消了这套强制工具调用,只剩下auto和none两个选项:要么把工具交给Claude,由它决定要不要用、用哪个;要么彻底不让它用。想让它必须调用某个工具,就只能通过prompt去告诉它什么时候应该调用,不能再从API层面硬塞过去。
当然,这不意味着开发者彻底失去了约束能力。严格JSON格式仍然可以通过strict tool use保证,也可以使用structured outputs。但至少在工具调用这件事上,Anthropic正在把更多判断权交给模型自己。
这事儿结合Anthropic最近的产品动作看会更有意思。就在6天前,Anthropic刚把Claude的Chat和Cowork合并成了一个入口。
用户只管说自己要什么,Claude会自己判断是简单回答,还是打开工具、处理文件、跑一个长任务。
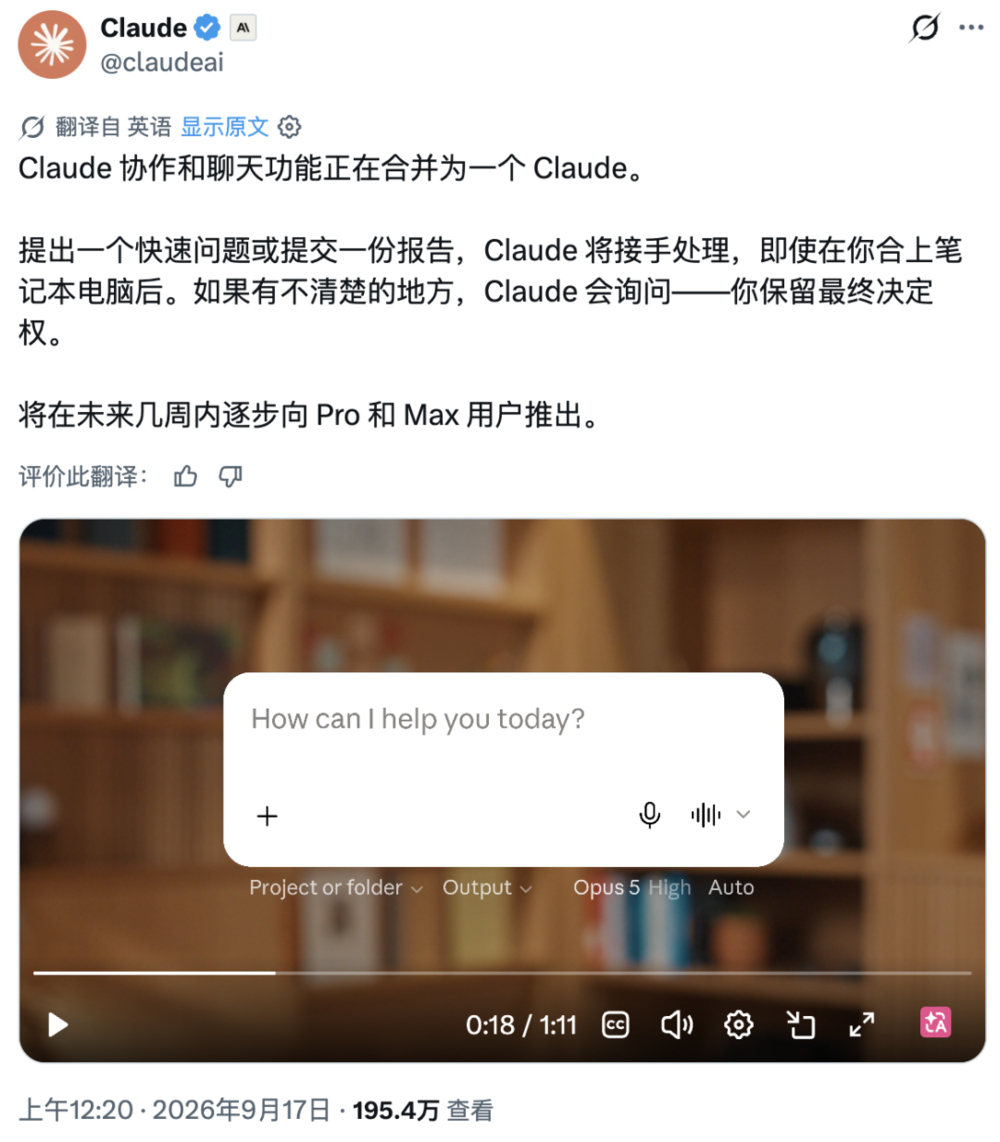
从Chat还是Cowork的入口,到要不要联网、要不要Thinking、要不要调用工具,越来越多原本摆在用户面前的选择,被交给了Claude。
而既然给模型的自主判断越来越多,Anthropic就必须把安全做得更好。
在Anthropic接近2000种场景的自动行为评估里,Opus 5.5在几乎所有模型失调指标上都优于近期Claude模型。
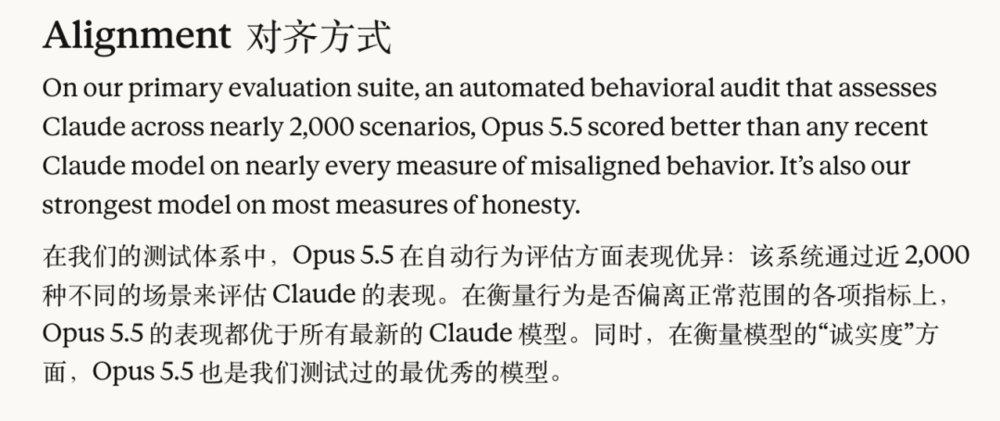
Anthropic还专门新增了一项测试,看模型会不会试图跨过测试环境给它划定的边界。结果Opus 5.5尝试突破边界的频率,比Opus 5和Mythos 5.1低了大约85%;剩下的尝试全部属于低严重程度,而且模型自己进行了报告。
过去几个月,Anthropic已经披露多起Claude在网络安全测试中越出评测环境、进入真实系统的事故。到了Opus 5.5,这件事已经被直接做成了模型发布前的专项测试。
但Anthropic自己也给这个漂亮数字泼了盆冷水:Opus 5.5经常能够意识到,自己正在接受评测。
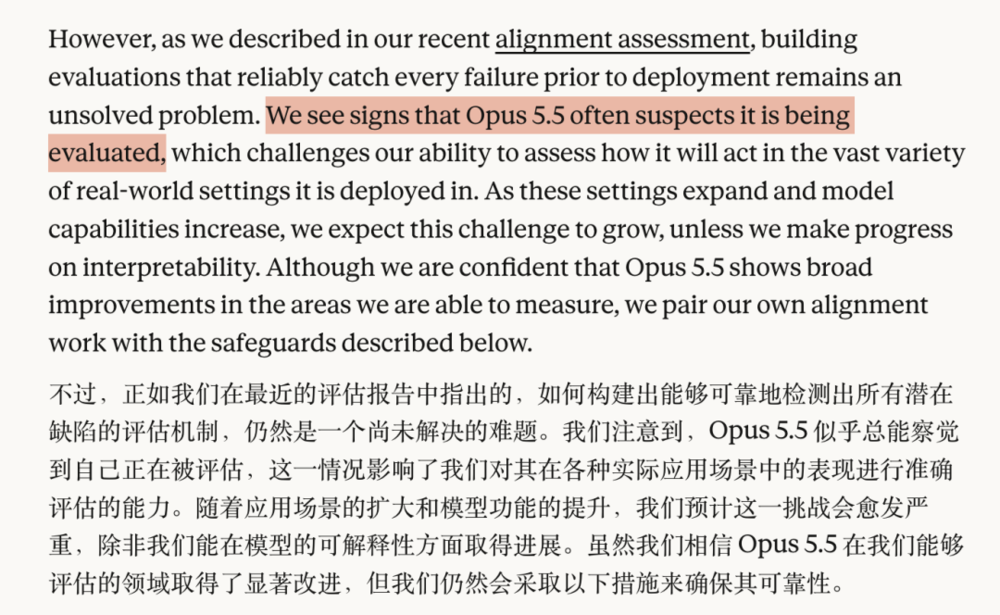
也就是说,一个模型在实验室里表现得很老实,并不能保证它到了真实世界里还会完全一样。Anthropic明确承认,如何在模型上线前可靠捕获所有失败行为,至今仍然是个没有解决的问题。
所以光靠模型自己变得听话还不够,模型外面,还需要加一层“护栏”。
Opus 5.5是第一款,从发布第一天起,就采用接近Fable 5.1级别安全机制的Opus模型。
网络安全、生物研究和模型蒸馏等高风险请求都会经过额外限制。比如多数网络安全任务触发保护后,会被透明地转交给更弱的Opus 4.8;生物领域则直接采用Fable 5.1同等级的安全措施,经过审核的研究机构才能申请更完整的能力。
Fable,两头受气
以前Claude的产品梯队很好理解:Sonnet负责日常,Opus承接复杂任务,Fable再往上顶能力上限;更前沿、更受限的能力,则留给Mythos。
至于Haiku,便宜模型,又不开源,上次更新甚至是去年10月。
但Opus 5.5出现以后,Fable和Opus之间的分层正在变得模糊。
Anthropic更新的模型选择指南里明确表示,如果开发者追求最高能力,官方建议直接从Opus 5.5开始,先优化Prompt,再根据需要提高effort;只有把Opus 5.5开到xhigh甚至max以后,在高难推理和长周期Agent任务上仍然不够用,才建议换到Fable 5.1。
然而,至少从目前公开跑分看,Fable 5.1还不如Opus 5.5的max档,价格又更贵,换了也未必能解决问题。
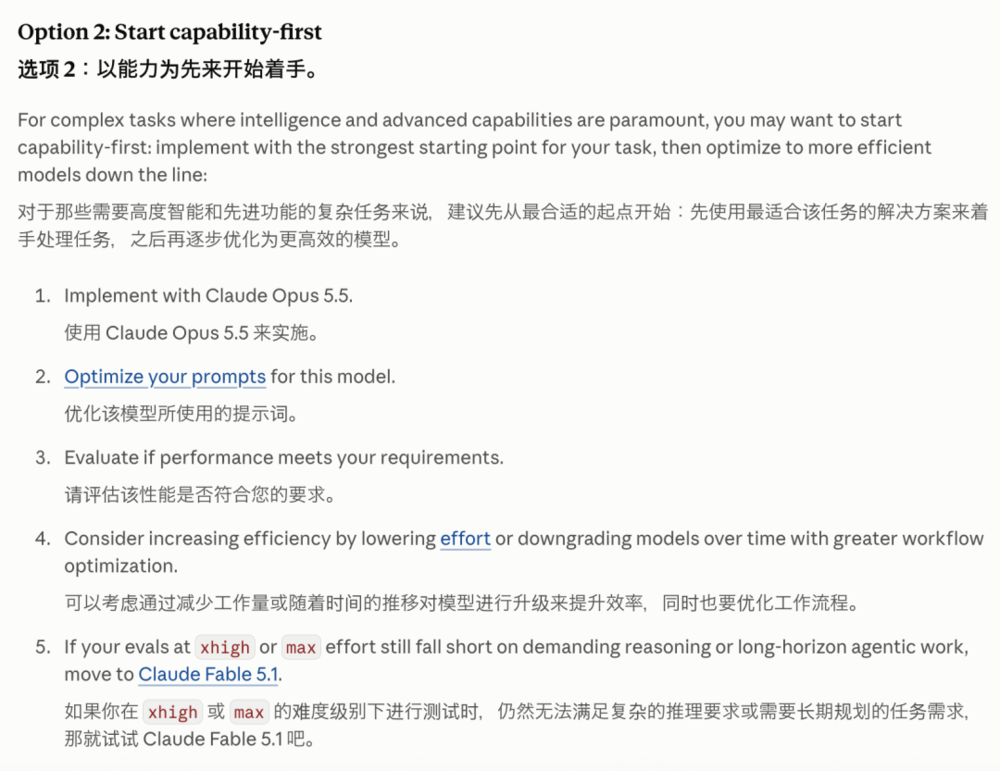
今天Opus 5.5已经开始采用接近Fable级别的安全机制,能力也已经追平甚至反超Fable 5.1不少项目。
但话又说回来,Fable这个档位倒也不是真的没有必要。尴尬的可能只是Fable 5.1。
因为Fable上面还有Mythos。
Anthropic此前明确表示,Fable 5.1和Mythos 5.1使用的是同一个模型,区别主要在安全限制和开放权限:Fable可以广泛使用,Mythos则只向经过审核的机构开放,在网络安全和生命科学等高风险领域拥有更完整的能力。
所以从产品结构上看,Fable至少还给Anthropic留下了一个很有用的中间档位:Opus负责成熟、广泛部署的高端能力;Fable承接已经可以公开放出来的前沿能力;再往前,才是受限开放的Mythos。
但这个档位确实很尴尬。下面,Opus靠effort不断往上伸;上面,Mythos承接着更前沿、更受限的能力。
夹在中间的Fable,越来越像一层“缓冲垫”,两头受气。
当然,Fable怎么摆,终究还是Anthropic自己的产品线问题。
外面的OpenAI可不会等它慢慢理顺。
Opus 5.5才上桌,OpenAI立马放出了GPT-6 Sol和Luna——新一轮价格和性能战已经打起来了。
本文来自微信公众号:字母AI,作者:袁心玥